---
jupyter: decanal
---
# Introduction {.unnumbered}
::: {.callout-note appearance="simple"}
Bab ini adalah **peta jalan**. Ia tidak mengajarkan satu teknik pun secara mendalam, tetapi memberi kita kerangka berpikir yang akan dipakai di seluruh buku: apa itu *decision analytics*, bagaimana keempat tingkat analytics saling terhubung, dan mengapa urutan tersebut penting. Di akhir bab, kita akan melihat **satu contoh utuh**—dari data mentah hingga rekomendasi keputusan—dalam bentuk yang sangat disederhanakan.
:::
## Apa itu Decision Analytics?
**Decision Analytics** adalah disiplin yang menggunakan data, model, dan penalaran untuk **meningkatkan kualitas keputusan**. Kata kuncinya adalah *keputusan*, bukan *analisis*. Banyak organisasi menghasilkan laporan dan dashboard yang rapi tetapi tetap mengambil keputusan dengan perut—bukan karena analisisnya salah, melainkan karena analisisnya tidak pernah dirancang untuk berujung pada tindakan.
Tiga gagasan membedakan decision analytics dari sekadar "analisis data":
1. **Fokus pada keputusan, bukan pada data.** Pertanyaan pertama bukan "data apa yang kita punya?" melainkan "keputusan apa yang akan diambil, dan informasi apa yang dapat memperbaikinya?"
2. **Nilai datang dari tindakan, bukan dari insight.** Model yang akurat tetapi tidak pernah dipakai tidak memiliki nilai. Sebaliknya, model sederhana yang mengubah cara orang mengambil keputusan bisa bernilai besar.
3. **Data, model, dan penilaian manusia bekerja bersama.** Model memberi rekomendasi; manusia memutuskan dengan mempertimbangkan konteks, etika, dan batasan yang tidak tertangkap dalam data.
> **Definisi kerja.** *Decision Analytics adalah proses mengubah data menjadi rekomendasi tindakan yang dapat dieksekusi, dengan memperhitungkan ketidakpastian dan keterbatasan dunia nyata.*
## Tangga Analytics: Dari Data ke Keputusan
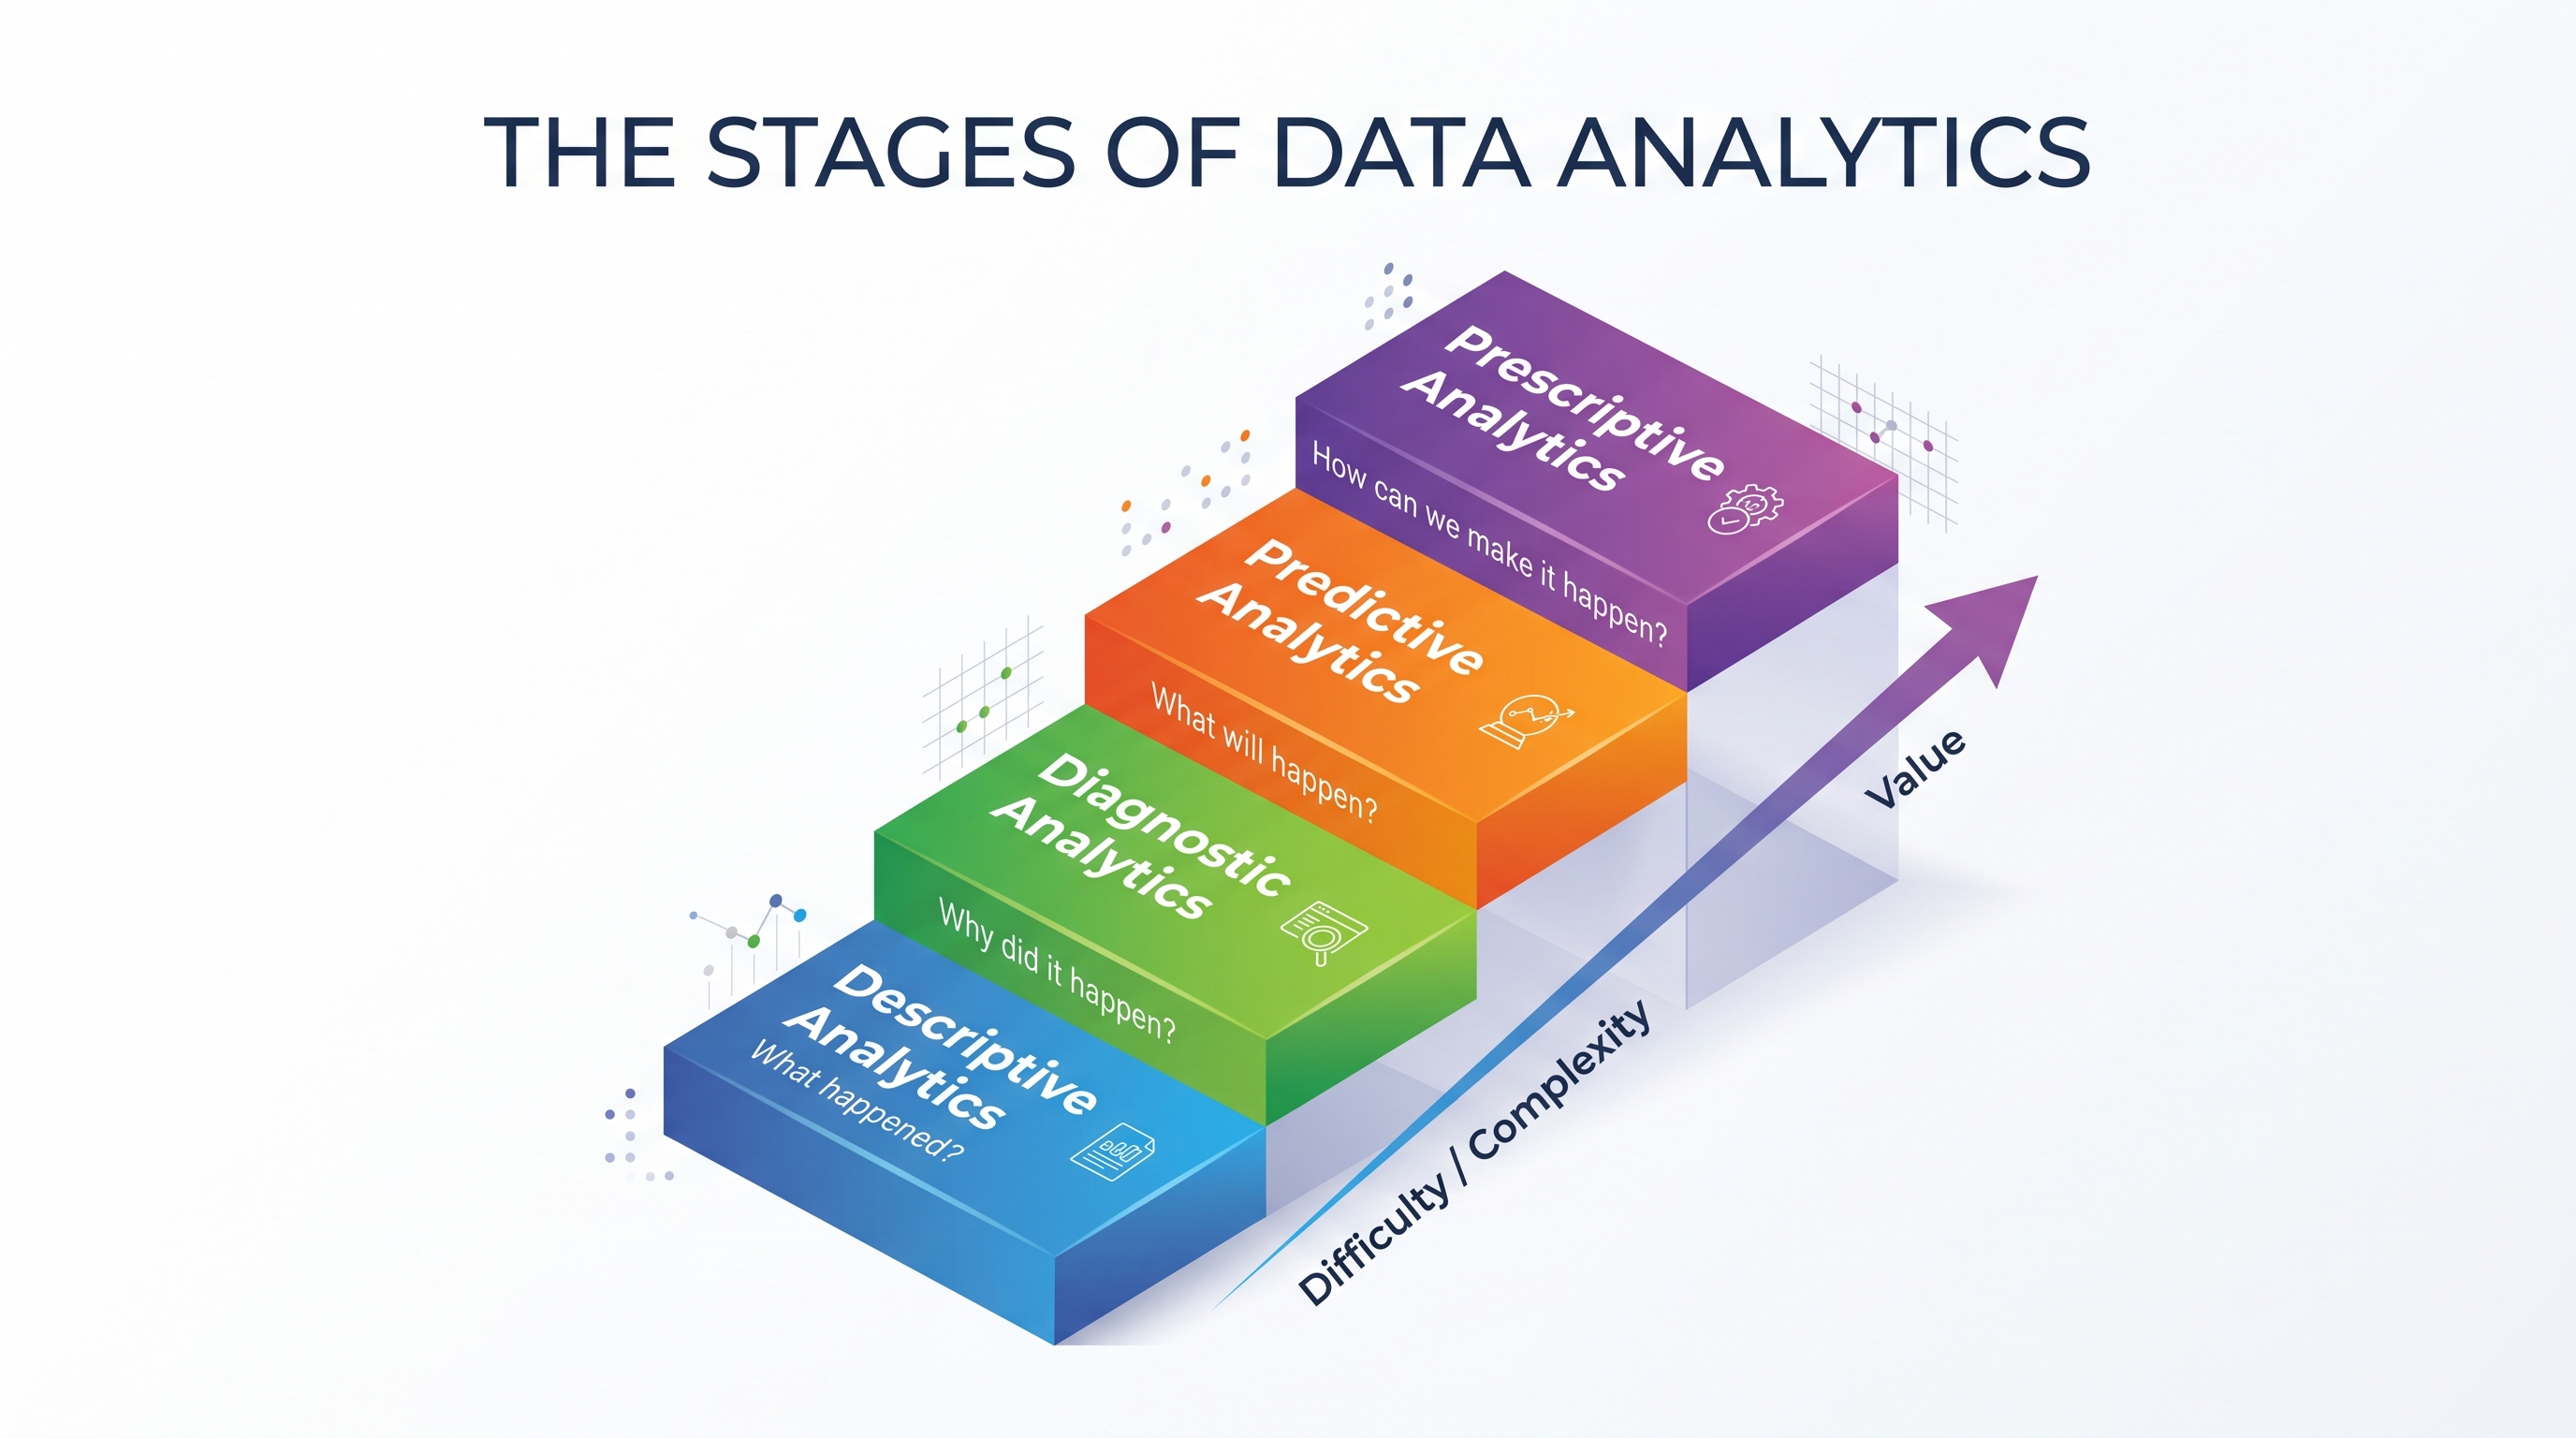
Literatur analytics biasanya membedakan empat tingkat kematangan, yang secara kolektif dikenal sebagai **tangga analytics**:
{#fig-tangga width=85%}
| Tingkat | Pertanyaan | Contoh Keluaran | Disiplin Utama |
|---|---|---|---|
| **Descriptive** | Apa yang telah terjadi? | Ringkasan penjualan bulanan, dashboard KPI | Statistika, business intelligence |
| **Diagnostic** | Mengapa hal itu terjadi? | Analisis akar masalah, segmentasi penyebab | Statistika, visual analytics |
| **Predictive** | Apa yang kemungkinan besar akan terjadi? | Forecast permintaan, skor risiko churn | Machine learning, ekonometrika |
| **Prescriptive** | Apa yang sebaiknya kita lakukan? | Jadwal optimal, alokasi anggaran, kebijakan harga | Riset operasi, simulasi, teori keputusan |
**Diagnostic** sering diperlakukan sebagai "sub-tingkat" dari descriptive, karena keduanya bekerja pada data historis. Namun secara praktik, lompatan dari *apa* ke *mengapa* membutuhkan teknik dan kebiasaan berpikir yang cukup berbeda—sehingga dalam buku ini ia mendapat porsi tersendiri di Bagian I.
::: {.callout-tip}
Tangga ini bukan hierarki nilai—setiap tingkat bernilai jika menjawab pertanyaan yang tepat. Perusahaan yang belum memiliki dashboard yang andal tidak akan banyak memperoleh manfaat dari model optimasi canggih. Sebagian besar kegagalan analytics bukan karena tekniknya terlalu sederhana, melainkan karena fondasinya belum kokoh.
:::
## Siklus Pengambilan Keputusan
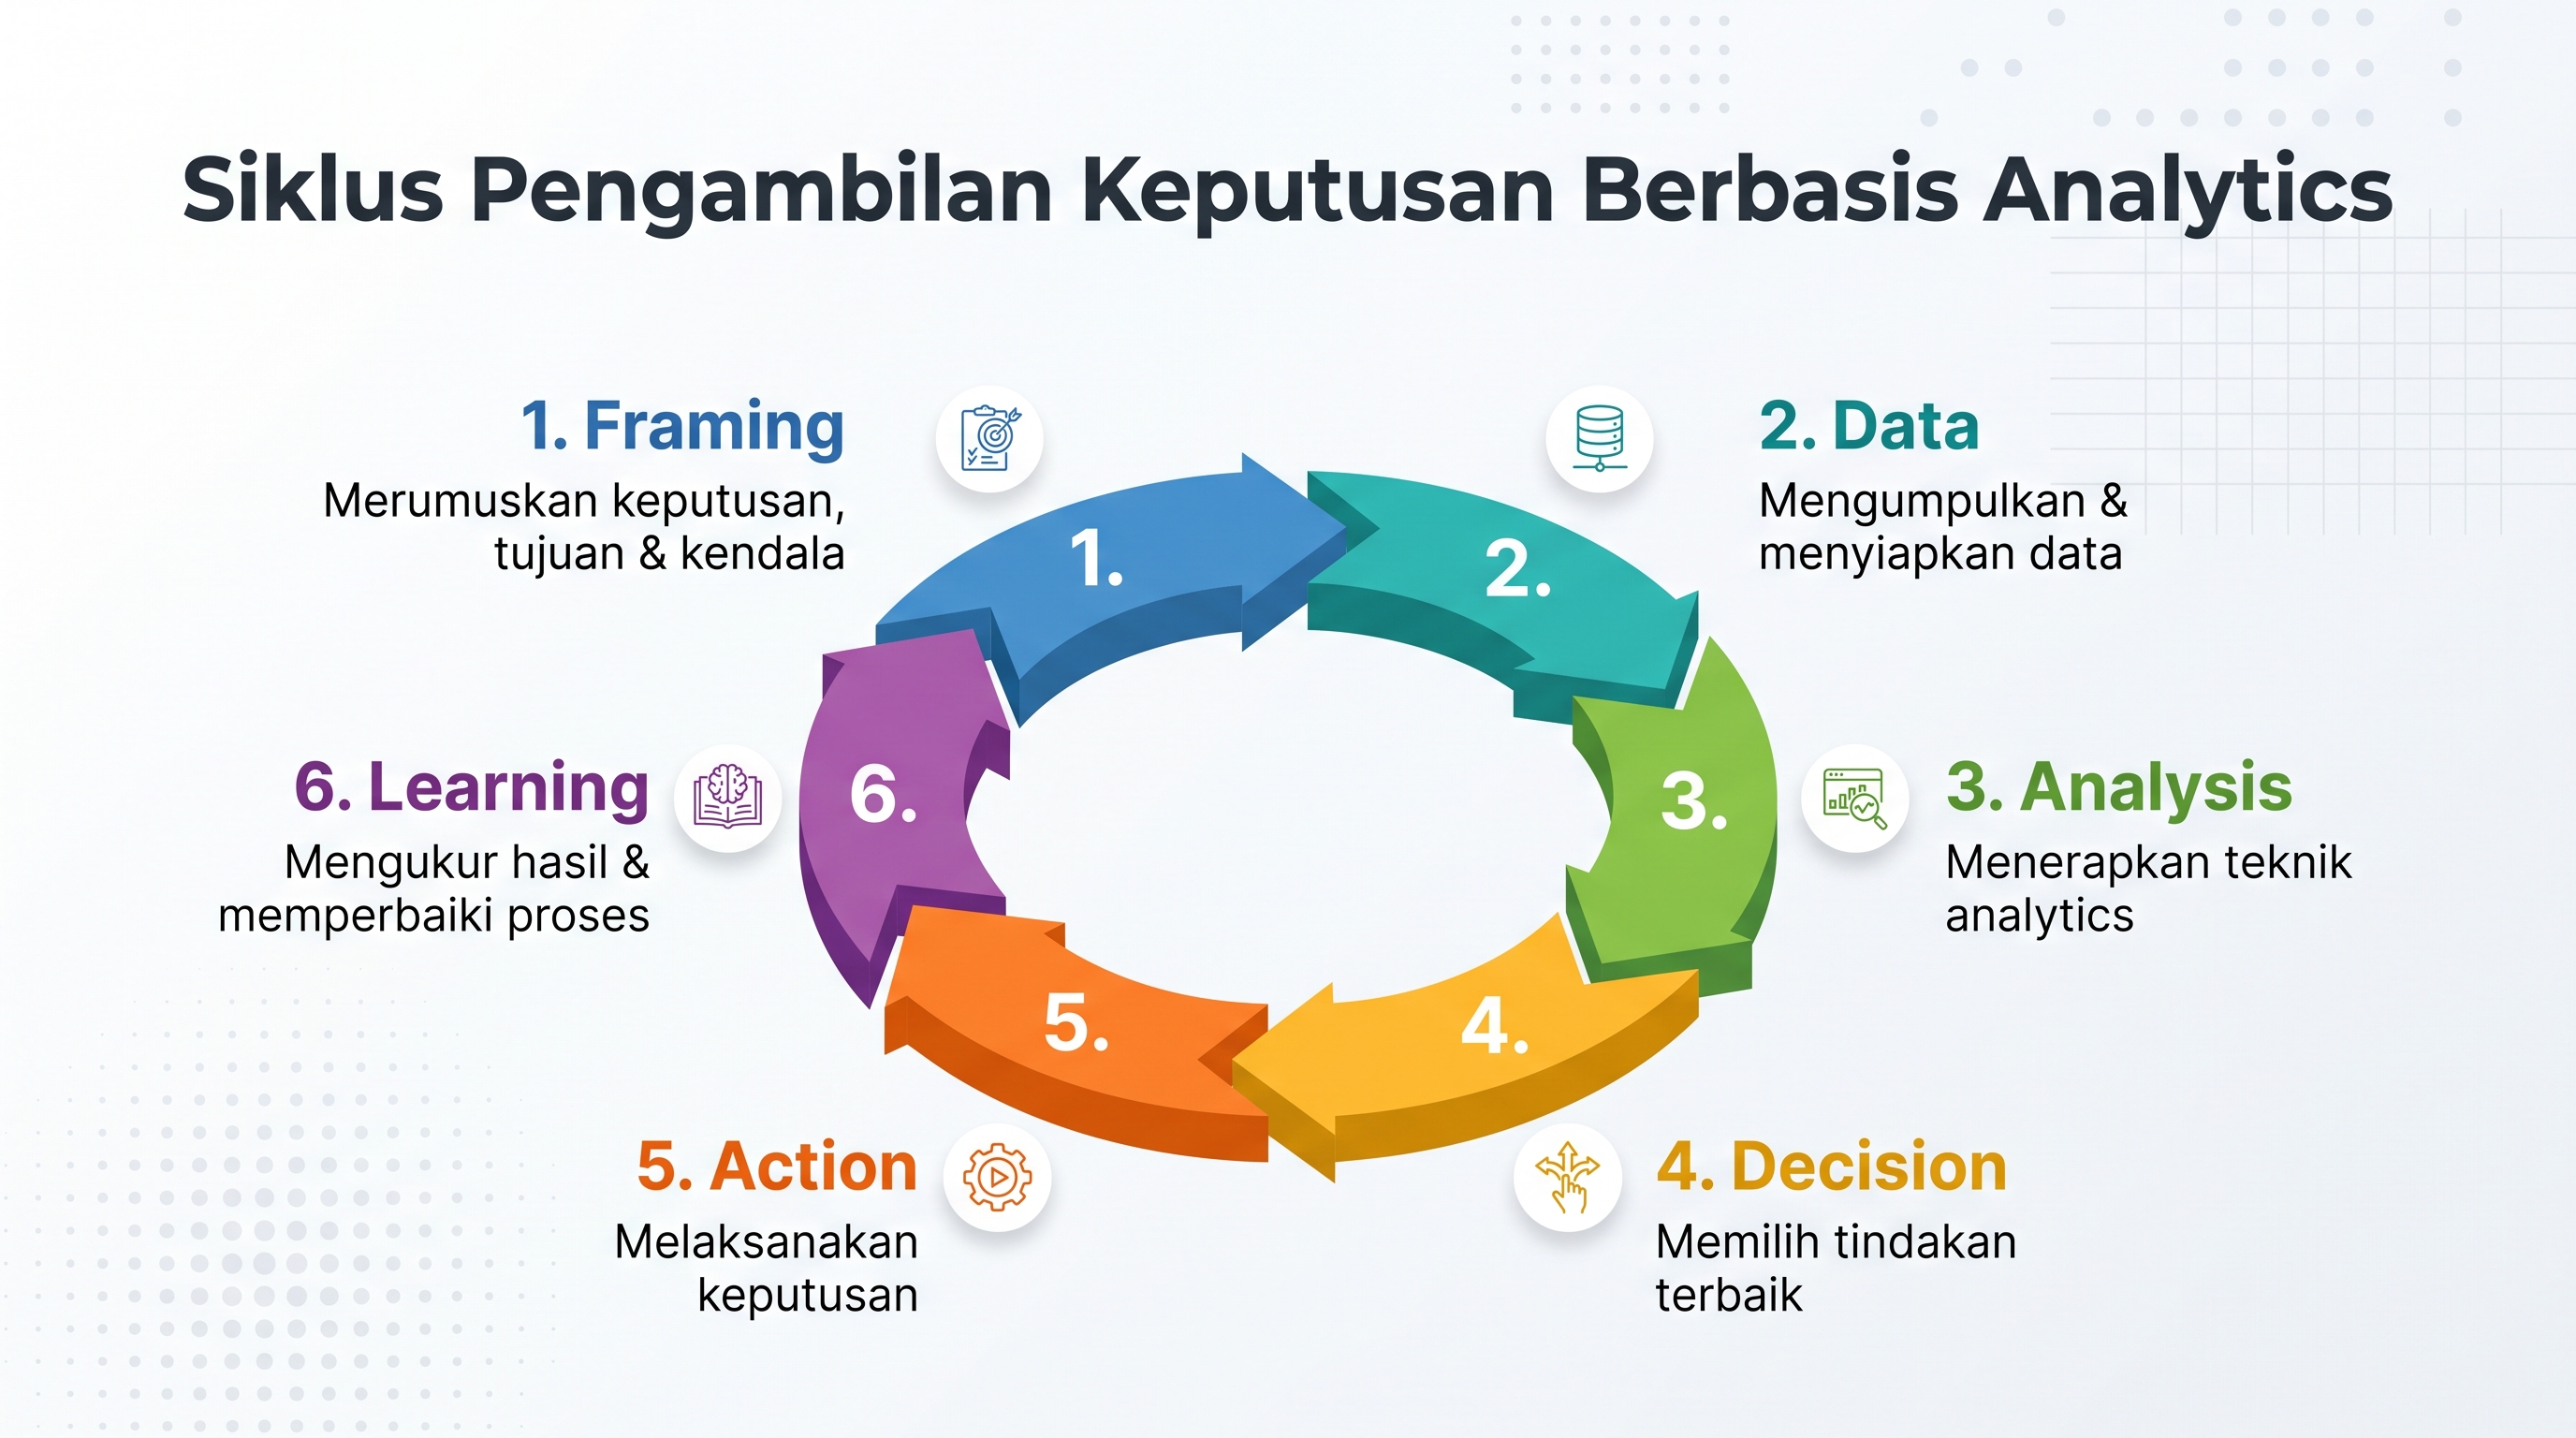
Analytics bukan kegiatan sekali jalan. Ia adalah bagian dari siklus yang berulang:
{#fig-siklus width=80%}
1. **Framing** — Merumuskan keputusan secara eksplisit: apa pilihan yang tersedia, apa tujuannya, apa kendalanya.
2. **Data** — Mengumpulkan dan menyiapkan data yang relevan dengan keputusan tersebut.
3. **Analysis** — Menerapkan teknik deskriptif, prediktif, atau preskriptif sesuai kebutuhan.
4. **Decision** — Memilih tindakan, dengan mempertimbangkan hasil analisis dan konteks manusiawi.
5. **Action** — Melaksanakan keputusan.
6. **Learning** — Mengukur hasil, membandingkan dengan ekspektasi, dan memperbaiki model maupun proses.
Banyak kegagalan analytics terjadi karena satu atau lebih tahap ini dilewati. Model prediksi yang bagus tetapi tidak pernah sampai ke **Action** hanya menghasilkan laporan. Keputusan yang diambil tanpa **Framing** yang jelas akan menghasilkan analisis yang tidak relevan.
## Sneak Peek: Satu Contoh, Empat Tingkat Analytics
Sebelum masuk ke bab-bab teknis, mari lihat bagaimana keempat tingkat analytics bekerja pada **satu kasus yang sama**. Contoh ini sangat disederhanakan—detailnya akan dibahas di bagian-bagian berikutnya—tetapi tujuannya adalah memperlihatkan bahwa keempat tingkat itu bukan empat topik terpisah, melainkan **empat lapisan dari satu percakapan yang sama**.
**Skenario.** Sebuah kedai kopi ingin memahami penjualannya dan memutuskan berapa banyak barista yang perlu dijadwalkan setiap jam.
```{python}
import numpy as np
import pandas as pd

# Membangkitkan data sintetis: penjualan per jam selama 30 hari
np.random.seed(42)
jam = pd.date_range("2025-01-01", periods=30 * 24, freq="h")
pola_harian = 20 + 10 * np.sin(np.arange(len(jam)) * 2 * np.pi / 24)
penjualan = np.maximum(0, pola_harian + np.random.normal(0, 3, len(jam)))

df = pd.DataFrame({"waktu": jam, "penjualan": penjualan})
df["jam"] = df["waktu"].dt.hour
df["hari"] = df["waktu"].dt.day_name()
```
### Tingkat 1 — Descriptive: Apa yang terjadi?
```{python}
ringkasan = df.groupby("jam")["penjualan"].mean().round(1)
print(ringkasan)
```
Keluaran ini memberi kita gambaran: pada jam berapa penjualan tinggi, pada jam berapa rendah. Ini adalah pekerjaan **descriptive analytics**—meringkas masa lalu agar dapat dipahami.
### Tingkat 2 — Diagnostic: Mengapa?
```{python}
per_hari = df.groupby("hari")["penjualan"].mean().round(1)
print(per_hari)
```
Jika kita melihat bahwa Senin pagi secara konsisten lebih rendah dari hari lain, kita bisa mulai bertanya _mengapa_—apakah karena lokasi, cuaca, kompetitor, atau karena memang pola pelanggan. Ini adalah pekerjaan **diagnostic analytics**: tidak berhenti pada "apa", tetapi mengejar "mengapa".
### Tingkat 3 — Predictive: Apa yang akan terjadi?
```{python}
# Forecast sederhana: rata-rata historis per jam sebagai prediksi
prediksi_per_jam = df.groupby("jam")["penjualan"].mean().round(1)
print(prediksi_per_jam)
```
Model prediksi yang sesungguhnya (dibahas di Bagian II) akan jauh lebih canggih—mempertimbangkan hari dalam seminggu, musim, promosi, dan sebagainya. Tetapi idenya sama: mengubah data historis menjadi **estimasi tentang masa depan**.
### Tingkat 4 — Prescriptive: Apa yang sebaiknya dilakukan?
```{python}
from pulp import LpVariable, LpMinimize, LpProblem, lpSum, LpInteger, value

# Setiap barista melayani ~5 pelanggan/jam; tambahkan margin keamanan 10%
kapasitas_per_barista = 5
margin = 1.1

barista = LpVariable.dicts("barista", range(24), lowBound=1, cat=LpInteger)
model = LpProblem("penjadwalan_barista", LpMinimize)
model += lpSum([barista[h] for h in range(24)])  # minimalkan total barista

for h in range(24):
    model += barista[h] * kapasitas_per_barista >= prediksi_per_jam.iloc[h] * margin

model.solve()

jadwal = {h: int(value(barista[h])) for h in range(24)}
print(jadwal)
```
Sekarang kita tidak lagi sekadar memprediksi—kita **merekomendasikan tindakan**: berapa barista yang harus dijadwalkan pada setiap jam agar kapasitas cukup, dengan jumlah barista seminimal mungkin. Ini adalah **prescriptive analytics**.
## Apa yang baru saja kita lihat?
Satu dataset, empat pertanyaan berbeda, empat jenis keluaran:
|**Tingkat**| **Pertanyaan**| **Output pada contoh ini**|
|---|---|---|
|Descriptive| Apa yang terjadi?| Rata-rata penjualan per jam|
|Diagnostic| Mengapa?| Perbedaan penjualan antahari|
|Predictive| Apa yang akan terjadi?| Estimasi penjualan per jam esok hari|
|Prescriptive| Apa yang sebaiknya dilakukan? |Jadwal barista yang optimal|
Dalam praktik nyata, setiap tingkat membutuhkan teknik, data, dan pertimbangan yang jauh lebih kaya. Tetapi struktur berpikirnya sama—dan itulah yang akan kita kuasai melalui buku ini.
::: {.callout-note}
Demo di atas menggunakan data sintetis agar dapat dijalankan tanpa dataset eksternal. Dataset pendamping buku ini (lihat Dataset Pendamping) akan menjadi bahan untuk versi yang jauh lebih realistis di setiap bagian.
:::
## Peta Disiplin Ilmu
Decision analytics bukan disiplin tunggal; ia adalah simpul dari beberapa tradisi intelektual yang lebih tua:
- **Statistika** memberi kita bahasa untuk mengukur ketidakpastian, menguji hipotesis, dan memisahkan sinyal dari noise.
- **Machine learning** memperluas statistika ke data berdimensi tinggi dan pola non-linear yang sulit dinyatakan dalam model klasik.
- **Riset operasi (operations research)** memberi kita alat untuk mengoptimalkan—merumuskan keputusan sebagai masalah matematis dengan tujuan dan kendala.
- **Business intelligence** dan **visual analytics** menyediakan jembatan antara model dan pengambil keputusan manusia.
- **Ekonometrika** dan **ilmu keputusan (_decision science_)** mengingatkan kita bahwa keputusan selalu tertanam dalam konteks kausal dan organisasional.
Buku ini tidak berusaha menggantikan pelatihan mendalam di masing-masing disiplin. Ia berusaha menyusun mereka dalam satu alur kerja yang koheren.
## Nilai: Dari Insight ke Impact
Salah satu temuan paling konsisten dalam literatur analytics adalah bahwa **sebagian besar nilai hilang di "last mile"**—bukan karena modelnya salah, melainkan karena rekomendasinya tidak pernah sampai ke pengambil keputusan, atau sampai tetapi tidak dipercaya.
Tiga penghalang yang paling umum:
1. **Relevansi.** Analisis menjawab pertanyaan yang bukan pertanyaan pengambil keputusan.
2. **Kepercayaan.** Model dianggap kotak hitam; pengambil keputusan tidak dapat memeriksa asumsinya.
3. **Kelayakan.** Rekomendasi dianggap tidak dapat dieksekusi mengingat kendala nyata (anggaran, kebijakan, budaya).
Karena itu, di setiap bab Bagian II dan III kita akan menemukan **kotak "Jembatan"**—kotak yang secara eksplisit menanyakan: _jika hasil ini benar, keputusan apa yang akan berubah, dan siapa yang harus meyakinkannya?_
## Dataset Pendamping
Seluruh buku menggunakan **satu atau lebih dataset pendamping**—yang relevan dengan subyek yang sedang dibahas. Dataset ini dipilih karena ia dapat dianalisis pada keempat tingkat analytics tanpa kehilangan koherensi.
|Tingkat| Pertanyaan yang akan kita ajukan pada dataset pendamping|
|---|---|
|Descriptive| Bagaimana pola pelanggan, produk, atau transaksi saat ini?|
|Diagnostic| Mengapa pola ini muncul? Segmen mana yang paling berbeda?|
|Predictive| Pelanggan mana yang berisiko tinggi, produk mana yang akan laris?|
|Prescriptive| Retensi, alokasi stok, atau intervensi apa yang optimal?|
Dengan menggunakan satu atau lebih dataset yg konsisten dari awal sampai akhir, kita akan melihat bagaimana **pertanyaan yang berbeda menghasilkan analisis yang berbeda, bahkan ketika datanya sama**.
## Tiga Bagian Buku Ini
{#fig-alur width=85%}
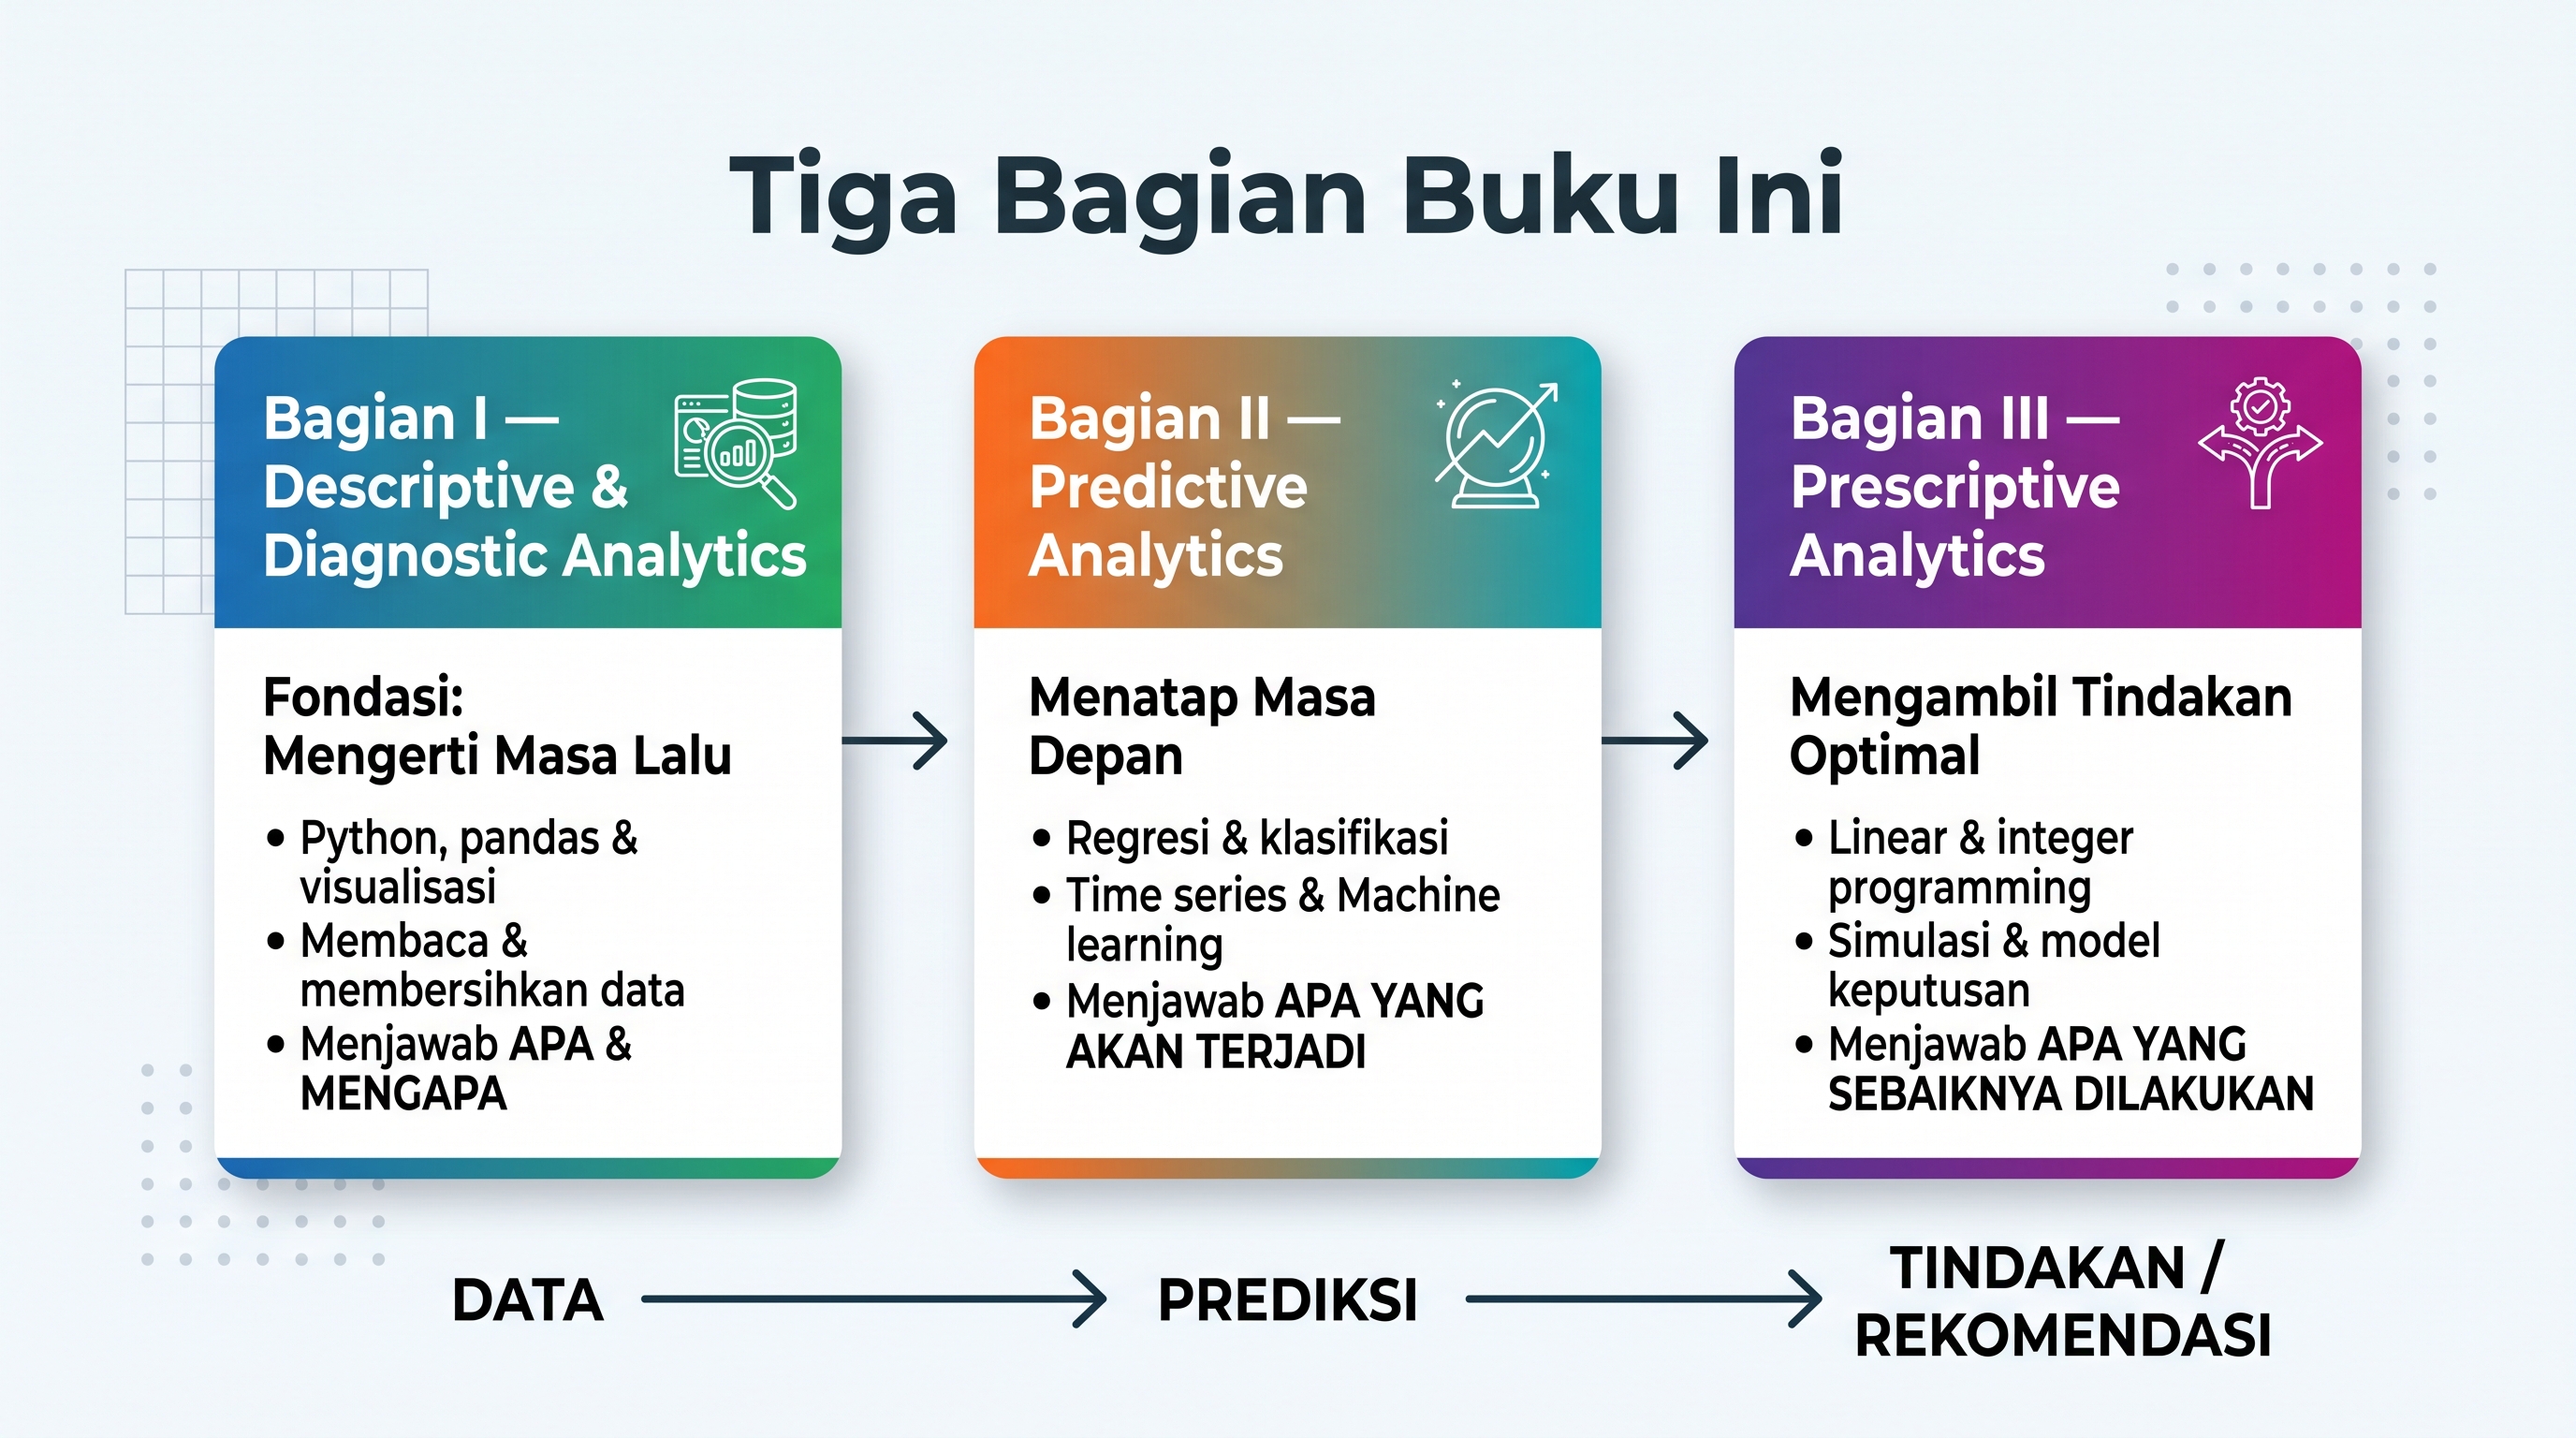
**Bagian I — Descriptive & Diagnostic Analytics.**
Fondasi: cara membaca, membersihkan, dan memahami data. kita akan berkenalan dengan Python, pandas, visualisasi, dan alat diagnostik. Bagian ini menjawab _**apa dan mengapa**_.
**Bagian II — Predictive Analytics.**
Cara memodelkan hubungan antarvariabel dan memprediksi masa depan. kita akan mempelajari regresi, klasifikasi, time series, unsupervised learning, dan simulasi Monte Carlo sebagai jembatan ke Bagian III. Bagian ini menjawab **_apa yang akan terjadi_**.
**Bagian III — Prescriptive Analytics.**
Puncak perjalanan: mengambil keputusan optimal di bawah ketidakpastian dan keterbatasan. kita akan mempelajari linear programming, integer programming, optimasi jaringan, simulasi keputusan, dan integrasi prediksi ke dalam model optimasi. Bagian ini menjawab **_apa yang sebaiknya dilakukan_**.
**Bagaimana ketiganya terhubung.** Bagian I menyiapkan data; Bagian II mengubahnya menjadi prediksi; Bagian III mengubah prediksi menjadi rekomendasi tindakan. kita tidak dapat melompat ke Bagian III tanpa fondasi Bagian I dan II—bukan karena aturan akademis, tetapi karena keputusan yang baik membutuhkan prediksi yang baik, dan prediksi yang baik membutuhkan data yang dipahami dengan baik.
## Kosakata Kunci
Sepanjang buku, beberapa istilah akan muncul berulang kali. Berikut versi ringkas yang akan diperluas di bab-bab selanjutnya.
::: {.callout-note appearance="simple"}
**Analytics** — Proses mengubah data menjadi insight dan insight menjadi tindakan. Mencakup keempat tingkat pada [@fig-tangga].
**Model** — Representasi matematis atau komputasional dari sebagian dunia nyata, dirancang untuk tujuan tertentu.
**Fitur (feature)** — Variabel masukan dalam sebuah model prediktif. Disebut juga prediktor atau variabel independen.
**Overfitting** — Kondisi ketika model terlalu menyesuaikan diri pada data latih sehingga buruk dalam memprediksi data baru.
**Fungsi tujuan (objective function)** — Kuantitas yang ingin dimaksimalkan atau diminimalkan dalam model optimasi.
**Kendala (constraint)** — Batasan yang harus dipenuhi solusi dalam model optimasi.
**Ketidakpastian (uncertainty)** — Keadaan ketika hasil dari suatu tindakan tidak dapat diketahui dengan pasti; ditangani melalui probabilitas dan simulasi.
:::
Glosarium lengkap tersedia di bagian akhir buku.
## Cara Membaca Buku Ini
Buku ini dirancang agar dapat dipakai dengan beberapa cara berbeda:
- **Pembelajar mandiri** sebaiknya membaca berurutan dari Bagian I, mengerjakan latihan di setiap bab sebelum melanjutkan. Kode dapat dijalankan langsung dari notebook.
- **Pengajar** dapat memetakan Bagian I–III langsung ke tiga course. Materi slide tersedia di folder slides/ pada repositori pendamping.
- **Praktisi** yang ingin fokus pada satu topik dapat masuk langsung ke bab yang relevan, tetapi Bab 2 tetap disarankan sebagai titik masuk karena ia memperkenalkan konvensi dan dataset pendamping.
- **Pembaca yang ingin gambaran cepat** dapat membaca bab ini, lalu melompat ke bab rangkuman setiap bagian sebelum memutuskan di mana masuk lebih dalam.
::: {.callout-tip}
Jika kita mengajar dengan buku ini, gunakan demo sneak peek di atas sebagai kelas pembuka. Ia memberi mahasiswa gambaran utuh sebelum masuk ke detail teknis—dan menjadi jangkar yang bisa dirujuk balik setiap kali mereka merasa tersesat di tengah detail bab.
:::
## Rangkuman dan Jembatan ke Bagian I
Dalam bab ini kita telah menetapkan:
- **Decision analytics** berfokus pada keputusan, bukan pada data.
- Empat tingkat analytics—**descriptive, diagnostic, predictive, prescriptive**—membentuk satu tangga yang saling bergantung.
- Analytics adalah bagian dari **siklus pengambilan keputusan** yang berulang, bukan aktivitas sekali jalan.
- Nilai analytics sering hilang di **last mile**; karena itu buku ini secara eksplisit menghubungkan setiap analisis ke keputusan.
- Buku ini disusun dalam **tiga bagian** dengan **satu dataset pendamping** dan **satu bahasa (Python)**.
Bab berikutnya, **Fondasi Decision Analytics**, akan mulai membangun fondasi teknis: menyiapkan lingkungan Python, memahami struktur data, dan memperkenalkan dataset pendamping yang akan menemani kita sampai akhir buku. Jika kita baru mengenal Python, bab itu juga menyediakan jalur percepatan singkat agar kita dapat mengikuti bab-bab selanjutnya tanpa hambatan.


