---
jupyter: decanal
---
# Statistik Deskriptif & Eksplorasi Data {#sec-statistik}
::: {.callout-note appearance="simple"}
**Tujuan pembelajaran.** Setelah menyelesaikan bab ini, kita akan mampu:
1. Memilih ukuran pusat dan sebaran yang tepat untuk setiap jenis distribusi.
2. Membaca bentuk distribusi (kemencengan, ekor) dan memahami implikasinya bagi analisis selanjutnya.
3. Melakukan eksplorasi univariat dan bivariat secara sistematis.
4. Menguji secara statistik apakah perbedaan antar kelompok bermakna atau hanya kebetulan.
5. Melaporkan besaran efek (*effect size*), bukan hanya nilai *p*.
6. Memahami probabilitas sebagai jembatan dari deskriptif ke prediktif.
:::
## Dari Data ke Pertanyaan
Dataset yang kita miliki di Bab 2 sudah bersih. Tetapi data bersih bukanlah pengetahuan. Bab ini adalah tentang **mengajukan pertanyaan kepada data**—dan menjawabnya dengan angka yang dapat diinterpretasikan.
Kita akan memulai dari statistik paling sederhana (rata-rata), lalu bergerak menuju pertanyaan yang lebih menarik: **Apakah pelanggan yang churn berbeda secara sistematis dari yang bertahan?** Jika ya, dalam hal apa? Seberapa besar perbedaannya? Dan apakah perbedaan itu signifikan secara statistik, atau hanya kebetulan?
::: {.callout-tip}
**Statistik deskriptif bukan sekadar "meringkas".** Ia adalah **bahasa untuk mengajukan pertanyaan**. Setiap ukuran yang kita pilih—rata-rata vs. median, standar deviasi vs. IQR—mengandung asumsi tentang data dan mengarahkan kita pada jenis kesimpulan tertentu. Bab ini mengajarkan kita memilih dengan sadar.
:::
## Memuat Dataset Bersih
Kita mulai dari titik di mana Bab 2 berhenti:
```{python}
#| label: load-clean
import sys
sys.path.insert(0, ".")
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns

from decanal.utils import load_churn_clean

df = load_churn_clean()
print(f"Bentuk: {df.shape[0]:,} baris × {df.shape[1]} kolom")
```
Kita juga perlu menghitung **churn rate**—metrik paling fundamental dalam dataset ini—sebagai jangkar untuk seluruh bab:
```{python}
#| label: churn-rate
n_total = len(df)
n_churn = (df["Churn"] == "Yes").sum()
churn_rate = n_churn / n_total

print(f"Total pelanggan : {n_total:,}")
print(f"Churn           : {n_churn:,}")
print(f"Churn rate      : {churn_rate:.2%}")
```
**Sekitar 1 dari 4 pelanggan churn.** Angka ini akan menjadi referensi di seluruh bab: setiap kali kita membandingkan kelompok, kita akan bertanya "apakah kelompok ini churn lebih sering atau lebih jarang dari 26,5%?"
## Ukuran Pusat: Tiga Cara Menjawab "Berapa Rata-rata?"
Ada tiga ukuran pusat yang perlu kita kuasai, dan memilih salah satunya bukan sekadar preferensi—ia mengandung asumsi tentang distribusi dan tujuan analisis.
| Ukuran | Kapan tepat dipakai | Kapan menyesatkan |
|---|---|---|
| **Mean** (rata-rata) | Distribusi simetris, tidak ada outlier ekstrem | Distribusi miring (mis. pendapatan, tagihan) |
| **Median** (nilai tengah) | Distribusi miring, ada outlier | Data kategorikal, distribusi multimodal |
| **Mode** (nilai tersering) | Data kategorikal, deteksi pola | Data kontinu (hampir tidak pernah berulang) |
Mari kita lihat ketiganya pada tiga kolom numerik utama:
```{python}
#| label: central-tendency
numeric_cols = ["tenure", "MonthlyCharges", "TotalCharges"]

ringkasan = pd.DataFrame({
    "mean":   [df[c].mean()   for c in numeric_cols],
    "median": [df[c].median() for c in numeric_cols],
    "mode":   [df[c].mode().iloc[0] for c in numeric_cols],
    "selisih (mean - median)": [
        df[c].mean() - df[c].median() for c in numeric_cols
    ],
}, index=numeric_cols).round(2)

ringkasan
```
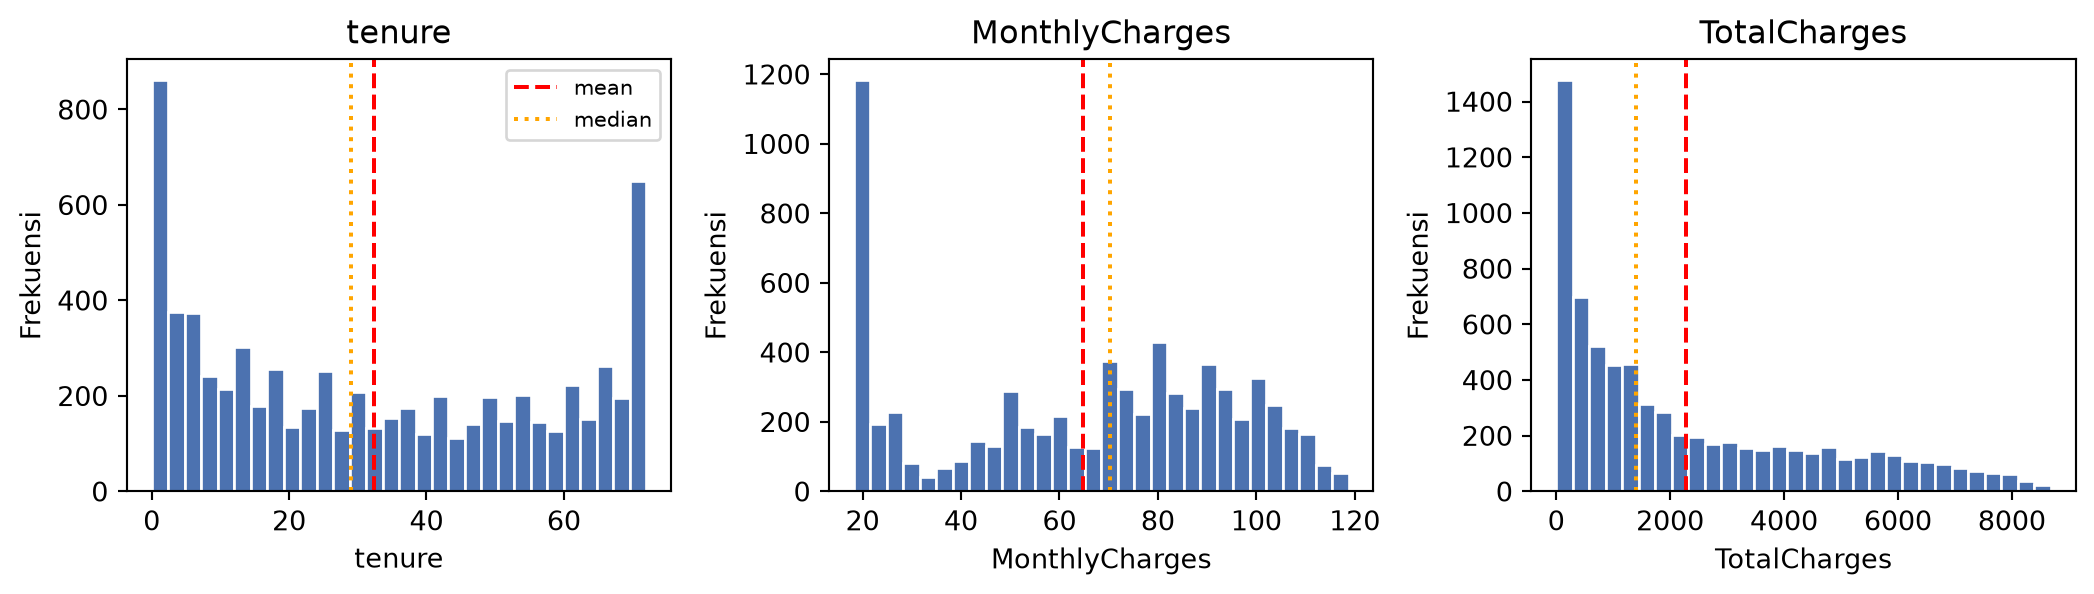
**Cara membaca tabel ini.** Jika `mean ≈ median`, distribusinya kurang lebih simetris. Jika `mean > median`, distribusinya **miring ke kanan** (*right-skewed*): ada beberapa nilai sangat tinggi yang menarik rata-rata ke atas. Jika `mean < median`, distribusinya miring ke kiri.
Perhatikan `TotalCharges`: `mean` jauh lebih besar dari `median`. Ini adalah pola klasik distribusi miring kanan—beberapa pelanggan dengan `tenure` panjang dan tagihan bulanan tinggi menghasilkan `TotalCharges` yang sangat besar, sementara sebagian besar pelanggan memiliki total yang lebih kecil.
::: {.callout-important}
**Mengapa ini penting untuk keputusan?** Jika kita melaporkan "rata-rata pelanggan menghabiskan Rp X", kita mengasumsikan **setiap pelanggan** berbelanja di sekitar angka itu. Kenyataannya, sebagian besar pelanggan berbelanja lebih sedikit dari rata-rata—mean ditarik oleh minoritas pelanggan bernilai tinggi. Untuk keputusan pricing, **median lebih jujur**; untuk keputusan alokasi anggaran (di mana total yang penting, bukan rata-rata per pelanggan), **mean tetap relevan**.
:::
## Ukuran Sebaran: Seberapa Lebar Data Tersebar?
Ukuran pusat saja menyesatkan tanpa sebaran. Dua kelompok bisa memiliki rata-rata yang sama tetapi sangat berbeda dalam keragaman—dan keragaman itu sendiri adalah informasi.
| Ukuran | Rentang nilai | Kelebihan | Kekurangan |
|---|---|---|---|
| **Range** | `[min, max]` | Sederhana, langsung terlihat | Sangat dipengaruhi outlier |
| **Varians** | ≥ 0 | Fondasi matematis | Satuannya kuadrat—sulit diinterpretasikan |
| **Std. deviasi** | ≥ 0 | Satuannya sama dengan data | Sensitif terhadap outlier |
| **IQR** (Q3 − Q1) | ≥ 0 | Tahan terhadap outlier | Tidak menggunakan semua titik data |
| **Coefficient of Variation** | ≥ 0 | Memungkinkan perbandingan antar skala | Tidak bermakna jika mean ≈ 0 |
```{python}
#| label: spread
sebaran = pd.DataFrame({
    "std":  [df[c].std() for c in numeric_cols],
    "min":  [df[c].min() for c in numeric_cols],
    "Q1":   [df[c].quantile(0.25) for c in numeric_cols],
    "Q3":   [df[c].quantile(0.75) for c in numeric_cols],
    "IQR":  [df[c].quantile(0.75) - df[c].quantile(0.25) for c in numeric_cols],
    "max":  [df[c].max() for c in numeric_cols],
}, index=numeric_cols).round(2)

sebaran["CV (%)"] = (
    df[numeric_cols].std() / df[numeric_cols].mean() * 100
).round(2)

sebaran
```
**Coefficient of Variation (CV)** memungkinkan kita membandingkan keragaman antar variabel dengan satuan berbeda. `MonthlyCharges` dan `TotalCharges` tidak bisa dibandingkan dengan std deviasi mentah (satuannya berbeda), tetapi CV-nya bisa: nilai CV yang lebih tinggi berarti variabel tersebut **lebih bervariasi secara relatif** terhadap rata-ratanya.
## Bentuk Distribusi: Kemencengan dan Ekor
Dua angka menangkap "bentuk" distribusi:
- **Skewness** (kemencengan): 0 = simetris; > 0 = miring kanan; < 0 = miring kiri.
- **Kurtosis** (keruncingan): 0 = normal; > 0 = ekor gemuk (banyak outlier); < 0 = ekor tipis.
```{python}
#| label: shape
from scipy import stats

bentuk = pd.DataFrame({
    "skewness": [stats.skew(df[c]) for c in numeric_cols],
    "kurtosis": [stats.kurtosis(df[c]) for c in numeric_cols],
}, index=numeric_cols).round(3)

bentuk
```
```{python}
#| label: fig-distributions
#| fig-cap: "Distribusi tiga kolom numerik utama. Perhatikan bentuk miring kanan pada TotalCharges."
#| fig-width: 10
#| fig-height: 3.2
fig, axes = plt.subplots(1, 3, figsize=(11, 3.2))
for ax, col in zip(axes, numeric_cols):
    ax.hist(df[col], bins=30, color="#4C72B0", edgecolor="white")
    ax.axvline(df[col].mean(), color="red", linestyle="--", label=f"mean")
    ax.axvline(df[col].median(), color="orange", linestyle=":", label="median")
    ax.set_title(col)
    ax.set_xlabel(col)
    ax.set_ylabel("Frekuensi")
axes[0].legend(fontsize=8)
plt.tight_layout()
plt.show()
```
::: {.callout-note}
**Implikasi untuk Bagian II.** Distribusi `TotalCharges` yang miring kanan akan menjadi perhatian ketika kita membangun model regresi di Bab 8. Model regresi linear mengasumsikan residual yang mendekati normal—dan distribusi yang miring parah sering melanggar asumsi ini. Salah satu solusinya adalah **transformasi logaritmik** (`np.log1p`), yang akan kita uji di Bab 8. Bab ini hanya menandai bahwa transformasi itu **mungkin diperlukan**; keputusan akhirnya diambil setelah kita melihat residual model.
:::
## Eksplorasi Univariat: Variabel Kategorikal
Untuk variabel kategorikal, ukuran pusat dan sebaran tidak berlaku sama. Yang lebih informatif adalah **distribusi frekuensi** dan **proporsi**.
```{python}
#| label: categorical-summary
cat_cols = ["gender", "SeniorCitizen", "Partner", "Dependents",
            "Contract", "PaymentMethod", "InternetService"]

for col in cat_cols:
    vc = df[col].value_counts(normalize=True).mul(100).round(1)
    print(f"\n--- {col} ---")
    print(vc.to_string())
```
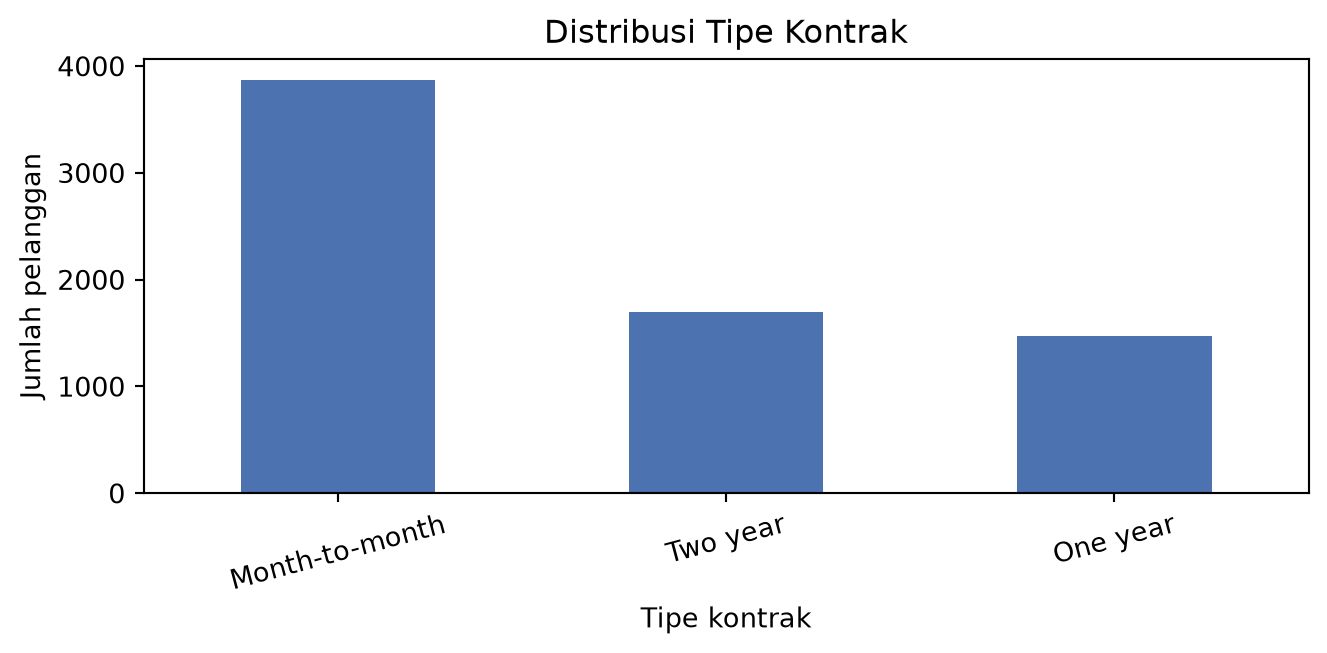
Sekilas, sebagian besar variabel kategorikal di dataset ini terdistribusi cukup seimbang. Tetapi ada satu yang mencolok: **`Contract`**—pelanggan bulanan (`Month-to-month`) mendominasi. Ini bukan kebetulan; ini adalah salah satu prediktor churn terkuat, dan kita akan melihatnya di bagian bivariat.
```{python}
#| label: fig-contract-dist
#| fig-cap: "Distribusi tipe kontrak. Kontrak bulanan mendominasi dataset."
#| fig-width: 7
#| fig-height: 3.5
fig, ax = plt.subplots(figsize=(7, 3.5))
df["Contract"].value_counts().plot(kind="bar", ax=ax, color="#4C72B0")
ax.set_title("Distribusi Tipe Kontrak")
ax.set_xlabel("Tipe kontrak")
ax.set_ylabel("Jumlah pelanggan")
ax.set_xticklabels(ax.get_xticklabels(), rotation=15)
plt.tight_layout()
plt.show()
```
## Eksplorasi Bivariat: Apakah Churn Berbeda Antar Kelompok?
Sekarang kita masuk ke bagian yang paling substantif: **membandingkan kelompok**. Pertanyaan kita adalah:
> *"Apakah pelanggan yang churn berbeda secara sistematis dari yang bertahan?"*
Kita akan memeriksa dua jenis pasangan: **kategorikal × target** dan **numerik × target**.
### Kategorikal × Target: Cross-Tabulation
```{python}
#| label: churn-by-contract
ct = pd.crosstab(df["Contract"], df["Churn"], normalize="index").mul(100).round(1)
ct.columns.name = "Churn (%)"
ct
```
**Cara membaca.** Setiap baris berjumlah 100%. Angka di kolom `Yes` adalah churn rate **di dalam** kelompok tersebut. Pelanggan dengan kontrak bulanan churn jauh lebih sering daripada pelanggan dengan kontrak dua tahun. Perbedaan ini tidak kecil—ini adalah **sinyal paling kuat** di dataset ini.
Mari kita bandingkan beberapa variabel kategorikal secara bersamaan:
```{python}
#| label: churn-by-categorical
ringkasan_kategori = []
for col in ["Contract", "InternetService", "PaymentMethod", "Partner", "Dependents"]:
    churn_by_group = df.groupby(col)["Churn"].apply(
        lambda s: (s == "Yes").mean() * 100
    ).round(1)
    for group, rate in churn_by_group.items():
        ringkasan_kategori.append({
            "variabel": col,
            "kelompok": group,
            "churn_rate (%)": rate,
        })

pd.DataFrame(ringkasan_kategori).pivot(
    index="variabel", columns="kelompok", values="churn_rate (%)"
).round(1)
```
::: {.callout-tip}
**Pola berpikir.** Ketika kita melihat churn rate yang sangat berbeda antar kelompok, ada tiga kemungkinan yang perlu dipertimbangkan:
1. **Kausalitas langsung** — jenis kontrak *menyebabkan* churn lebih tinggi.
2. **Kebalikan kausalitas** — pelanggan yang *ingin* churn sengaja memilih kontrak bulanan (mereka tidak mau terikat).
3. **Variabel perancu** — pelanggan baru cenderung memilih kontrak bulanan *dan* juga cenderung churn karena belum berkomitmen.
Kita tidak dapat membedakan ketiganya hanya dari tabel ini. Itu akan membutuhkan desain eksperimen atau analisis kausal—di luar cakupan buku ini. Tetapi menyadari bahwa **perbedaan bukan berarti sebab-akibat** adalah salah satu kebiasaan berpikir terpenting dalam analisis data.
:::
### Numerik × Target: Grouped Comparison
Untuk variabel numerik, kita bandingkan distribusi antara dua kelompok churn:
```{python}
#| label: numeric-by-churn
perbandingan = df.groupby("Churn")[numeric_cols].agg(["mean", "median", "std"]).round(2)
perbandingan
```
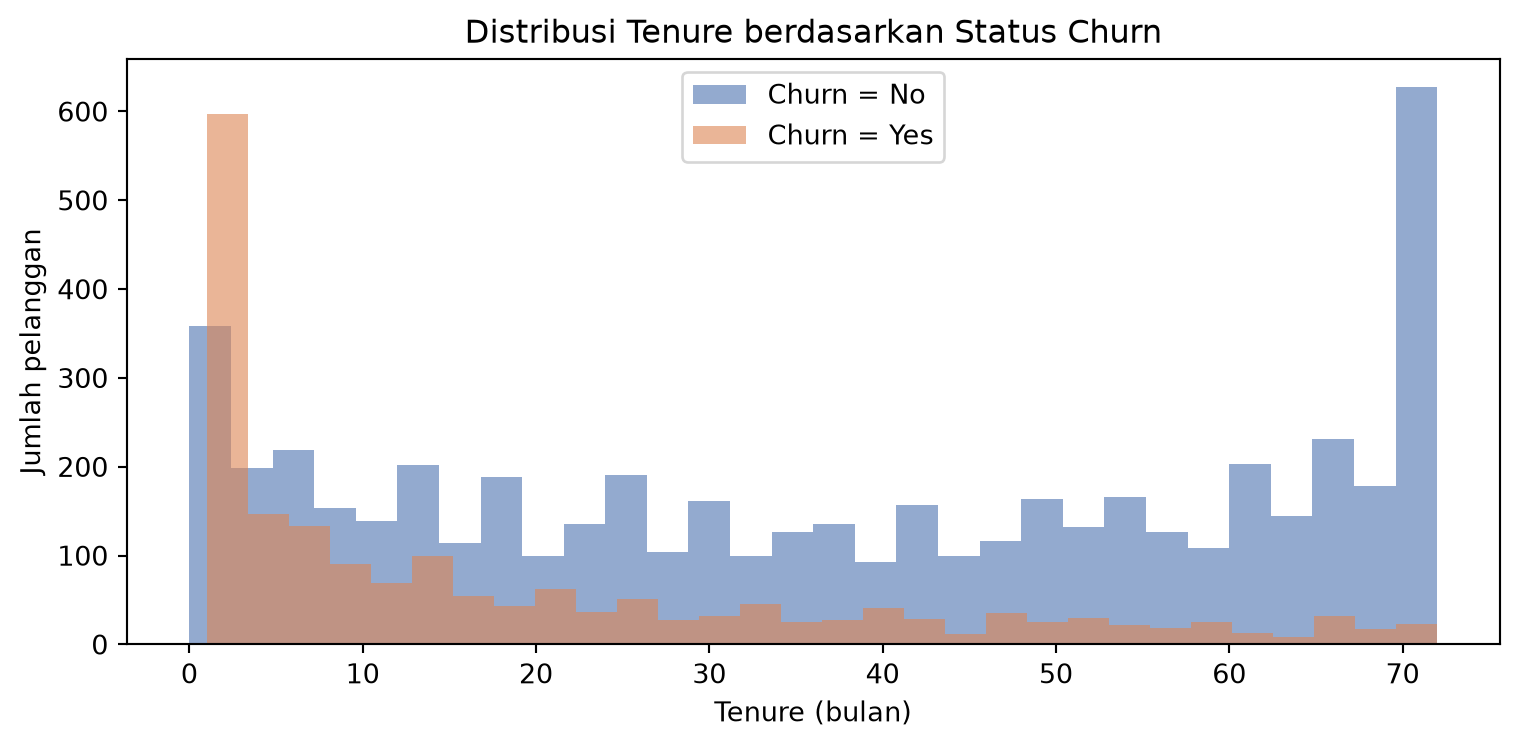
Perhatikan `tenure`: pelanggan yang churn memiliki **rata-rata tenure jauh lebih pendek** daripada yang bertahan. Ini konsisten dengan intuisi: pelanggan baru lebih mungkin berhenti daripada pelanggan lama. Tetapi ada **aspek yang lebih halus**: perbedaan ini juga konsisten dengan hipotesis bahwa **intervensi retensi paling efektif dilakukan pada awal siklus hidup pelanggan**.
```{python}
#| label: fig-tenure-churn
#| fig-cap: "Distribusi tenure berdasarkan status churn. Pelanggan churn terkonsentrasi di tenure pendek."
#| fig-width: 8
#| fig-height: 4
fig, ax = plt.subplots(figsize=(8, 4))
for label, color in [("No", "#4C72B0"), ("Yes", "#DD8452")]:
    subset = df[df["Churn"] == label]["tenure"]
    ax.hist(subset, bins=30, alpha=0.6, label=f"Churn = {label}", color=color)
ax.set_title("Distribusi Tenure berdasarkan Status Churn")
ax.set_xlabel("Tenure (bulan)")
ax.set_ylabel("Jumlah pelanggan")
ax.legend()
plt.tight_layout()
plt.show()
```
## Uji Statistik: Apakah Perbedaan Ini Nyata?
Sebuah perbedaan yang terlihat di data sampel belum tentu mencerminkan perbedaan yang sesungguhnya di populasi. **Uji hipotesis** membantu kita memutuskan apakah perbedaan yang kita amati cukup besar untuk tidak dijelaskan oleh kebetulan statistik.
### Kerangka Uji Hipotesis
1. **H₀ (hipotesis nol)**: tidak ada perbedaan antara kelompok.
2. **H₁ (hipotesis alternatif)**: ada perbedaan.
3. Hitung **statistik uji** yang mengukur seberapa jauh data dari H₀.
4. Bandingkan dengan distribusi teoretis untuk mendapatkan **p-value**.
5. Tolak H₀ jika p-value < α (biasanya 0,05).
::: {.callout-warning}
**p-value bukan probabilitas bahwa H₀ benar.** Ia adalah probabilitas **mengamati data seperti ini** (atau lebih ekstrem) **jika H₀ benar**. Ini adalah salah satu kesalahpahaman paling umum dalam statistika. Menolak H₀ tidak berarti "membuktikan H₁"; ia hanya berarti "data tidak konsisten dengan H₀".
:::
### Uji Chi-Square untuk Kategorikal
Chi-square menguji apakah dua variabel kategorikal **independen** satu sama lain.
```{python}
#| label: chi-square
from scipy.stats import chi2_contingency

for col in ["Contract", "InternetService", "PaymentMethod", "Partner"]:
    ct = pd.crosstab(df[col], df["Churn"])
    chi2, p, dof, _ = chi2_contingency(ct)
    print(f"{col:16s}: chi² = {chi2:8.2f}, p = {p:.2e}")
```
Semua nilai p sangat kecil—jauh di bawah 0,05. Artinya, kita **menolak H₀** untuk setiap variabel: tidak ada variabel ini yang independen dari `Churn`. Tetapi, seperti yang akan kita lihat sebentar lagi, **nilai p kecil bukan berarti efek besar**.
### Uji-t untuk Numerik
Uji-t membandingkan rata-rata dua kelompok.
```{python}
#| label: t-test
from scipy.stats import ttest_ind, mannwhitneyu

for col in numeric_cols:
    grup_no = df[df["Churn"] == "No"][col]
    grup_yes = df[df["Churn"] == "Yes"][col]

    t, p_t = ttest_ind(grup_no, grup_yes, equal_var=False)
    u, p_u = mannwhitneyu(grup_no, grup_yes, alternative="two-sided")

    print(f"{col:16s}: t = {t:7.2f}, p(t-test) = {p_t:.2e}, p(Mann-Whitney) = {p_u:.2e}")
```
**Mengapa dua uji?** Uji-t mengasumsikan distribusi yang mendekati normal (atau sampel yang sangat besar). Mann-Whitney tidak membuat asumsi distribusi—ia menguji apakah satu kelompok cenderung memiliki nilai lebih tinggi dari yang lain. Jika kedua uji memberi kesimpulan yang sama, kita bisa lebih yakin. Jika mereka berbeda, itu tanda bahwa asumsi uji-t mungkin dilanggar.
## Effect Size: Seberapa Besar Perbedaannya?
Nilai p memberitahu kita **apakah** ada perbedaan. Ia tidak memberitahu kita **seberapa besar**. Dengan 7.043 baris, hampir semua perbedaan sepele akan signifikan secara statistik. Yang kita butuhkan adalah **effect size**.
### Untuk Kategorikal: Cramér's V
```{python}
#| label: cramers-v
from scipy.stats import chi2_contingency

def cramers_v(x: pd.Series, y: pd.Series) -> float:
    ct = pd.crosstab(x, y)
    chi2, _, _, _ = chi2_contingency(ct)
    n = ct.sum().sum()
    return np.sqrt(chi2 / (n * (min(ct.shape) - 1)))

efek_kat = pd.DataFrame({
    col: [cramers_v(df[col], df["Churn"])]
    for col in ["Contract", "InternetService", "PaymentMethod", "Partner"]
}, index=["Cramér's V"]).T.round(3)

efek_kat
```
Interpretasi kasar Cramér's V:
- **< 0,10**: efek sangat kecil
- **0,10–0,30**: efek kecil
- **0,30–0,50**: efek menengah
- **> 0,50**: efek besar
### Untuk Numerik: Cohen's d
```{python}
#| label: cohens-d
def cohens_d(x: pd.Series, y: pd.Series) -> float:
    pooled_std = np.sqrt(((len(x) - 1) * x.var() + (len(y) - 1) * y.var()) /
                         (len(x) + len(y) - 2))
    return (x.mean() - y.mean()) / pooled_std

efek_num = pd.DataFrame({
    col: [cohens_d(df[df["Churn"] == "Yes"][col],
                    df[df["Churn"] == "No"][col])]
    for col in numeric_cols
}, index=["Cohen's d"]).T.round(3)

efek_num["|d| kategori"] = efek_num["Cohen's d"].abs().apply(
    lambda v: "kecil" if v < 0.2 else "menengah" if v < 0.5 else "besar"
)
efek_num
```
Interpretasi kasar Cohen's d:
- **< 0,20**: efek sangat kecil
- **0,20–0,50**: efek kecil
- **0,50–0,80**: efek menengah
- **> 0,80**: efek besar
::: {.callout-important}
**Pelajaran penting.** `tenure` adalah salah satu prediktor terkuat di dataset ini, tetapi Cohen's d-nya masih di kategori "menengah" atau bahkan "kecil" tergantung cutoff. Ini tidak berarti `tenure` tidak penting—ia tetap informatif ketika dikombinasikan dengan variabel lain. Tetapi **tidak ada satu variabel pun yang dengan sendirinya menjelaskan churn**. Ini adalah pelajaran penting yang akan diuji ketika kita membangun model di Bab 9: model yang baik memerlukan **banyak prediktor lemah** yang bekerja bersama, bukan satu prediktor kuat yang dominan.
:::
## Korelasi Antar Variabel Numerik
Sebelum masuk ke model, kita perlu memeriksa **hubungan antar fitur**—bukan hanya antar fitur dan target.
```{python}
#| label: correlation
corr = df[numeric_cols].corr().round(3)
corr
```
```{python}
#| label: fig-corr-heatmap
#| fig-cap: "Matriks korelasi antar variabel numerik. Perhatikan korelasi tinggi antara tenure dan TotalCharges."
#| fig-width: 5
#| fig-height: 4
fig, ax = plt.subplots(figsize=(5, 4))
sns.heatmap(corr, annot=True, cmap="coolwarm", center=0, fmt=".2f",
            square=True, cbar_kws={"shrink": 0.8}, ax=ax)
ax.set_title("Korelasi antar variabel numerik")
plt.tight_layout()
plt.show()
```
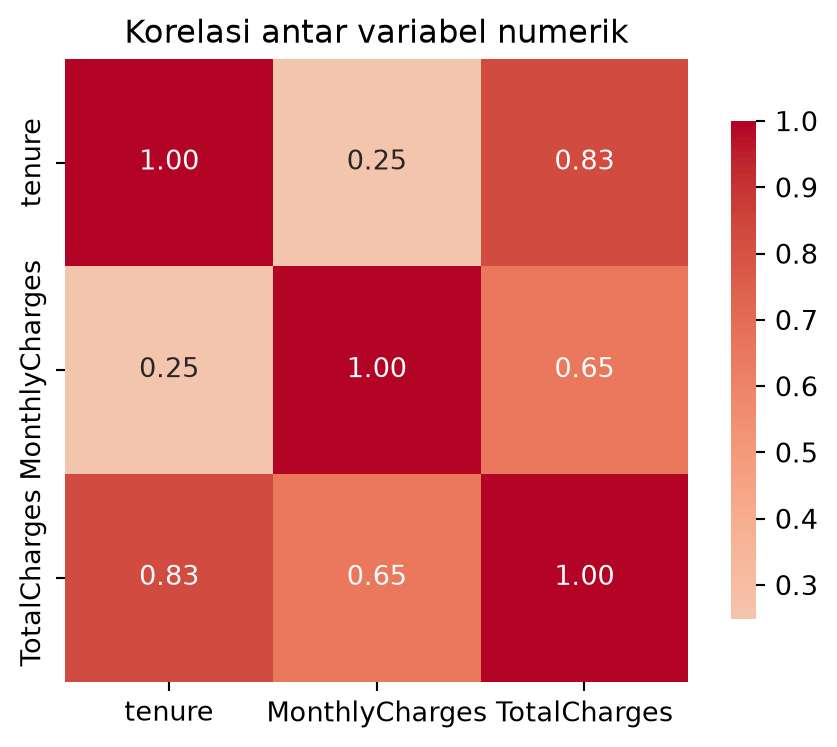
Korelasi `tenure` dan `TotalCharges` tinggi—dan ini **masuk akal secara domain**: pelanggan yang lebih lama secara alami memiliki total tagihan yang lebih besar. Ini bukan masalah *per se*, tetapi menjadi perhatian ketika kita membangun model regresi linear di Bab 8—**multicolinearity** dapat membuat koefisien sulit diinterpretasikan. Untuk model berbasis pohon (Bab 9), multicolinearity tidak menjadi masalah.
::: {.callout-warning}
**Korelasi bukan kausalitas.** Korelasi `tenure`–`TotalCharges` tidak berarti tenure *menyebabkan* tagihan tinggi. Keduanya adalah **konsekuensi bersama** dari fakta sederhana: semakin lama pelanggan berlangganan, semakin banyak yang mereka bayarkan. Ini adalah contoh sempurna dari **variabel perancu** yang harus diwaspadai—dan alasan mengapa analisis kausal membutuhkan desain yang lebih cermat daripada sekadar korelasi.
:::
## Probabilitas: Jembatan ke Bagian II
Bab ini telah membahas **statistik deskriptif**—menggambarkan apa yang ada di data. Bab berikutnya akan mulai berbicara tentang **probabilitas**—menggambarkan **seberapa besar kemungkinan** sesuatu terjadi.
Mengapa probabilitas penting di sini? Karena seluruh Bagian II dibangun di atas gagasan bahwa:
> *"Model prediktif adalah fungsi yang menghasilkan **probabilitas** atau **estimasi**, bukan kepastian."*
Churn rate 26,5% yang kita hitung di awal bab bukan hanya statistik deskriptif—ia juga bisa dibaca sebagai **estimasi probabilitas**: jika kita memilih pelanggan secara acak, ada sekitar 26,5% kemungkinan ia akan churn. Model prediktif di Bab 9 akan memperbaiki estimasi ini dengan menggunakan informasi tambahan: pelanggan dengan kontrak bulanan, tenure pendek, dan tagihan tinggi memiliki probabilitas churn yang **lebih tinggi** dari 26,5%; yang lain lebih rendah.
::: {.callout-tip}
**Latihan berpikir.** Ambil satu pelanggan dari dataset. Tanpa model, tebakan terbaik kita tentang probabilitas churn-nya adalah 26,5% (churn rate keseluruhan). Setelah membaca bab ini, kita tahu bahwa pelanggan dengan kontrak bulanan memiliki churn rate sekitar 43%, sementara pelanggan dengan kontrak dua tahun hanya sekitar 3%. **Informasi ini sudah memperbaiki tebakan kita**—dan itulah inti dari semua yang akan kita pelajari di Bagian II.
:::
## Latihan Terbimbing
**Latihan 3.1 — Mean vs median untuk keputusan.**
kita adalah manajer produk yang ingin melaporkan "tagihan bulanan pelanggan tipikal" kepada direksi. Apakah kita akan melaporkan `mean` atau `median` dari `MonthlyCharges`? Jelaskan pilihan kita dalam satu paragraf, dengan mempertimbangkan siapa audiensnya dan keputusan apa yang akan diambil berdasarkan angka tersebut.
**Latihan 3.2 — Effect size vs signifikansi.**
Untuk setiap variabel kategorikal di dataset, hitung Cramér's V-nya. Urutkan dari yang terbesar ke terkecil. Variabel mana yang memiliki efek terkuat terhadap `Churn`? Apakah urutan ini konsisten dengan intuisi kita dari tabel churn rate per kelompok?
**Latihan 3.3 — Uji normalitas.**
Gunakan `scipy.stats.shapiro` atau `scipy.stats.normaltest` untuk menguji apakah `tenure`, `MonthlyCharges`, dan `TotalCharges` berdistribusi normal. Apa kesimpulan kita? Apakah asumsi normalitas terpenuhi? Jika tidak, apa implikasinya untuk uji-t yang sudah kita jalankan?
**Latihan 3.4 — Korelasi dan kausalitas.**
Identifikasi satu pasangan variabel di dataset yang **berkorelasi tetapi tidak mungkin memiliki hubungan kausal langsung**. Jelaskan mengapa korelasi itu muncul (petunjuk: pikirkan variabel perancu atau hubungan sebab-akibat terbalik).
**Latihan 3.5 — Churn rate per segmen.**
Buat tabel churn rate untuk **kombinasi** dua variabel: `Contract` dan `InternetService`. Apakah ada segmen dengan churn rate di atas 50%? Segmen mana yang paling berisiko, dan bagaimana temuan ini dapat memengaruhi strategi retensi?
::: {.callout-note collapse="true"}
**Petunjuk Latihan 3.3.** Untuk sampel sebesar 7.043 baris, uji normalitas hampir selalu menolak H₀, bahkan untuk penyimpangan kecil dari normalitas. Dalam praktik, kita sering lebih memperhatikan **Q-Q plot** dan **skewness** daripada nilai p uji normalitas. Ini adalah contoh lain dari mengapa effect size lebih informatif daripada signifikansi statistik.
:::
## Kotak "Jembatan": Dari Data ke Keputusan
::: {.callout-important}
**Jembatan.** Bab ini menghasilkan tiga jenis insight yang langsung dapat memengaruhi keputusan:
1. **Segmentasi risiko.** Churn rate berbeda drastis antar segmen: kontrak bulanan (~43%) vs. kontrak dua tahun (~3%). Ini memberi tahu kita **di mana intervensi retensi paling dibutuhkan**. Keputusan: alokasikan anggaran retensi secara tidak proporsional ke pelanggan kontrak bulanan.
2. **Prioritas fitur.** Analisis effect size menunjukkan bahwa **tidak ada satu variabel pun yang dominan**—tetapi kombinasi beberapa variabel lemah dapat menjadi prediktor yang kuat. Ini mengarahkan kita untuk **membangun model multivariabel** di Bagian II, bukan mengandalkan aturan sederhana berbasis satu variabel.
3. **Batasan analisis ini.** Korelasi yang kuat bukan bukti kausalitas. Jika kita ingin menguji apakah intervensi retensi **benar-benar mengurangi churn** (bukan hanya berkorelasi dengan penurunan churn), kita perlu desain eksperimen—A/B test atau quasi-experimental design. Ini adalah batas dari analisis deskriptif, dan pengakuan akan batas ini adalah tanda kedewasaan analitis.
Analisis deskriptif yang baik tidak menghasilkan jawaban final—ia menghasilkan **pertanyaan yang lebih tajam**. Dan pertanyaan-pertanyaan itulah yang akan kita jawab di Bagian II dan III.
:::
## Rangkuman
Dalam bab ini kita telah:
- **Membedakan mean, median, dan mode**, dan memahami kapan masing-masing tepat digunakan—terutama pada distribusi miring seperti `TotalCharges`.
- **Mengukur sebaran** dengan std deviasi, IQR, dan coefficient of variation, dan memahami bahwa setiap ukuran memiliki kekuatan dan keterbatasan.
- **Membaca bentuk distribusi** melalui skewness dan kurtosis, dan menyadari implikasinya untuk pemodelan di Bagian II (terutama perlunya transformasi logaritmik).
- **Mengeksplorasi data secara univariat dan bivariat**, mengidentifikasi bahwa `Contract`, `tenure`, dan `InternetService` adalah prediktor churn yang paling mencolok.
- **Menguji perbedaan secara statistik** dengan chi-square dan uji-t, dan—yang lebih penting—membedakan antara **signifikansi statistik** dan **besaran efek**.
- **Menghitung effect size** (Cramér's V, Cohen's d) untuk memahami seberapa besar perbedaan yang sebenarnya.
- **Memeriksa korelasi antar fitur**, mengidentifikasi multicolinearity antara `tenure` dan `TotalCharges` yang akan relevan di Bab 8.
- **Menghubungkan statistik deskriptif dengan probabilitas**, membangun jembatan konseptual dari "apa yang ada" menuju "apa yang mungkin".
## Jembatan ke Bab 4
Kita telah **mengukur** dan **menguji**—tetapi belum benar-benar **melihat**. Angka dan tabel hanya sebagian dari cerita. Mata manusia jauh lebih cepat dalam mengenali pola, anomali, dan tren ketika disajikan dalam bentuk **visualisasi**.
Bab berikutnya—**Visualisasi Data & Dashboard**—akan mengajarkan kita **bahasa visual** untuk analytics. Kita akan berkenalan dengan prinsip-prinsip visualisasi yang efektif, memilih chart yang tepat untuk pertanyaan yang tepat, dan membangun dashboard interaktif menggunakan Plotly—yang akan menjadi dasar untuk eksplorasi di bab-bab berikutnya, serta template untuk dashboard yang akan kita bangun di dunia nyata.