---
jupyter: decanal
---
# Simulasi Monte Carlo {#sec-monte-carlo}
::: {.callout-note appearance="simple"}
**Tujuan pembelajaran.** Setelah menyelesaikan bab ini, kita akan mampu:
1. Menjelaskan mengapa keputusan nyata selalu menghadapi ketidakpastian, dan mengapa satu titik prediksi tidak cukup.
2. Menerapkan simulasi Monte Carlo untuk membangkitkan distribusi hasil dari model probabilistik.
3. Memilih distribusi probabilitas yang tepat berdasarkan data historis.
4. Menerapkan simulasi pada dua kasus: ketidakpastian churn (Telco) dan ketidakpastian permintaan (retail).
5. Mengevaluasi keputusan berdasarkan **distribusi hasil**—expected value, value-at-risk, dan probability of loss.
6. Menggunakan simulasi untuk membandingkan **alternatif keputusan** sebelum implementasi.
7. Memahami bagaimana simulasi Monte Carlo menjadi fondasi untuk simulasi keputusan di Bab 17.
:::
## Dari Prediksi ke Distribusi
Sampai Bab 11, semua model kita menghasilkan **satu titik prediksi**:
- Regresi (Bab 8): "pelanggan ini memiliki `MonthlyCharges` sekitar Rp 80.000".
- Klasifikasi (Bab 9): "pelanggan ini memiliki probabilitas churn 0,72".
- Forecasting (Bab 10): "permintaan besok adalah 145 unit".
- Clustering (Bab 11): "pelanggan ini termasuk segmen 2".
Tetapi keputusan nyata tidak diambil berdasarkan satu titik. Ia diambil berdasarkan **rentang kemungkinan**:
- *"Jika permintaan 120 unit, kita untung. Jika 100 unit, kita rugi. Seberapa besar kemungkinan rugi?"*
- *"Jika kita menghubungi 200 pelanggan berisiko tinggi, berapa ekspektasi revenue yang diselamatkan? Berapa risikonya?"*
- *"Program retensi ini memiliki expected return Rp 500 juta, tetapi dengan standar deviasi Rp 300 juta. Apakah risikonya dapat diterima?"*
**Simulasi Monte Carlo** menjawab pertanyaan-pertanyaan ini dengan membangkitkan **ribuan skenario** berdasarkan distribusi probabilitas, lalu mengevaluasi keputusan pada setiap skenario.
::: {.callout-important}
**Ide inti Monte Carlo.** Alih-alih bertanya *"apa yang akan terjadi?"*, kita bertanya *"apa yang **mungkin** terjadi, dan seberapa sering?"*—lalu mensimulasikan semua kemungkinan itu.
:::
## Konsep Dasar Simulasi Monte Carlo
### Tiga Langkah
1. **Definisikan model probabilistik**: tentukan variabel input yang tidak pasti, dan distribusi probabilitasnya.
2. **Bangkitkan sampel acak**: ambil ribuan sampel dari distribusi tersebut.
3. **Evaluasi fungsi keputusan**: hitung hasil untuk setiap sampel, dan analisis distribusinya.
### Contoh Sederhana: Estimasi π
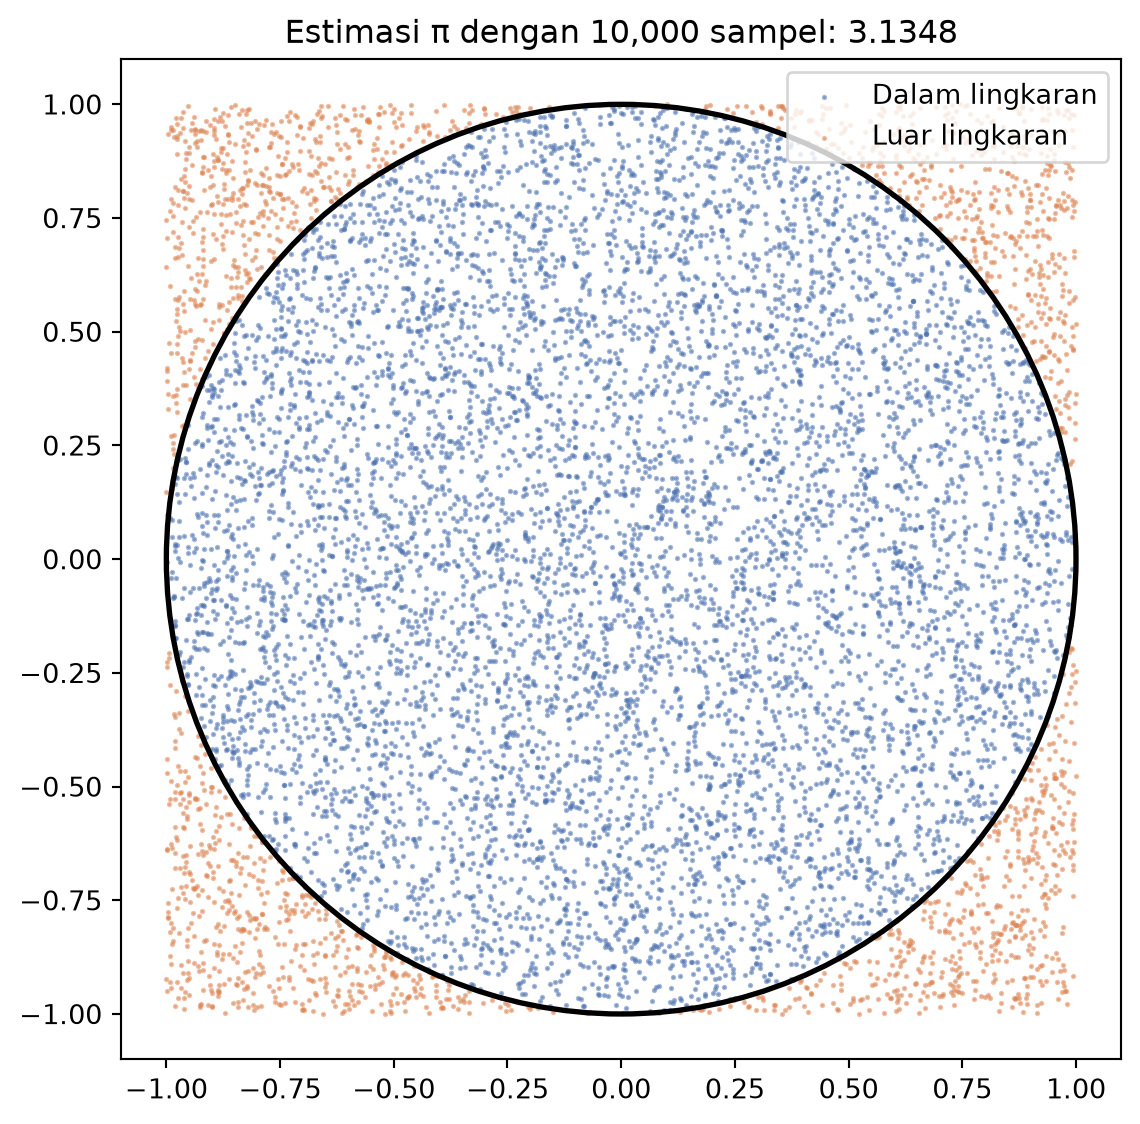
Sebelum masuk ke aplikasi bisnis, mari kita lihat Monte Carlo dalam bentuk paling murni—estimasi π:
```{python}
#| label: pi-monte-carlo
import numpy as np
import matplotlib.pyplot as plt

np.random.seed(42)

# Bangkitkan 10.000 titik acak di kotak [-1, 1] × [-1, 1]
n = 10_000
x = np.random.uniform(-1, 1, n)
y = np.random.uniform(-1, 1, n)

# Hitung berapa yang jatuh di dalam lingkaran berjari-jari 1
inside = (x**2 + y**2) <= 1
pi_estimate = 4 * inside.mean()

print(f"Estimasi π: {pi_estimate:.4f}")
print(f"Nilai sebenarnya: {np.pi:.4f}")
print(f"Error: {abs(pi_estimate - np.pi):.4f}")

# Visualisasi
fig, ax = plt.subplots(figsize=(6, 6))
ax.scatter(x[inside], y[inside], c="#4C72B0", s=1, alpha=0.5, label="Dalam lingkaran")
ax.scatter(x[~inside], y[~inside], c="#DD8452", s=1, alpha=0.5, label="Luar lingkaran")
circle = plt.Circle((0, 0), 1, fill=False, color="black", linewidth=2)
ax.add_patch(circle)
ax.set_aspect("equal")
ax.set_title(f"Estimasi π dengan {n:,} sampel: {pi_estimate:.4f}")
ax.legend()
plt.tight_layout()
plt.show()
```
**Pelajaran dari contoh ini:**
- **Sampel acak** dari distribusi seragam.
- **Fungsi evaluasi** (apakah titik berada dalam lingkaran) diterapkan pada setiap sampel.
- **Rata-rata** hasilnya memberi estimasi nilai yang dicari.
- **Semakin banyak sampel**, semakin akurat estimasi (hukum bilangan besar).
Prinsip yang sama berlaku untuk keputusan bisnis—hanya distribusi dan fungsi evaluasinya yang lebih kompleks.
## Membangkitkan Distribusi dari Data
Langkah pertama Monte Carlo adalah **memilih distribusi** untuk variabel yang tidak pasti. Ada dua pendekatan:
### Pendekatan 1: Distribusi Teoretis
Jika kita yakin data mengikuti distribusi tertentu (mis. normal, eksponensial), kita dapat **mencocokkan** parameter distribusi tersebut ke data.
```{python}
#| label: fit-distributions
import sys
sys.path.insert(0, ".")
import pandas as pd
import seaborn as sns
from scipy import stats
from decanal.utils import load_churn_clean

df = load_churn_clean()
tenure = df["tenure"].values

# Coba beberapa distribusi
fitted = {}
for name, dist in [
    ("Normal", stats.norm),
    ("Lognormal", stats.lognorm),
    ("Gamma", stats.gamma),
    ("Exponential", stats.expon),
]:
    params = dist.fit(tenure)
    # Hitung AIC (semakin kecil semakin baik)
    log_likelihood = np.sum(dist.logpdf(tenure, *params))
    aic = 2 * len(params) - 2 * log_likelihood
    fitted[name] = {"params": params, "AIC": aic}

pd.DataFrame(fitted).T[["AIC"]].sort_values("AIC").round(2)
```
```{python}
#| label: fig-dist-fit
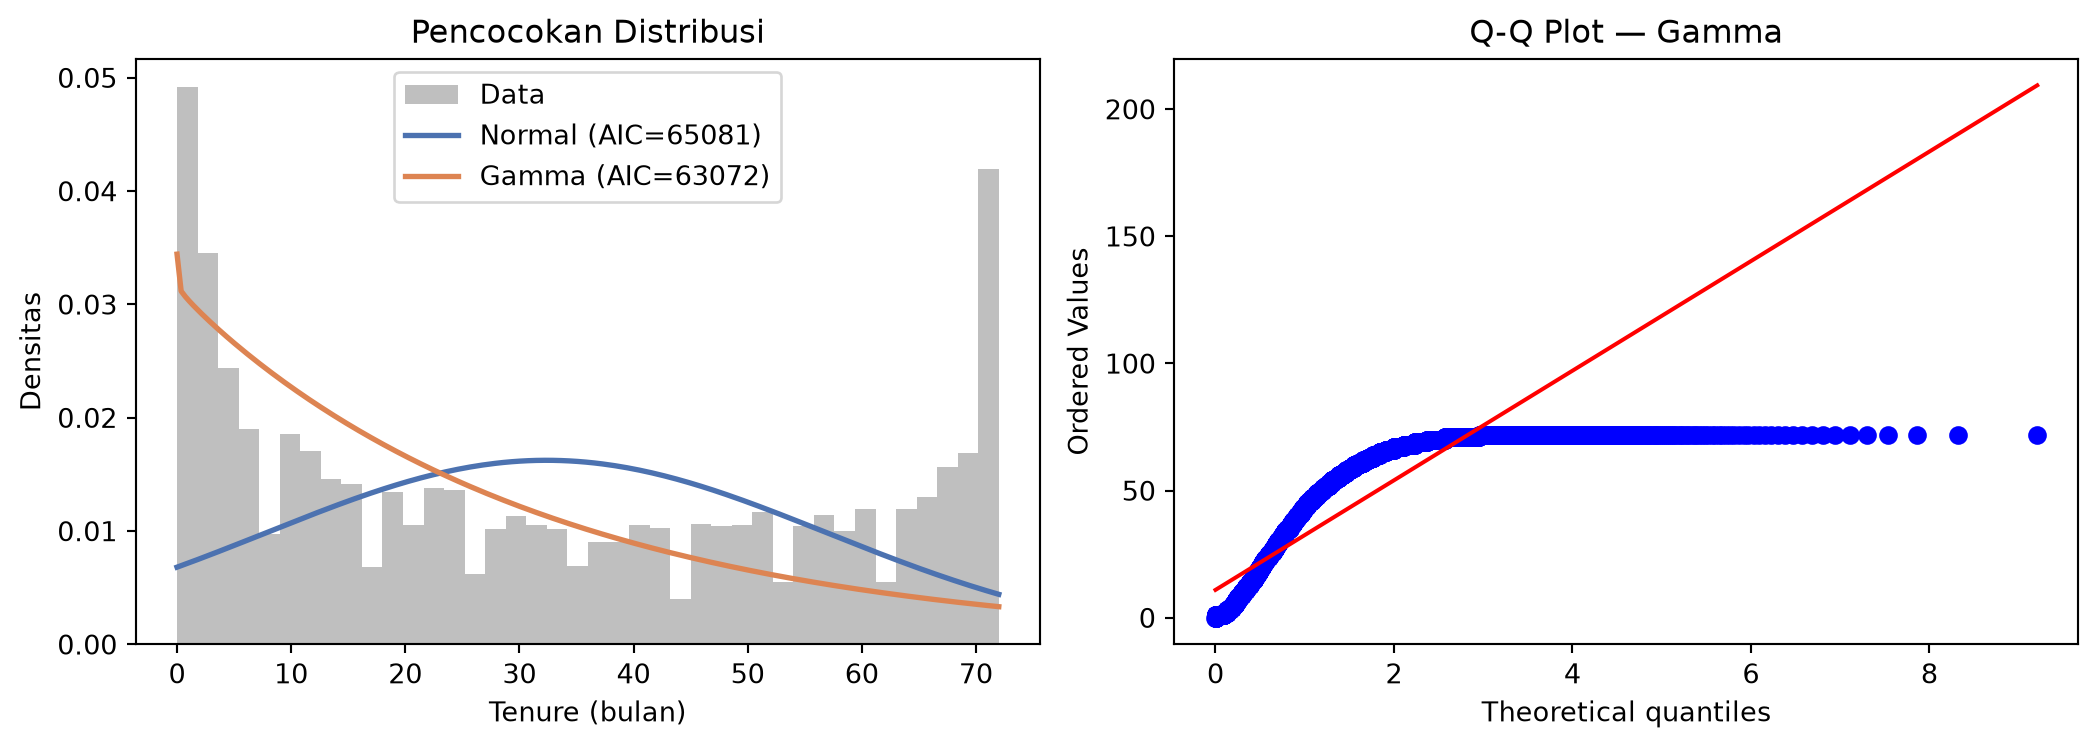
#| fig-cap: "Pencocokan distribusi pada tenure. Distribusi gamma cocok dengan bentuk bimodal ringan; distribusi normal tidak menangkap ekor panjang."
#| fig-width: 10
#| fig-height: 4
fig, axes = plt.subplots(1, 2, figsize=(11, 4))

# Histogram + fitted distributions
axes[0].hist(tenure, bins=40, density=True, alpha=0.5, color="gray", label="Data")
x_range = np.linspace(tenure.min(), tenure.max(), 200)
for name, color in [("Normal", "#4C72B0"), ("Gamma", "#DD8452")]:
    dist = {"Normal": stats.norm, "Gamma": stats.gamma}[name]
    params = fitted[name]["params"]
    axes[0].plot(x_range, dist.pdf(x_range, *params), color=color,
                 linewidth=2, label=f"{name} (AIC={fitted[name]['AIC']:.0f})")
axes[0].set_xlabel("Tenure (bulan)")
axes[0].set_ylabel("Densitas")
axes[0].set_title("Pencocokan Distribusi")
axes[0].legend()

# Q-Q plot untuk gamma
params_gamma = fitted["Gamma"]["params"]
stats.probplot(tenure, dist=stats.gamma, sparams=params_gamma[:-2], plot=axes[1])
axes[1].set_title("Q-Q Plot — Gamma")

plt.tight_layout()
plt.show()
```
::: {.callout-warning}
**Distribusi teoretis tidak selalu cocok.** Data nyata seringkali tidak mengikuti distribusi teoretis mana pun dengan sempurna. Jika pencocokan buruk (AIC tinggi, Q-Q plot menyimpang), pertimbangkan **pendekatan empiris** di bawah.
:::
### Pendekatan 2: Distribusi Empiris (Bootstrap)
**Bootstrap** adalah pendekatan non-parametrik: kita **membangkitkan sampel dengan pengembalian** dari data historis. Tidak perlu mengasumsikan distribusi apa pun—distribusi empiris **adalah** distribusinya.
```{python}
#| label: bootstrap-demo
# Bootstrap: ambil sampel dengan pengembalian dari data asli
n_sim = 10_000
bootstrap_samples = np.random.choice(tenure, size=n_sim, replace=True)

print(f"Mean asli       : {tenure.mean():.2f}")
print(f"Mean bootstrap  : {bootstrap_samples.mean():.2f}")
print(f"Std asli        : {tenure.std():.2f}")
print(f"Std bootstrap   : {bootstrap_samples.std():.2f}")
print(f"\nPersentil 5%    : {np.percentile(bootstrap_samples, 5):.1f}")
print(f"Persentil 95%   : {np.percentile(bootstrap_samples, 95):.1f}")
```
::: {.callout-tip}
**Kapan memakai teoretis vs empiris?**
- **Teoretis** (normal, gamma, dll.): berguna ketika data sedikit, atau ketika kita ingin **menggeneralisasi** ke luar rentang data (mis. simulasi skenario ekstrem).
- **Empiris/bootstrap**: berguna ketika data cukup banyak dan kita ingin **mempertahankan bentuk distribusi asli**—termasuk bimodalitas, skewness, dan outlier.
Untuk buku ini, kita akan memakai **keduanya**—teoretis untuk ilustrasi, empiris untuk aplikasi.
:::
## Aplikasi 1: Ketidakpastian Churn (Telco)
Sekarang kita masuk ke aplikasi bisnis pertama: **berapa revenue yang berisiko hilang akibat churn, dan seberapa tidak pastinya angka itu?**
### Model
Kita ingin mensimulasikan total revenue loss akibat churn dalam satu tahun ke depan. Variabel yang tidak pasti:
1. **Berapa pelanggan yang akan churn?** Kita tahu churn rate historis ~26,5%, tetapi tahun depan bisa berbeda.
2. **Berapa tagihan bulanan pelanggan yang churn?** Bervariasi antar pelanggan.
3. **Berapa lama mereka akan bertahan jika tidak churn?** (untuk menghitung LTV yang hilang)
```{python}
#| label: churn-simulation
from decanal.utils import load_churn_clean

df = load_churn_clean()
churners = df[df["Churn"] == "Yes"]

# Parameter dari data historis
n_customers = len(df)
historical_churn_rate = (df["Churn"] == "Yes").mean()
charges_dist = churners["MonthlyCharges"].values  # distribusi tagihan churner
tenure_dist = churners["tenure"].values            # distribusi tenure churner

print(f"Total pelanggan    : {n_customers:,}")
print(f"Churn rate historis: {historical_churn_rate:.1%}")
print(f"Rata-rata tagihan  : Rp {charges_dist.mean():,.0f}")
print(f"Rata-rata tenure   : {tenure_dist.mean():.1f} bulan")
```
### Simulasi
```{python}
#| label: churn-mc-sim
np.random.seed(42)
n_sim = 10_000
revenue_losses = np.zeros(n_sim)

for i in range(n_sim):
    # 1. Bangkitkan churn rate tahun depan (gunakan distribusi normal di sekitar historis)
    #    Standard error dari proporsi: sqrt(p*(1-p)/n)
    se = np.sqrt(historical_churn_rate * (1 - historical_churn_rate) / n_customers)
    sim_churn_rate = np.random.normal(historical_churn_rate, se)
    sim_churn_rate = np.clip(sim_churn_rate, 0, 1)  # batasi 0-1

    # 2. Berapa pelanggan yang churn?
    n_churn = np.random.binomial(n_customers, sim_churn_rate)

    # 3. Sampel tagihan dan tenure untuk churner
    sim_charges = np.random.choice(charges_dist, size=n_churn, replace=True)
    sim_tenure = np.random.choice(tenure_dist, size=n_churn, replace=True)

    # 4. Hitung total revenue loss = sum(charges × tenure)
    revenue_losses[i] = (sim_charges * sim_tenure).sum()

# Ringkasan hasil
print(f"Revenue loss tahun depan — simulasi {n_sim:,} skenario:")
print(f"  Mean      : Rp {revenue_losses.mean()/1e9:,.2f} miliar")
print(f"  Median    : Rp {np.median(revenue_losses)/1e9:,.2f} miliar")
print(f"  Std dev   : Rp {revenue_losses.std()/1e9:,.2f} miliar")
print(f"  Persentil 5% : Rp {np.percentile(revenue_losses, 5)/1e9:,.2f} miliar")
print(f"  Persentil 95%: Rp {np.percentile(revenue_losses, 95)/1e9:,.2f} miliar")
```
```{python}
#| label: fig-churn-dist
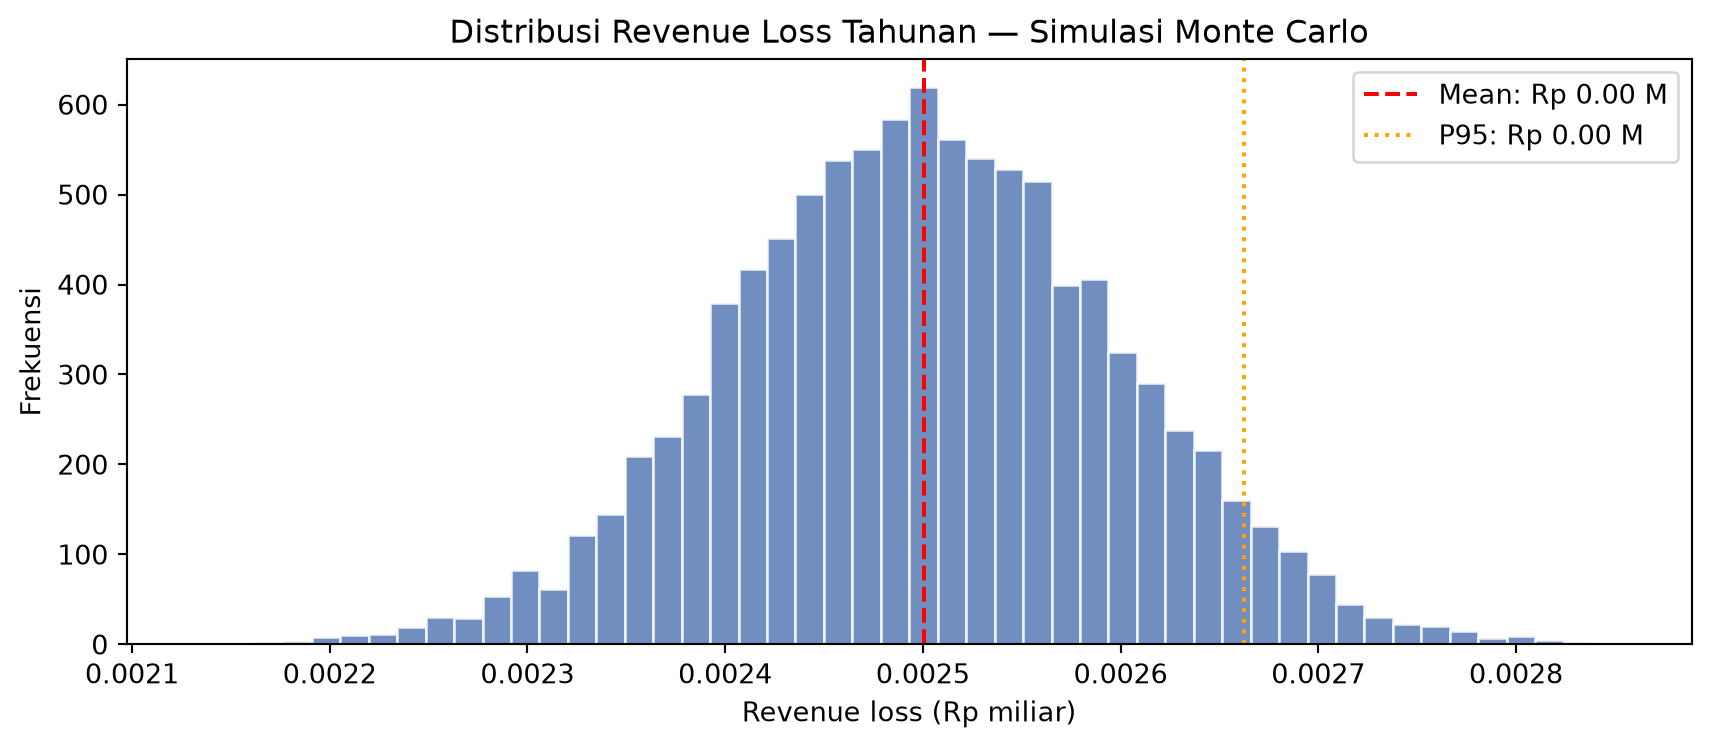
#| fig-cap: "Distribusi revenue loss tahun depan dari 10.000 simulasi. Rentang kemungkinan jauh lebih informatif daripada satu angka prediksi."
#| fig-width: 9
#| fig-height: 4
fig, ax = plt.subplots(figsize=(9, 4))
ax.hist(revenue_losses / 1e9, bins=50, color="#4C72B0", edgecolor="white", alpha=0.8)
ax.axvline(revenue_losses.mean() / 1e9, color="red", linestyle="--",
           label=f"Mean: Rp {revenue_losses.mean()/1e9:.2f} M")
ax.axvline(np.percentile(revenue_losses, 95) / 1e9, color="orange", linestyle=":",
           label=f"P95: Rp {np.percentile(revenue_losses, 95)/1e9:.2f} M")
ax.set_xlabel("Revenue loss (Rp miliar)")
ax.set_ylabel("Frekuensi")
ax.set_title("Distribusi Revenue Loss Tahunan — Simulasi Monte Carlo")
ax.legend()
plt.tight_layout()
plt.show()
```
### Interpretasi untuk Keputusan
Hasil simulasi memberi kita **informasi yang jauh lebih kaya** daripada satu titik prediksi:
| Pertanyaan | Jawaban dari simulasi |
|---|---|
| Berapa ekspektasi revenue loss? | Rp X miliar (mean) |
| Berapa kemungkinan loss > Rp Y miliar? | Z% (dari distribusi) |
| Berapa loss pada skenario terburuk (5%)? | Rp W miliar (persentil 5% dari atas) |
| Seberapa tidak pasti angka ini? | Std deviasi Rp S miliar |
::: {.callout-important}
**Ini adalah inti dari berpikir probabilistik.** Manajemen sering meminta "satu angka"—tetapi satu angka menyembunyikan ketidakpastian. Dengan simulasi, kita dapat mengatakan: *"Ekspektasi loss Rp 2,5 miliar, tetapi ada 10% kemungkinan loss melebihi Rp 3,2 miliar."* Ini memberi konteks untuk keputusan—terutama untuk **risk management** dan **alokasi cadangan**.
:::
## Aplikasi 2: Ketidakpastian Permintaan (Retail)
Sekarang kita beralih ke retail: **berapa banyak stok yang harus dipesan jika permintaan tidak pasti?**
### Model
Kita memiliki produk dengan permintaan harian historis. Setiap hari, kita memutuskan berapa unit yang dipesan. Jika permintaan > stok, kita kehilangan penjualan (*stockout cost*). Jika permintaan < stok, kita menyimpan inventori berlebih (*holding cost*).
```{python}
#| label: retail-demand
from decanal.utils import load_retail

df_retail = load_retail()
df_retail["Date"] = pd.to_datetime(df_retail["Date"])

# Fokus pada satu produk di satu toko untuk contoh yang jelas
product = df_retail["Product ID"].iloc[0]
store = df_retail["Store ID"].iloc[0]
subset = df_retail[(df_retail["Product ID"] == product) &
                    (df_retail["Store ID"] == store)].sort_values("Date")

demand_history = subset["Units Sold"].values
print(f"Produk: {product}, Toko: {store}")
print(f"Jumlah hari: {len(demand_history)}")
print(f"Mean permintaan: {demand_history.mean():.1f} unit/hari")
print(f"Std permintaan : {demand_history.std():.1f} unit/hari")
print(f"Min/Max        : {demand_history.min()}/{demand_history.max()} unit")
```
### Simulasi Keputusan: Berapa Stok Optimal?
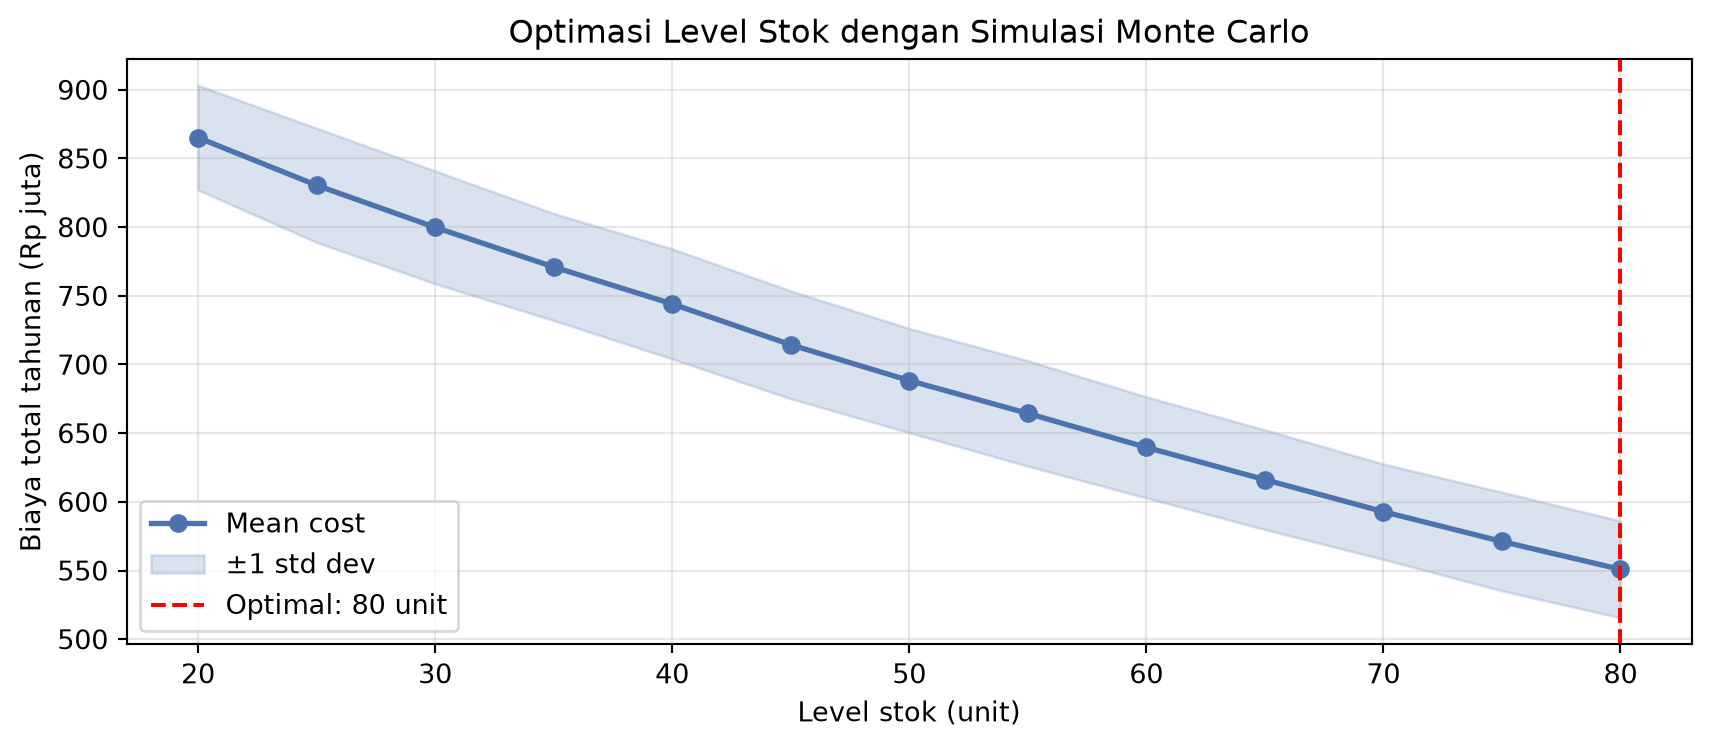
Kita akan mensimulasikan **kebijakan stok** dengan level yang berbeda, dan mengevaluasi **total biaya** (stockout + holding) untuk setiap level:
```{python}
#| label: inventory-sim
np.random.seed(42)
n_days = 365  # horizon simulasi: 1 tahun
n_sim = 1_000  # jumlah skenario

# Parameter biaya
stockout_cost = 20_000   # kerugian per unit yang tidak terpenuhi
holding_cost = 2_000     # biaya penyimpanan per unit per hari

# Level stok yang akan diuji
stock_levels = range(20, 81, 5)

def simulate_policy(stock_level, n_days, n_sim, demand_dist):
    """Simulasi total biaya untuk level stok tertentu."""
    total_costs = []
    for _ in range(n_sim):
        # Bangkitkan permintaan harian dari distribusi empiris
        demands = np.random.choice(demand_dist, size=n_days, replace=True)
        # Hitung stockout dan holding
        stockouts = np.maximum(0, demands - stock_level)
        holdings = np.maximum(0, stock_level - demands)
        cost = (stockouts * stockout_cost + holdings * holding_cost).sum()
        total_costs.append(cost)
    return np.array(total_costs)

results = {}
for level in stock_levels:
    costs = simulate_policy(level, n_days, n_sim, demand_history)
    results[level] = {
        "mean_cost": costs.mean(),
        "p95_cost": np.percentile(costs, 95),
        "std_cost": costs.std(),
    }

hasil_df = pd.DataFrame(results).T.round(0)
hasil_df.columns = ["Mean Cost", "P95 Cost", "Std Dev"]
hasil_df.index.name = "Stock Level"
hasil_df
```
```{python}
#| label: fig-inventory-opt
#| fig-cap: "Biaya total vs level stok. Ada titik optimal di mana total biaya minimum—di bawahnya stockout mahal, di atasnya holding mahal."
#| fig-width: 9
#| fig-height: 4
fig, ax = plt.subplots(figsize=(9, 4))
ax.plot(hasil_df.index, hasil_df["Mean Cost"] / 1e6, marker="o",
        linewidth=2, color="#4C72B0", label="Mean cost")
ax.fill_between(hasil_df.index,
                 (hasil_df["Mean Cost"] - hasil_df["Std Dev"]) / 1e6,
                 (hasil_df["Mean Cost"] + hasil_df["Std Dev"]) / 1e6,
                 alpha=0.2, color="#4C72B0", label="±1 std dev")
optimal_level = hasil_df["Mean Cost"].idxmin()
ax.axvline(optimal_level, color="red", linestyle="--",
           label=f"Optimal: {optimal_level} unit")
ax.set_xlabel("Level stok (unit)")
ax.set_ylabel("Biaya total tahunan (Rp juta)")
ax.set_title("Optimasi Level Stok dengan Simulasi Monte Carlo")
ax.legend()
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()

print(f"Level stok optimal: {optimal_level} unit")
print(f"Mean cost: Rp {hasil_df.loc[optimal_level, 'Mean Cost']/1e6:.1f} juta/tahun")
```
::: {.callout-important}
**Ini adalah prescriptive analytics dalam bentuk paling sederhana.** Kita tidak hanya memprediksi permintaan—kita mensimulasikan **konsekuensi dari keputusan** (level stok) di bawah ketidakpastian, lalu memilih keputusan yang meminimalkan biaya. Bab 17 akan memperluas pendekatan ini ke sistem yang lebih kompleks (antrean, multi-produk, multi-lokasi).
:::
## Risiko dan Value-at-Risk
Salah satu kegunaan utama Monte Carlo adalah **mengukur risiko**, bukan hanya ekspektasi. Tiga metrik yang umum:
| Metrik | Definisi | Interpretasi |
|---|---|---|
| **Expected Value** | Rata-rata distribusi | "Nilai yang diharapkan" |
| **Value-at-Risk (VaR)** | Persentil ke-α dari distribusi kerugian | "Ada α% kemungkinan kerugian melebihi VaR" |
| **Conditional VaR (CVaR)** | Rata-rata kerugian **di atas** VaR | "Jika kerugian melebihi VaR, rata-rata sebesar ini" |
```{python}
#| label: risk-metrics
def risk_metrics(losses, confidence=0.95):
    """Hitung VaR dan CVaR pada tingkat kepercayaan tertentu."""
    var = np.percentile(losses, confidence * 100)
    cvar = losses[losses >= var].mean()
    return {"VaR (95%)": var, "CVaR (95%)": cvar, "Mean": losses.mean()}

metrics = risk_metrics(revenue_losses)
print("Revenue loss — metrik risiko:")
for k, v in metrics.items():
    print(f"  {k:12s}: Rp {v/1e9:,.2f} miliar")
```
**Cara membaca:**
- **Expected value** = Rp 2,5 miliar → "secara rata-rata, kita kehilangan Rp 2,5 miliar".
- **VaR 95%** = Rp 3,2 miliar → "ada 5% kemungkinan kita kehilangan lebih dari Rp 3,2 miliar".
- **CVaR 95%** = Rp 3,8 miliar → "jika kita berada di 5% skenario terburuk, rata-rata kerugian Rp 3,8 miliar".
::: {.callout-tip}
**VaR dan CVaR adalah bahasa risiko.** Manajemen risiko, regulator, dan dewan direksi sering meminta angka-angka ini—bukan hanya ekspektasi. Monte Carlo memberi kita kemampuan untuk menghitungnya dari model yang sama.
:::
## Memilih Distribusi: Panduan Praktis
| Situasi | Distribusi yang disarankan |
|---|---|
| Data kontinu, simetris, tanpa outlier | **Normal** |
| Data kontinu, positif, miring kanan (pendapatan, tagihan) | **Lognormal** atau **Gamma** |
| Waktu antar kejadian (kedatangan pelanggan, waktu layanan) | **Eksponensial** |
| Jumlah kejadian dalam interval (kerusakan, keluhan) | **Poisson** |
| Proporsi / probabilitas sukses | **Beta** atau **Binomial** |
| Data historis cukup banyak, bentuk tidak jelas | **Empiris (bootstrap)** |
::: {.callout-warning}
**Jangan asal pilih distribusi.** Distribusi yang salah dapat menghasilkan simulasi yang menyesatkan—terutama di ekor distribusi, yang justru paling penting untuk analisis risiko. Selalu **validasi** distribusi pilihan kita dengan Q-Q plot dan uji goodness-of-fit (Kolmogorov-Smirnov, Anderson-Darling) sebelum mempercayai hasil simulasi.
:::
## Batas Simulasi Monte Carlo
Monte Carlo adalah alat yang sangat kuat, tetapi bukan tanpa batas:
1. **Garbage in, garbage out.** Simulasi hanya sebaik distribusi input. Jika distribusi salah, hasilnya menyesatkan.
2. **Tidak menangkap black swan.** Distribusi yang dicocokkan pada data historis **tidak akan** menghasilkan kejadian yang belum pernah terjadi. Untuk risiko ekstrem (pandemi, krisis), Monte Carlo standar tidak cukup—diperlukan *stress testing* dan *scenario analysis*.
3. **Kompleksitas model.** Semakin banyak variabel yang disimulasikan, semakin sulit memvalidasi bahwa model mencerminkan realitas. Mulailah sederhana.
4. **Biaya komputasi.** Untuk model kompleks, 10.000 simulasi bisa memakan waktu menit atau jam. Ini biasanya masih dapat diterima, tetapi perlu dipertimbangkan.
::: {.callout-important}
**Monte Carlo bukan pengganti penilaian manusia.** Ia memberi kita **distribusi kemungkinan**—bukan jawaban pasti. Keputusan akhir tetap membutuhkan penilaian manusia tentang:
- Apakah model dan distribusi masuk akal?
- Apakah asumsi yang digunakan dapat dipertahankan?
- Apakah risiko yang dihasilkan dapat diterima secara strategis?
:::
## Latihan Terbimbing
**Latihan 12.1 — Estimasi π dengan sampel berbeda.**
Ulangi estimasi π dengan 100, 1.000, 10.000, dan 100.000 sampel. Plot error absolut vs jumlah sampel. Berapa banyak sampel yang dibutuhkan untuk error < 0,01? Apakah ini sesuai dengan teori (error ~ 1/√n)?
**Latihan 12.2 — Distribusi churn.**
Ulangi simulasi revenue loss churn dengan **distribusi churn rate yang berbeda**—misalnya, gunakan distribusi beta alih-alih normal. Apakah hasilnya berubah secara signifikan? Mengapa?
**Latihan 12.3 — Sensitivitas parameter.**
Dalam simulasi inventory, ubah `stockout_cost` menjadi 10.000 dan 40.000. Bagaimana level stok optimal berubah? Jelaskan hubungan antara biaya stockout dan level stok optimal.
**Latihan 12.4 — Monte Carlo untuk keputusan retensi.**
Bayangkan kita memiliki anggaran retensi Rp 500 juta. Setiap intervensi biaya Rp 200.000 per pelanggan dan mengurangi probabilitas churn sebesar 30% (relatif). Simulasikan berapa banyak pelanggan yang bisa diintervensi, dan berapa ekspektasi revenue yang diselamatkan. Gunakan probabilitas churn dari model klasifikasi Bab 9 (atau asumsikan distribusi sederhana).
**Latihan 12.5 — VaR untuk portofolio.**
kita memiliki portofolio tiga produk dengan permintaan yang berkorelasi. Simulasikan total revenue dari ketiga produk selama 30 hari, dengan asumsi korelasi antar produk 0,3. Hitung VaR 95% dan CVaR 95%. Bagaimana hasilnya berbeda jika korelasi 0,8?
::: {.callout-note collapse="true"}
**Petunjuk Latihan 12.5.** Untuk membangkitkan permintaan yang berkorelasi, gunakan **distribusi normal multivariat** (`np.random.multivariate_normal`) dengan matriks kovarians yang mencerminkan korelasi. Setelah mendapatkan sampel berkorelasi, transformasikan ke distribusi yang diinginkan (mis. eksponensial atau empiris).
:::
## Kotak "Jembatan": Dari Simulasi ke Optimasi
::: {.callout-important}
**Jembatan.** Bab ini melengkapi **alat berpikir** Bagian II:
| Bab | Kemampuan |
|---|---|
| 7–9 | **Memprediksi** probabilitas dan kelas |
| 10 | **Memodelkan** waktu dan tren |
| 11 | **Menemukan** struktur dan segmen |
| 12 | **Mensimulasikan** ketidakpastian |
Dengan keempat kemampuan ini, kita sekarang dapat menjawab pertanyaan seperti:
- *"Berapa probabilitas pelanggan X akan churn?"* (Bab 9)
- *"Berapa revenue yang berisiko hilang jika kita tidak melakukan apa-apa?"* (Bab 12)
- *"Jika kita menghubungi 200 pelanggan berisiko tinggi, berapa ekspektasi revenue yang diselamatkan, dan berapa risikonya?"* (Bab 12)
- *"Berapa level stok optimal jika permintaan tidak pasti?"* (Bab 12)
Tetapi kita **belum** menjawab pertanyaan optimasi yang sesungguhnya:
- *"Dengan anggaran Rp 500 juta, kombinasi intervensi mana yang memaksimalkan revenue yang diselamatkan?"*
- *"Bagaimana mengalokasikan anggaran retensi ke berbagai segmen untuk memaksimalkan ROI?"*
- *"Berapa banyak staf yang perlu dijadwalkan untuk meminimalkan waktu tunggu pelanggan?"*
**Inilah tujuan Bagian III—prescriptive analytics.** Model optimasi akan menggunakan **probabilitas dari Bagian II** sebagai input, dan **simulasi dari bab ini** untuk mengevaluasi keputusan di bawah ketidakpastian.
Bab 13 akan membuka Bagian III dengan fondasi pengambilan keputusan: payoff table, decision tree, dan nilai informasi. Bab 14–17 akan memperkenalkan teknik optimasi konkret—linear programming, integer programming, network optimization, dan simulasi keputusan. Bab 18 akan menutup dengan integrasi end-to-end.
:::
## Rangkuman
Dalam bab ini kita telah:
- **Memahami mengapa satu titik prediksi tidak cukup**—keputusan nyata membutuhkan distribusi kemungkinan, bukan hanya ekspektasi.
- **Menerapkan simulasi Monte Carlo** dalam tiga langkah: definisikan model probabilistik, bangkitkan sampel, evaluasi fungsi keputusan.
- **Memilih distribusi** yang tepat—teoretis (normal, gamma, lognormal) atau empiris (bootstrap)—berdasarkan data dan konteks.
- **Mensimulasikan ketidakpastian churn** pada dataset Telco, menghasilkan distribusi revenue loss yang jauh lebih informatif daripada satu angka.
- **Mensimulasikan keputusan inventory** pada dataset retail, menemukan level stok optimal yang meminimalkan total biaya.
- **Mengukur risiko** dengan VaR dan CVaR, memahami bahwa "ekspektasi" dan "risiko" adalah dua dimensi yang berbeda.
- **Menyadari batas Monte Carlo**: garbage in garbage out, tidak menangkap black swan, dan tetap membutuhkan penilaian manusia.
## Jembatan ke Bagian III
Bagian II telah memberi kita **model prediktif** yang dapat:
- Memprediksi probabilitas churn per pelanggan.
- Memperkirakan permintaan di masa depan.
- Mengelompokkan pelanggan ke dalam segmen.
- Mensimulasikan ketidakpastian dalam hasil.
Tetapi prediksi bukan keputusan. Kita sekarang memiliki **bahan mentah** untuk keputusan—tetapi belum **resep** untuk mengubahnya menjadi tindakan optimal.
**Bagian III—Prescriptive Analytics**—akan mengajarkan kita:
- **Bab 13 — Fondasi Prescriptive**: payoff table, decision tree, nilai informasi, dan pengambilan keputusan di bawah ketidakpastian.
- **Bab 14 — Linear Programming**: mengalokasikan sumber daya terbatas secara optimal.
- **Bab 15 — Integer & Nonlinear Programming**: keputusan diskrit (ya/tidak, berapa banyak) dan hubungan non-linear.
- **Bab 16 — Network & Multi-Objective Optimization**: aliran jaringan dan trade-off antar tujuan.
- **Bab 17 — Simulation for Decision Making**: menggabungkan simulasi dengan optimasi.
- **Bab 18 — Integrasi & Proyek Akhir**: dari data mentah ke rekomendasi kebijakan.
**Selamat datang di Bagian III.**