---
jupyter: decanal
---
# Fondasi Prescriptive Analytics {#sec-fondasi-preskriptif}
::: {.callout-note appearance="simple"}
**Tujuan pembelajaran.** Setelah menyelesaikan bab ini, kita akan mampu:
1. Membedakan prediksi dari keputusan, dan memahami mengapa prediksi yang akurat tidak otomatis menghasilkan keputusan yang baik.
2. Menguraikan masalah keputusan menjadi komponen: alternatif, keadaan, hasil, dan probabilitas.
3. Membangun **payoff table** dan **decision tree** untuk memformalkan keputusan.
4. Menerapkan kriteria keputusan di bawah ketidakpastian: maximin, maximax, minimax regret, dan expected value.
5. Menghitung **Expected Value of Perfect Information (EVPI)** dan **Expected Value of Sample Information (EVSI)**.
6. Menghubungkan model prediktif dari Bagian II ke kerangka keputusan—dan menyadari di mana ia **belum cukup**.
7. Mempersiapkan diri untuk teknik optimasi konkret di Bab 14–17.
:::
## Dari "Apa yang Akan Terjadi?" ke "Apa yang Harus Dilakukan?"
Seluruh Bagian II mengajarkan kita untuk **memprediksi**:
- Bab 8: berapa tagihan bulanan pelanggan.
- Bab 9: berapa probabilitas churn per pelanggan.
- Bab 10: berapa permintaan minggu depan.
- Bab 11: pelanggan ini termasuk segmen mana.
- Bab 12: seberapa tidak pasti hasil dari suatu kebijakan.
Tetapi semua prediksi ini **tidak dengan sendirinya menjadi keputusan**. Ini adalah fakta yang sering diabaikan:
> *"Model churn kita memiliki AUC 0,88"* ≠ *"Kita tahu pelanggan mana yang harus dihubungi"*.
Prediksi memberi kita **informasi** tentang dunia. Keputusan adalah **tindakan** yang kita pilih berdasarkan informasi itu—dengan mempertimbangkan biaya, manfaat, dan ketidakpastian. Jembatan antara keduanya adalah **kerangka keputusan**.
::: {.callout-important}
**Bagian III adalah tentang mengubah probabilitas menjadi tindakan.** Probabilitas churn 0,72 untuk pelanggan X bukanlah keputusan. Keputusannya adalah: *"Apakah kita menghubungi pelanggan X? Dengan intervensi apa? Berapa biayanya? Berapa manfaat yang diharapkan?"* Bab ini memberi kita bahasa dan alat untuk menjawab pertanyaan-pertanyaan itu secara sistematis.
:::
## Anatomi Masalah Keputusan
Setiap masalah keputusan—dari yang sederhana hingga yang kompleks—dapat diuraikan menjadi **lima komponen**:
| Komponen | Pertanyaan | Contoh (Telco) |
|---|---|---|
| **Alternatif** | Apa saja pilihan yang tersedia? | Hubungi dengan diskon / hubungi dengan layanan gratis / tidak hubungi |
| **Keadaan** | Apa yang tidak kita kendalikan? | Pelanggan akan churn / tidak akan churn |
| **Probabilitas** | Seberapa besar kemungkinan setiap keadaan? | 0,72 churn, 0,28 tidak churn |
| **Hasil (payoff)** | Apa konsekuensi dari setiap kombinasi alternatif × keadaan? | Lihat tabel di bawah |
| **Kriteria** | Bagaimana kita memilih di antara alternatif? | Expected value, maximin, dsb. |
### Contoh: Keputusan Retensi Pelanggan
Bayangkan kita memiliki pelanggan dengan **probabilitas churn 0,72** (dari model Bab 9). Kita memiliki tiga alternatif:
1. **Tidak melakukan apa-apa**.
2. **Kirim email otomatis** (biaya rendah, efektivitas moderat).
3. **Hubungi dengan diskon 20%** (biaya tinggi, efektivitas tinggi).
Kita tidak tahu pasti apakah pelanggan akan churn. Kita hanya tahu probabilitasnya. Keputusan harus diambil **sebelum** hasil diketahui.
::: {.callout-tip}
**Perhatikan struktur waktu.** Keputusan diambil **sekarang**, hasilnya diketahui **nanti**. Ini adalah esensi ketidakpastian: kita tidak bisa menunggu untuk melihat hasil sebelum memutuskan. Jika kita bisa, itu bukan keputusan—itu hanya observasi.
:::
## Payoff Table: Memformalkan Keputusan
**Payoff table** (tabel hasil) menampilkan konsekuensi dari setiap kombinasi alternatif dan keadaan. Ini adalah alat paling dasar dalam analisis keputusan.
### Membangun Payoff Table untuk Keputusan Retensi
```{python}
#| label: setup
import sys
sys.path.insert(0, ".")
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
import warnings
warnings.filterwarnings("ignore")

from decanal.utils import load_churn_clean

np.random.seed(42)
pd.set_option("display.float_format", lambda x: f"{x:,.0f}")
```
```{python}
#| label: payoff-table
# Parameter keputusan retensi
p_churn = 0.72                # probabilitas churn (dari model Bab 9)
monthly_charge = 80_000       # tagihan bulanan pelanggan
expected_remaining_tenure = 12  # bulan (asumsi)
ltv = monthly_charge * expected_remaining_tenure  # nilai pelanggan

# Biaya intervensi dan efektivitas (dalam pengurangan probabilitas churn)
interventions = {
    "Tidak melakukan apa-apa": {"cost": 0,       "effectiveness": 0.00},
    "Email otomatis":          {"cost": 20_000,  "effectiveness": 0.10},
    "Diskon 20%":              {"cost": 200_000, "effectiveness": 0.40},
}

# Bangun payoff table
rows = []
for name, params in interventions.items():
    # Jika pelanggan churn (setelah intervensi)
    p_churn_after = p_churn * (1 - params["effectiveness"])
    # Payoff jika churn: kita kehilangan LTV + biaya intervensi
    payoff_churn = -ltv - params["cost"]
    # Payoff jika tidak churn: kita mempertahankan LTV - biaya intervensi
    payoff_no_churn = -params["cost"]

    rows.append({
        "Alternatif": name,
        "Biaya": params["cost"],
        "P(churn) setelah intervensi": p_churn_after,
        "Payoff jika CHURN": payoff_churn,
        "Payoff jika TIDAK CHURN": payoff_no_churn,
    })

payoff_df = pd.DataFrame(rows)
payoff_df
```
**Perhatikan dua hal:**
1. **Setiap alternatif memiliki hasil berbeda di setiap keadaan.** Jika pelanggan churn, kita kehilangan LTV (dan membayar biaya intervensi). Jika tidak churn, kita hanya membayar biaya intervensi.
2. **Intervensi mengubah probabilitas, bukan menghilangkan ketidakpastian.** Bahkan setelah diskon 20%, pelanggan masih memiliki probabilitas churn ~43% (0,72 × 0,60). Tidak ada alternatif yang menjamin hasil.
## Kriteria Keputusan di Bawah Ketidakpastian
Dengan payoff table di tangan, bagaimana memilih alternatif? Ada **empat kriteria utama**, masing-masing mencerminkan sikap yang berbeda terhadap risiko.
### 1. Maximin (Pesimis)
**Prinsip:** pilih alternatif yang **memaksimalkan hasil terburuk**.
```{python}
#| label: maximin
# Untuk setiap alternatif, ambil payoff terburuk
worst_case = {
    "Tidak melakukan apa-apa": min(payoff_df.loc[0, "Payoff jika CHURN"],
                                    payoff_df.loc[0, "Payoff jika TIDAK CHURN"]),
    "Email otomatis": min(payoff_df.loc[1, "Payoff jika CHURN"],
                           payoff_df.loc[1, "Payoff jika TIDAK CHURN"]),
    "Diskon 20%": min(payoff_df.loc[2, "Payoff jika CHURN"],
                       payoff_df.loc[2, "Payoff jika TIDAK CHURN"]),
}

print("Payoff terburuk per alternatif:")
for name, worst in worst_case.items():
    print(f"  {name:25s}: Rp {worst:>12,.0f}")

best_maximin = max(worst_case, key=worst_case.get)
print(f"\n→ Maximin memilih: {best_maximin}")
```
**Kapan dipakai:** ketika kerugian besar tidak dapat ditanggung—misalnya untuk keputusan yang mengancam kelangsungan bisnis. Ini adalah kriteria **konservatif**.
### 2. Maximax (Optimis)
**Prinsip:** pilih alternatif yang **memaksimalkan hasil terbaik**.
```{python}
#| label: maximax
best_case = {
    "Tidak melakukan apa-apa": max(payoff_df.loc[0, "Payoff jika CHURN"],
                                    payoff_df.loc[0, "Payoff jika TIDAK CHURN"]),
    "Email otomatis": max(payoff_df.loc[1, "Payoff jika CHURN"],
                           payoff_df.loc[1, "Payoff jika TIDAK CHURN"]),
    "Diskon 20%": max(payoff_df.loc[2, "Payoff jika CHURN"],
                       payoff_df.loc[2, "Payoff jika TIDAK CHURN"]),
}

print("Payoff terbaik per alternatif:")
for name, best in best_case.items():
    print(f"  {name:25s}: Rp {best:>12,.0f}")

best_maximax = max(best_case, key=best_case.get)
print(f"\n→ Maximax memilih: {best_maximax}")
```
**Kapan dipakai:** ketika kita mengejar peluang dan dapat menanggung kerugian. Ini adalah kriteria **agresif**—sering tidak cocok untuk keputusan bisnis yang berulang.
### 3. Minimax Regret (Menyesali Keputusan yang Salah)
**Prinsip:** pilih alternatif yang **meminimalkan penyesalan maksimum**—selisih antara hasil terbaik yang mungkin dan hasil aktual.
```{python}
#| label: minimax-regret
# Hitung regret: untuk setiap keadaan, selisih antara payoff terbaik dan payoff aktual
regrets = []
for state in ["Payoff jika CHURN", "Payoff jika TIDAK CHURN"]:
    best_in_state = payoff_df[state].max()
    regret_col = best_in_state - payoff_df[state]
    regrets.append(regret_col)

regret_df = pd.DataFrame({
    "Alternatif": payoff_df["Alternatif"],
    "Regret jika CHURN": regrets[0],
    "Regret jika TIDAK CHURN": regrets[1],
})
regret_df["Regret maksimum"] = regret_df[["Regret jika CHURN", "Regret jika TIDAK CHURN"]].max(axis=1)
regret_df
```
```{python}
#| label: minimax-result
best_minimax = regret_df.loc[regret_df["Regret maksimum"].idxmin(), "Alternatif"]
print(f"→ Minimax regret memilih: {best_minimax}")
```
**Kapan dipakai:** ketika kita ingin menghindari **penyesalan**—"jika saya memilih ini dan hasilnya buruk, seberapa buruk dibandingkan jika saya memilih yang lain?" Ini adalah kriteria yang lebih seimbang dari maximin, sering dipakai dalam keputusan strategis.
### 4. Expected Value (Rasional-Netral terhadap Risiko)
**Prinsip:** pilih alternatif dengan **expected value** tertinggi—rata-rata payoff tertimbang probabilitas.
$$\text{EV}(A) = \sum_{s} P(s) \cdot \text{Payoff}(A, s)$$
```{python}
#| label: expected-value
# Hitung expected value untuk setiap alternatif
ev_rows = []
for i, row in payoff_df.iterrows():
    p_after = row["P(churn) setelah intervensi"]
    ev = p_after * row["Payoff jika CHURN"] + (1 - p_after) * row["Payoff jika TIDAK CHURN"]
    ev_rows.append({"Alternatif": row["Alternatif"], "Expected Value": ev})

ev_df = pd.DataFrame(ev_rows).sort_values("Expected Value", ascending=False)
ev_df
```
```{python}
#| label: fig-payoff-comparison
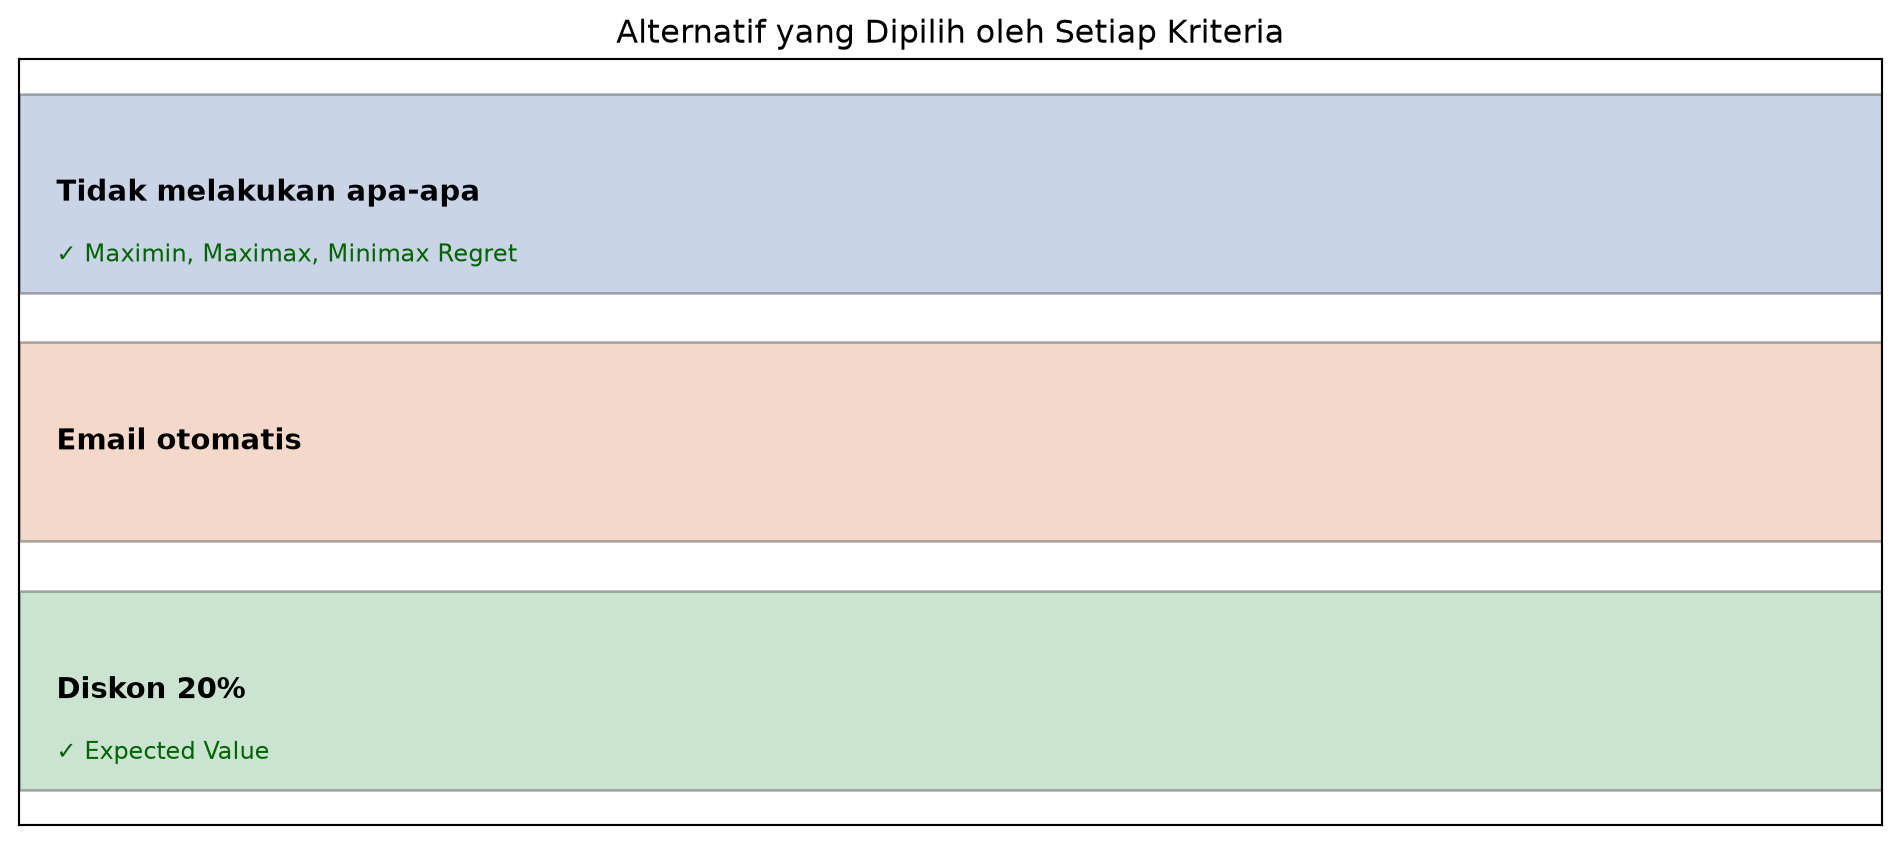
#| fig-cap: "Perbandingan empat kriteria keputusan. Setiap kriteria bisa memilih alternatif yang berbeda—menunjukkan bahwa keputusan bukan hanya soal angka."
#| fig-width: 10
#| fig-height: 4.5
kriteria = {
    "Maximin": best_maximin,
    "Maximax": best_maximax,
    "Minimax Regret": best_minimax,
    "Expected Value": ev_df.iloc[0]["Alternatif"],
}

fig, ax = plt.subplots(figsize=(10, 4.5))
alternatives = payoff_df["Alternatif"].tolist()
colors = ["#4C72B0", "#DD8452", "#55A868"]

for i, alt in enumerate(alternatives):
    y_pos = len(alternatives) - 1 - i
    kriteria_terpilih = [k for k, v in kriteria.items() if v == alt]
    ax.barh(y_pos, 1, color=colors[i], alpha=0.3, edgecolor="black")
    ax.text(0.02, y_pos, alt, va="center", fontsize=11, fontweight="bold")
    if kriteria_terpilih:
        ax.text(0.02, y_pos - 0.25, "✓ " + ", ".join(kriteria_terpilih),
                va="center", fontsize=9, color="darkgreen")

ax.set_xlim(0, 1)
ax.set_yticks([])
ax.set_xticks([])
ax.set_title("Alternatif yang Dipilih oleh Setiap Kriteria")
plt.tight_layout()
plt.show()
```
::: {.callout-important}
**Tidak ada kriteria yang "benar" secara universal.** Setiap kriteria mencerminkan **sikap terhadap risiko**:
- **Maximin** = menghindari kerugian besar (konservatif).
- **Maximax** = mengejar keuntungan besar (agresif).
- **Minimax regret** = meminimalkan penyesalan (seimbang).
- **Expected value** = rata-rata jangka panjang (netral risiko).
Untuk keputusan berulang seperti retensi pelanggan, **expected value** biasanya paling tepat—karena kita mengambil banyak keputusan serupa dan rata-rata akan mendekati ekspektasi. Untuk keputusan sekali seumur hidup (mis. merger), **minimax regret** atau **maximin** mungkin lebih tepat.
:::
## Decision Tree: Memformalkan Keputusan Berurutan
Payoff table cukup untuk keputusan **satu tahap**. Tetapi banyak keputusan bersifat **berurutan**: keputusan hari ini memengaruhi informasi yang tersedia untuk keputusan besok.
**Decision tree** adalah representasi visual dan komputasional dari keputusan berurutan.
### Contoh: Keputusan Retensi Dua Tahap
Bayangkan kita memiliki pelanggan dengan probabilitas churn 0,72. Kita bisa:
1. **Tahap 1**: Tidak melakukan apa-apa, atau kirim email (biaya Rp 20.000).
2. **Tahap 2**: Jika email berhasil (pelanggan tidak churn setelah 1 bulan), kita bisa memutuskan untuk menawarkan diskon atau tidak.
```{python}
#| label: fig-decision-tree
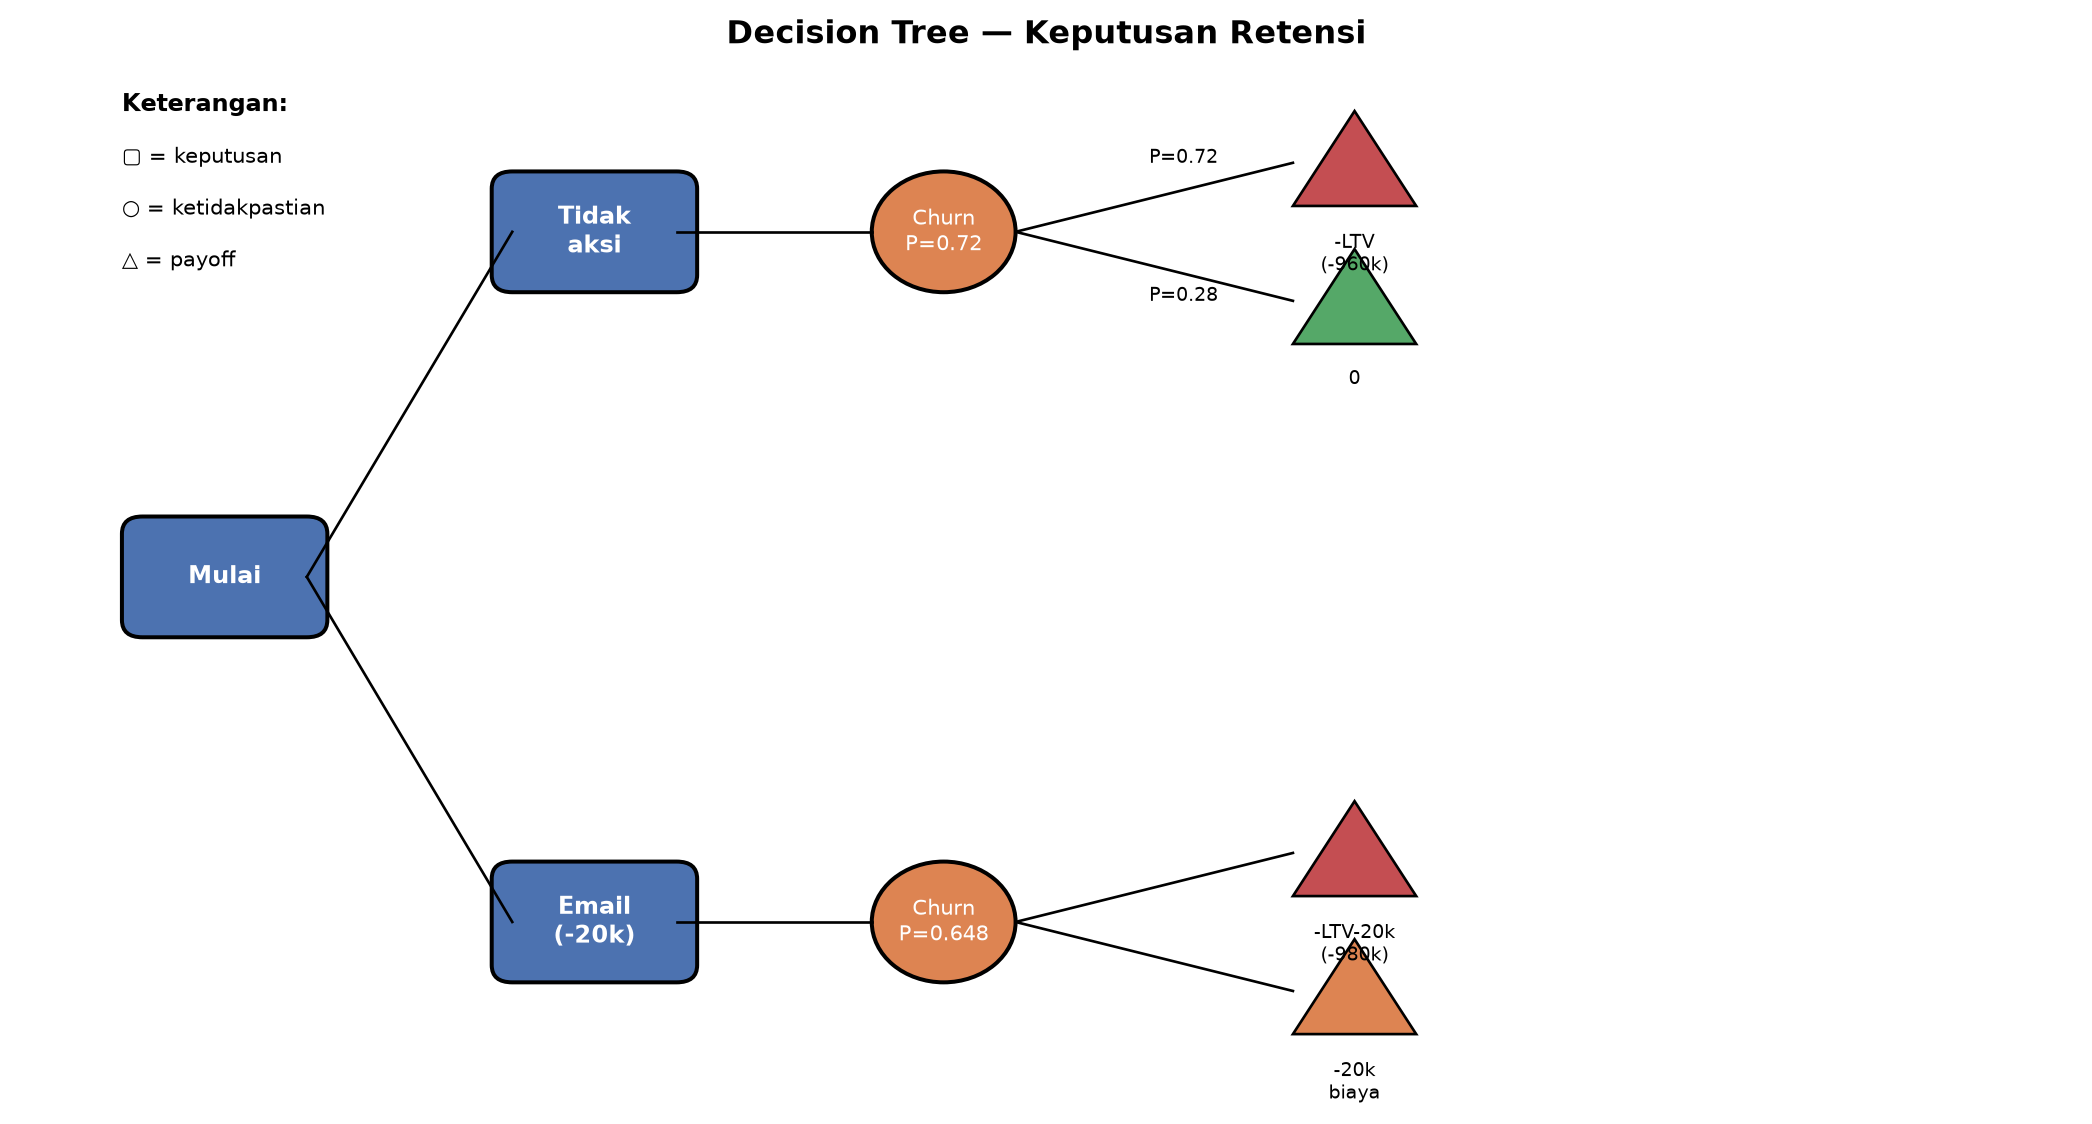
#| fig-cap: "Decision tree untuk keputusan retensi dua tahap. Kotak = keputusan; lingkaran = ketidakpastian; segitiga = payoff akhir."
#| fig-width: 10
#| fig-height: 6
from matplotlib.patches import FancyBboxPatch, Circle, Polygon

fig, ax = plt.subplots(figsize=(11, 6))
ax.set_xlim(0, 10)
ax.set_ylim(0, 6)
ax.axis("off")

def draw_decision_node(x, y, label, color="#4C72B0"):
    box = FancyBboxPatch((x-0.4, y-0.25), 0.8, 0.5, boxstyle="round,pad=0.1",
                          facecolor=color, edgecolor="black", linewidth=1.5)
    ax.add_patch(box)
    ax.text(x, y, label, ha="center", va="center", color="white", fontsize=9, fontweight="bold")

def draw_chance_node(x, y, label):
    circle = Circle((x, y), 0.35, facecolor="#DD8452", edgecolor="black", linewidth=1.5)
    ax.add_patch(circle)
    ax.text(x, y, label, ha="center", va="center", color="white", fontsize=8)

def draw_terminal(x, y, label, color="#55A868"):
    triangle = Polygon([[x-0.3, y-0.25], [x+0.3, y-0.25], [x, y+0.3]],
                        facecolor=color, edgecolor="black", linewidth=1)
    ax.add_patch(triangle)
    ax.text(x, y-0.4, label, ha="center", va="top", fontsize=7)

# Root decision
draw_decision_node(1, 3, "Mulai")

# Branch 1: No action
draw_decision_node(2.8, 5, "Tidak\naksi")
ax.plot([1.4, 2.4], [3, 5], "k-", linewidth=1)
draw_chance_node(4.5, 5, "Churn\nP=0.72")
ax.plot([3.2, 4.15], [5, 5], "k-", linewidth=1)
draw_terminal(6.5, 5.4, f"-LTV\n(-{ltv/1000:.0f}k)", color="#C44E52")
ax.plot([4.85, 6.2], [5, 5.4], "k-", linewidth=1)
draw_terminal(6.5, 4.6, "0", color="#55A868")
ax.plot([4.85, 6.2], [5, 4.6], "k-", linewidth=1)
ax.text(5.5, 5.4, f"P=0.72", fontsize=7)
ax.text(5.5, 4.6, f"P=0.28", fontsize=7)

# Branch 2: Email
draw_decision_node(2.8, 1, "Email\n(-20k)")
ax.plot([1.4, 2.4], [3, 1], "k-", linewidth=1)
draw_chance_node(4.5, 1, "Churn\nP=0.648")
ax.plot([3.2, 4.15], [1, 1], "k-", linewidth=1)
draw_terminal(6.5, 1.4, f"-LTV-20k\n(-{ltv/1000+20:.0f}k)", color="#C44E52")
ax.plot([4.85, 6.2], [1, 1.4], "k-", linewidth=1)
draw_terminal(6.5, 0.6, "-20k\nbiaya", color="#DD8452")
ax.plot([4.85, 6.2], [1, 0.6], "k-", linewidth=1)

# Legend
ax.text(0.5, 5.7, "Keterangan:", fontsize=9, fontweight="bold")
ax.text(0.5, 5.4, "▢ = keputusan", fontsize=8)
ax.text(0.5, 5.1, "○ = ketidakpastian", fontsize=8)
ax.text(0.5, 4.8, "△ = payoff", fontsize=8)

ax.set_title("Decision Tree — Keputusan Retensi", fontsize=12, fontweight="bold")
plt.tight_layout()
plt.show()
```
**Cara membaca decision tree:**
1. **Mulai dari kiri** (keputusan utama).
2. **Kotak biru** = titik keputusan (kita memilih).
3. **Lingkaran oranye** = titik ketidakpastian (alam yang memilih).
4. **Segitiga** = payoff akhir.
5. **Backward induction**: hitung expected value dari kanan ke kiri, pilih alternatif terbaik di setiap keputusan.
```{python}
#| label: decision-tree-eval
# Hitung expected value mundur untuk decision tree
ev_no_action = 0.72 * (-ltv) + 0.28 * 0

# Email: probabilitas churn berkurang 10%
p_churn_email = 0.72 * (1 - 0.10)
ev_email = p_churn_email * (-ltv - 20_000) + (1 - p_churn_email) * (-20_000)

print(f"EV Tidak aksi: Rp {ev_no_action:,.0f}")
print(f"EV Email     : Rp {ev_email:,.0f}")
print(f"\n→ Decision tree memilih: {'Email' if ev_email > ev_no_action else 'Tidak aksi'}")
```
::: {.callout-tip}
**Backward induction adalah kunci.** Untuk pohon yang lebih dalam, hitung expected value di **node paling kanan** dulu, lalu gunakan itu sebagai payoff untuk node di sebelah kirinya. Prinsip: **setiap node keputusan memilih alternatif dengan EV tertinggi**—ini adalah asumsi rasionalitas yang mendasari decision tree.
:::
## Nilai Informasi: Seberapa Berharga Informasi Tambahan?
Salah satu pertanyaan paling penting dalam analisis keputusan adalah: **berapa nilai informasi tambahan?** Jika kita bisa mengetahui dengan pasti apakah pelanggan akan churn, berapa nilai informasi itu?
### Expected Value of Perfect Information (EVPI)
**EVPI** = selisih antara expected value **dengan** informasi sempurna dan expected value **tanpa** informasi sempurna.
```{python}
#| label: evpi
# EV dengan informasi sempurna:
#   - jika kita TAHU pelanggan akan churn, kita pilih intervensi terbaik untuk churn
#   - jika kita TAHU pelanggan tidak akan churn, kita pilih no action (biaya 0)
ev_with_perfect_info = (
    p_churn * max(payoff_df["Payoff jika CHURN"]) +
    (1 - p_churn) * max(payoff_df["Payoff jika TIDAK CHURN"])
)

ev_without_info = ev_df.iloc[0]["Expected Value"]

evpi = ev_with_perfect_info - ev_without_info

print(f"EV tanpa informasi    : Rp {ev_without_info:,.0f}")
print(f"EV dengan info sempurna: Rp {ev_with_perfect_info:,.0f}")
print(f"EVPI                  : Rp {evpi:,.0f}")
print(f"\nInterpretasi: Informasi sempurna bernilai hingga Rp {evpi:,.0f}")
print(f"Jika biaya untuk mendapatkan informasi ini (mis. survei) < Rp {evpi:,.0f},")
print(f"maka informasi tersebut layak dibeli.")
```
**Interpretasi:** EVPI adalah **batas atas** nilai informasi apa pun tentang keadaan. Jika EVPI = Rp 200.000, maka informasi sempurna tentang apakah pelanggan akan churn **tidak layak** dibeli jika harganya > Rp 200.000. Ini penting untuk keputusan seperti **riset pasar**, **survei pelanggan**, atau **pengumpulan data tambahan**.
### Expected Value of Sample Information (EVSI)
**EVSI** adalah nilai informasi dari **sampel**—yang tidak sempurna, tetapi lebih baik dari tidak ada. Contoh: kita bisa mengirim survei singkat untuk memperkirakan probabilitas churn dengan lebih baik.
```{python}
#| label: evsi
# Contoh: survei dengan akurasi 80%
# Probabilitas survei benar jika pelanggan churn: 0.80
# Probabilitas survei benar jika pelanggan tidak churn: 0.80
sensitivity = 0.80
specificity = 0.80

# P(survei bilang churn)
p_survey_churn = sensitivity * p_churn + (1 - specificity) * (1 - p_churn)
# P(churn | survei bilang churn) — Bayes
p_churn_given_survey_churn = (sensitivity * p_churn) / p_survey_churn

# EV jika survei bilang churn: pilih intervensi terbaik untuk churn
ev_survey_churn = max(
    p_churn_given_survey_churn * payoff_df.loc[i, "Payoff jika CHURN"] +
    (1 - p_churn_given_survey_churn) * payoff_df.loc[i, "Payoff jika TIDAK CHURN"]
    for i in payoff_df.index
)

# P(survei bilang tidak churn)
p_survey_no_churn = (1 - sensitivity) * p_churn + specificity * (1 - p_churn)
# P(churn | survei bilang tidak churn)
p_churn_given_survey_no_churn = ((1 - sensitivity) * p_churn) / p_survey_no_churn

ev_survey_no_churn = max(
    p_churn_given_survey_no_churn * payoff_df.loc[i, "Payoff jika CHURN"] +
    (1 - p_churn_given_survey_no_churn) * payoff_df.loc[i, "Payoff jika TIDAK CHURN"]
    for i in payoff_df.index
)

ev_with_survey = p_survey_churn * ev_survey_churn + p_survey_no_churn * ev_survey_no_churn
evsi = ev_with_survey - ev_without_info

print(f"EV dengan survei: Rp {ev_with_survey:,.0f}")
print(f"EVSI (nilai survei): Rp {evsi:,.0f}")
print(f"EVPI (batas atas) : Rp {evpi:,.0f}")
print(f"\nEVSI < EVPI: {evsi < evpi} (harus selalu benar—info sampel tidak sesempurna info sempurna)")
```
::: {.callout-important}
**Hubungan EVPI, EVSI, dan keputusan.** Tiga prinsip penting:
1. **EVPI adalah batas atas.** Tidak ada informasi—bahkan sampel sempurna—yang bernilai lebih dari EVPI.
2. **EVSI ≤ EVPI.** Informasi sampel tidak sesempurna informasi sempurna, jadi nilainya lebih rendah.
3. **Informasi hanya berharga jika mengubah keputusan.** Jika EVSI = 0, berarti informasi tambahan tidak akan mengubah keputusan apa pun—jadi tidak layak dibeli, bahkan jika gratis (karena memakan waktu).
**Ini adalah alat yang sangat kuat untuk keputusan investasi data.** Jika biaya pengumpulan data > EVPI, jangan kumpulkan. Jika biaya < EVSI, kumpulkan. Jika di antaranya, pertimbangkan trade-off.
:::
## Menghubungkan Kembali ke Model Prediktif
Sekarang saatnya menghubungkan kerangka keputusan ini ke model prediktif dari Bagian II.
### Probabilitas Churn sebagai Input
Di Bab 9, kita membangun model yang **memprediksi probabilitas churn per pelanggan**. Probabilitas ini adalah **input langsung** untuk analisis keputusan:
```{python}
#| label: bridge-prediction
# Simulasi: ambil 100 pelanggan dengan probabilitas churn bervariasi
# (dalam praktik, ini berasal dari model Bab 9)
pelanggan = pd.DataFrame({
    "pelanggan_id": [f"P{i:03d}" for i in range(100)],
    "prob_churn": np.random.beta(2, 5, 100),  # distribusi realistis
    "monthly_charge": np.random.uniform(50_000, 150_000, 100),
})

# Hitung expected value retensi untuk setiap pelanggan
def expected_value_intervention(row, intervention):
    p = row["prob_churn"]
    cost = intervention["cost"]
    eff = intervention["effectiveness"]
    ltv = row["monthly_charge"] * 12
    p_after = p * (1 - eff)
    ev = p_after * (-ltv - cost) + (1 - p_after) * (-cost)
    return ev

# Bandingkan no action vs email vs diskon
for name, params in interventions.items():
    pelanggan[f"EV_{name}"] = pelanggan.apply(
        lambda row: expected_value_intervention(row, params), axis=1
    )

# Pilih intervensi terbaik per pelanggan
pelanggan["best_action"] = pelanggan[
    [f"EV_{name}" for name in interventions.keys()]
].idxmax(axis=1).str.replace("EV_", "")

pelanggan["best_action"].value_counts()
```
::: {.callout-important}
**Ini adalah prescriptive analytics dalam bentuk paling sederhana.** Kita tidak hanya memprediksi probabilitas churn—kita menggunakan probabilitas itu untuk memilih **tindakan optimal** untuk setiap pelanggan, berdasarkan biaya, efektivitas, dan nilai pelanggan.
Tetapi ini masih **belum cukup** untuk keputusan nyata:
1. **Anggaran terbatas.** Kita tidak bisa menghubungi semua pelanggan. Kita perlu memilih subset optimal di bawah kendala anggaran—ini adalah **optimasi**, topik Bab 14–15.
2. **Interaksi antar keputusan.** Jika kita menghubungi pelanggan A, apakah itu memengaruhi pelanggan B? (Mis. rekomendasi word-of-mouth). Ini adalah topik **network optimization** di Bab 16.
3. **Ketidakpastian hasil.** Efektivitas intervensi tidak pasti. Kita perlu **simulasi** untuk mengevaluasi keputusan di bawah ketidakpastian—topik Bab 17.
**Bab 14–17 akan memperluas kerangka ini** dari keputusan per pelanggan menjadi keputusan **portofolio** di bawah kendala.
:::
## Dari Payoff Table ke Optimasi
Payoff table di atas menjawab: *"Apa intervensi terbaik untuk **satu** pelanggan?"* Tetapi keputusan bisnis nyata selalu melibatkan **banyak pelanggan** dan **sumber daya terbatas**.
### Contoh: Alokasi Anggaran Retensi
Bayangkan kita memiliki **1.000 pelanggan** dengan probabilitas churn dan nilai yang berbeda-beda, dan **anggaran Rp 50 juta**. Kita ingin memilih subset pelanggan untuk diintervensi agar **total expected value** maksimal.
Ini adalah masalah **knapsack** (atau **integer programming**)—dan merupakan inti dari Bab 15. Tetapi kita bisa melihat versi sederhananya di sini:
```{python}
#| label: allocation-preview
# Simulasi: 100 pelanggan, anggaran terbatas
np.random.seed(42)
n = 100
anggaran = 5_000_000  # Rp 5 juta
biaya_intervensi = 100_000  # Rp 100.000 per pelanggan

pelanggan = pd.DataFrame({
    "prob_churn": np.random.beta(2, 5, n),
    "monthly_charge": np.random.uniform(50_000, 150_000, n),
})
pelanggan["ltv"] = pelanggan["monthly_charge"] * 12
pelanggan["expected_loss"] = pelanggan["prob_churn"] * pelanggan["ltv"]

# Intervensi mengurangi probabilitas churn 30% (relatif)
# Expected benefit = pengurangan probabilitas × LTV
pelanggan["expected_benefit"] = pelanggan["prob_churn"] * 0.30 * pelanggan["ltv"]
pelanggan["net_benefit"] = pelanggan["expected_benefit"] - biaya_intervensi

# Strategi naif: intervensi pelanggan dengan expected_loss tertinggi
pelanggan_sorted = pelanggan.sort_values("expected_loss", ascending=False)
n_affordable = anggaran // biaya_intervensi
selected_naive = pelanggan_sorted.head(n_affordable)

# Strategi lebih baik: intervensi pelanggan dengan net_benefit tertinggi (jika positif)
pelanggan_sorted_benefit = pelanggan[pelanggan["net_benefit"] > 0].sort_values("net_benefit", ascending=False)
selected_better = pelanggan_sorted_benefit.head(n_affordable)

print(f"Anggaran        : Rp {anggaran:,.0f}")
print(f"Biaya/intervensi: Rp {biaya_intervensi:,.0f}")
print(f"Kapasitas       : {n_affordable} pelanggan")
print()
print(f"Strategi naif (expected_loss tertinggi):")
print(f"  Total net benefit: Rp {selected_naive['net_benefit'].sum():,.0f}")
print(f"Strategi lebih baik (net benefit tertinggi):")
print(f"  Total net benefit: Rp {selected_better['net_benefit'].sum():,.0f}")
```
**Perhatikan:** strategi yang memilih berdasarkan **expected_loss** (probabilitas × nilai) **tidak selalu optimal**. Strategi yang memilih berdasarkan **net_benefit** (benefit - biaya) bisa lebih baik—bahkan jika beberapa pelanggan dengan expected loss tinggi **tidak** dipilih karena biaya intervensi melebihi manfaatnya.
::: {.callout-tip}
**Ini adalah pelajaran inti Bagian III.** Keputusan optimal bukan tentang memilih pelanggan dengan risiko tertinggi, atau nilai tertinggi, atau probabilitas tertinggi—tetapi tentang **memaksimalkan manfaat bersih di bawah kendala**. Ini membutuhkan **optimasi**, bukan sekadar ranking.
:::
## Latihan Terbimbing
**Latihan 13.1 — Payoff table untuk konteks berbeda.**
Bayangkan kita adalah manajer toko retail yang memutuskan berapa banyak stok produk untuk dipesan. Buat payoff table dengan tiga alternatif (stok rendah, sedang, tinggi) dan tiga keadaan (permintaan rendah, sedang, tinggi). Gunakan angka yang masuk akal untuk biaya stockout dan holding.
**Latihan 13.2 — Perbandingan kriteria.**
Untuk payoff table di Latihan 13.1, hitung alternatif yang dipilih oleh maximin, maximax, minimax regret, dan expected value (asumsikan probabilitas keadaan: 0,3 / 0,4 / 0,3). Apakah keempat kriteria memilih alternatif yang sama? Jika tidak, mengapa?
**Latihan 13.3 — EVPI untuk keputusan stok.**
Hitung EVPI untuk payoff table di Latihan 13.1. Jika biaya untuk mendapatkan forecast permintaan yang sempurna adalah Rp 5 juta, apakah layak? Jelaskan.
**Latihan 13.4 — Decision tree.**
Gambarkan decision tree untuk keputusan **dua tahap** di mana kita dapat memilih untuk mengirim email (biaya Rp 20.000, efektivitas 20%) dan kemudian, jika pelanggan masih berisiko, memutuskan untuk menawarkan diskon (biaya Rp 100.000, efektivitas tambahan 30%). Hitung expected value dengan backward induction.
**Latihan 13.5 — EVSI dengan sensitivitas berbeda.**
Untuk model survei di atas, hitung EVSI jika sensitivitas dan spesifisitas survei adalah 0,60, 0,70, 0,80, dan 0,90. Plot EVSI vs akurasi survei. Apakah ada titik di mana EVSI = 0? Jika ya, mengapa?
**Latihan 13.6 — Hubungkan ke model prediktif.**
Ambil model klasifikasi dari Bab 9 (atau gunakan simulasi probabilitas). Buat payoff table untuk 10 pelanggan dengan probabilitas churn dan nilai yang berbeda. Tentukan intervensi optimal untuk masing-masing menggunakan expected value. Berapa total net benefit jika kita hanya bisa mengintervensi 5 pelanggan dengan anggaran terbatas?
::: {.callout-note collapse="true"}
**Petunjuk Latihan 13.3.** EVPI = EV dengan informasi sempurna - EV tanpa informasi. Untuk menghitung EV dengan informasi sempurna, asumsikan kita **tahu** keadaan sebelum memutuskan—sehingga kita selalu memilih alternatif terbaik **untuk keadaan itu**. Ini adalah batas atas nilai informasi.
:::
## Kotak "Jembatan": Dari Keputusan ke Optimasi
::: {.callout-important}
**Jembatan.** Bab ini memberi kita **bahasa keputusan**—cara memformalkan masalah, mengevaluasi alternatif, dan mengukur nilai informasi. Ini adalah fondasi yang akan dipakai di seluruh Bagian III:
1. **Payoff table** akan menjadi **tabel parameter** dalam model optimasi: setiap kombinasi keputusan × keadaan memiliki nilai yang dapat dihitung.
2. **Decision tree** akan menjadi **struktur** untuk keputusan berurutan—terutama ketika informasi baru tersedia di antara keputusan.
3. **EVPI dan EVSI** akan menjadi **panduan investasi data**: berapa nilai informasi tambahan, dan apakah layak membelinya.
Tetapi bab ini masih memiliki **batasan besar**: kita hanya mempertimbangkan **satu keputusan pada satu waktu**, atau sejumlah kecil alternatif yang dapat dihitung secara manual. Untuk keputusan nyata—dengan ratusan pelanggan, puluhan intervensi, dan lusinan kendala—kita membutuhkan **optimasi matematis**.
**Bab 14—Linear Programming**—akan memperkenalkan teknik optimasi paling fundamental: memaksimalkan atau meminimalkan fungsi tujuan linear di bawah kendala linear. Ini adalah fondasi dari semua teknik optimasi yang lebih kompleks, dan akan langsung kita terapkan untuk **alokasi anggaran retensi** dan **optimasi portofolio produk**.
Dengan kata lain: **bab ini mengajarkan kita cara berpikir tentang keputusan; bab berikutnya mengajarkan kita cara menghitungnya pada skala nyata.**
:::
## Rangkuman
Dalam bab ini kita telah:
- **Membedakan prediksi dari keputusan**, memahami bahwa prediksi yang akurat tidak otomatis menjadi keputusan yang baik—keputusan membutuhkan kerangka yang mempertimbangkan biaya, manfaat, dan ketidakpastian.
- **Menguraikan masalah keputusan** menjadi lima komponen: alternatif, keadaan, probabilitas, hasil, dan kriteria.
- **Membangun payoff table** untuk memformalkan keputusan retensi pelanggan.
- **Menerapkan empat kriteria keputusan**—maximin, maximax, minimax regret, expected value—dan memahami bahwa masing-masing mencerminkan sikap berbeda terhadap risiko.
- **Menggambar decision tree** untuk keputusan berurutan dan menerapkan backward induction untuk evaluasi.
- **Menghitung EVPI dan EVSI** untuk mengukur nilai informasi—dan memahami bahwa informasi hanya berharga jika mengubah keputusan.
- **Menghubungkan model prediktif dari Bagian II** ke kerangka keputusan: probabilitas churn menjadi input untuk analisis payoff.
- **Menyadari batas analisis keputusan manual**: untuk keputusan berskala besar dengan banyak pelanggan dan kendala, kita membutuhkan **optimasi matematis**—topik Bab 14–17.
## Jembatan ke Bab 14
Kita memiliki kerangka keputusan. Kita memiliki payoff table. Kita memiliki model prediktif yang memberi kita probabilitas. Tetapi kita **belum memiliki alat** untuk mengoptimalkan keputusan pada skala nyata.
**Bab 14—Linear Programming**—akan mengisi kekosongan ini. Kita akan mempelajari:
- **Formulasi model**: variabel keputusan, fungsi tujuan, kendala.
- **Solusi grafis** untuk masalah dua variabel—untuk membangun intuisi.
- **Metode simpleks** (secara konseptual) dan implementasi dengan `PuLP`.
- **Aplikasi langsung**:
- Alokasi anggaran retensi ke berbagai segmen.
- Optimasi portofolio produk (berapa banyak setiap produk diproduksi).
- Alokasi sumber daya (staf, waktu, mesin).
Linear programming adalah **fondasi** dari semua teknik optimasi yang lebih kompleks—integer programming (Bab 15), network optimization (Bab 16), dan simulasi keputusan (Bab 17). Menguasainya adalah kunci untuk membuka seluruh Bagian III.