---
jupyter: decanal
---
# Fondasi Decision Analytics {#sec-fondasi}
::: {.callout-note appearance="simple"}
**Tujuan pembelajaran.** Setelah menyelesaikan bab ini, kita akan mampu:
1. Menyiapkan dan memverifikasi lingkungan Python yang digunakan sepanjang buku.
2. Memahami struktur data inti `pandas`—`Series` dan `DataFrame`—serta kapan menggunakannya.
3. Memuat dataset pendamping dan melakukan inspeksi awal yang sistematis.
4. Membedakan tipe data dan memahami mengapa tipe yang tepat penting untuk analisis selanjutnya.
:::
## Mengapa Fondasi?
Sebelum kita dapat memprediksi atau mengoptimalkan apa pun, kita perlu **memegang data dengan benar**. Di dunia nyata, sebagian besar waktu seorang analis dihabiskan bukan untuk membangun model, melainkan untuk memastikan data yang masuk ke model tersebut dapat dipercaya. Bab ini membangun kebiasaan itu sejak awal.
::: {.callout-tip}
Jika kita sudah berpengalaman dengan Python dan `pandas`, kita dapat membaca cepat bab ini dan langsung ke Bab 2. Namun tetap perhatikan **Bagian 1.5** (dataset pendamping) karena konvensi yang diperkenalkan di sana akan dipakai di seluruh buku.
:::
## Menyiapkan Lingkungan Python
Buku ini menggunakan environment Conda bernama `decanal` yang telah disiapkan sebelumnya (lihat `README.md` pada repositori buku). Jika kita mengikuti dari awal, pastikan environment tersebut aktif:
```bash
conda activate decanal
```
kita dapat memverifikasi bahwa semua paket inti tersedia dengan menjalankan blok berikut. Jika ada paket yang hilang, jalankan `pip install -r requirements.txt` dari root proyek.
```{python}
#| label: check-env
#| echo: true
import sys
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns

print(f"Python  : {sys.version.split()[0]}")
print(f"pandas  : {pd.__version__}")
print(f"numpy   : {np.__version__}")
```
kita juga dapat memeriksa bahwa eksekusi benar-benar terjadi di environment `decanal`:
```{python}
#| label: check-kernel
import sys
print(sys.executable)
```
Jika path yang dicetak mengarah ke `.../envs/decanal/bin/python` (Linux/macOS) atau `...\envs\decanal\python.exe` (Windows), kita siap melanjutkan.
::: {.callout-note}
Sepanjang buku, blok kode diberi opsi `#| label:` agar dapat direferensikan silang dan direproduksi. Opsi `#| echo: true` menampilkan kode di buku; `#| echo: false` menyembunyikannya tetapi tetap menjalankannya. kita tidak perlu menghafal ini sekarang—akan diperkenalkan bertahap.
:::
Cara paling andal agar Quarto secara otomatis menggunakan *environment* Python tertentu (seperti `venv` atau `conda`) adalah dengan mendaftarkan *environment* tersebut sebagai kernel Jupyter, lalu mendeklarasikannya di *header* YAML dokumen kita. Berikut adalah beberapa metode yang dapat digunakan untuk melakukan itu:
**Metode 1: Mendaftarkan Environment sebagai Kernel Jupyter (Direkomendasikan)**
Pendekatan ini mengunci dokumen `.qmd` ke *environment* yang spesifik, sehingga siapapun yang merender dokumen (yang memiliki kernel dengan nama sama) akan menggunakan dependensi yang tepat.
```yaml
---
title: "Analisis Data dengan Python"
jupyter: quarto_env
---
```
**Metode 2: Menggunakan Ekstensi VS Code**
Jika kita menulis dan merender Quarto menggunakan Visual Studio Code (dengan ekstensi Quarto terinstal), kita bisa memanfaatkan deteksi *interpreter* bawaan VS Code.
1. Tekan `Ctrl + Shift + P` (atau `Cmd + Shift + P` di Mac).
2. Ketik dan pilih **Python: Select Interpreter**.
3. Pilih *environment* (Conda/Venv) yang sesuai untuk proyek kita.
4. Saat kita mengeklik tombol **Render** di VS Code, Quarto akan secara otomatis mengeksekusi kode menggunakan *environment* Python yang terpilih tersebut tanpa perlu mengubah YAML.
**Metode 3: Pewarisan Terminal (CLI)**
Jika kita mengeksekusi Quarto murni dari *Command Line* tanpa menyetel nama kernel di YAML:
* Quarto dirancang untuk langsung mendeteksi `python` yang berjalan di path terminal kita.
* Aktifkan *environment* kita di terminal (misal: `conda activate myenv`).
* Jalankan perintah `quarto preview nama_file.qmd` atau `quarto render`. Quarto akan otomatis menggunakan *environment* yang sedang aktif.
**Metode 4: Khusus Pengguna Engine Knitr (Kombinasi R dan Python)**
Jika dokumen kita menggunakan *engine* `knitr` (R) sebagai dasar, namun berisi *chunk* Python (via paket `reticulate`), kita harus memberi tahu R *environment* mana yang harus digunakan. Tambahkan *chunk* R ini di awal dokumen `.qmd` kita:
```r
#| include: false
library(reticulate)
use_virtualenv("./nama_env", required = TRUE)
# atau gunakan: use_condaenv("nama_env", required = TRUE)
```
Jika cara-cara itu belum berhasil, mungkin kita perlu melakukan ini:
**Hapus Cache Eksekusi Quarto**
Terkadang Quarto menggunakan hasil eksekusi lama yang tersimpan di cache, sehingga perubahan konfigurasi tidak langsung terlihat.
- Hapus folder `_freeze` (jika ada) di direktori proyek kita.
- Atau, jalankan render melalui terminal dengan perintah:
```Bash
quarto render nama_file.qmd --execute-cache-clear
```
## Struktur Data Inti: `Series` dan `DataFrame`
`pandas` menyediakan dua struktur data yang menjadi tulang punggung hampir semua analisis di buku ini:
| Struktur | Dimensi | Analogi | Penggunaan khas |
|---|---|---|---|
| **`Series`** | 1D | Satu kolom dengan indeks | Satu variabel, satu urutan waktu, hasil agregasi |
| **`DataFrame`** | 2D | Tabel dengan baris & kolom | Seluruh dataset, hasil penggabungan, matriks fitur |
Mari kita lihat keduanya secara langsung.
```{python}
#| label: series-demo
import pandas as pd

# Series: satu variabel dengan indeks
penjualan_harian = pd.Series([120, 135, 118, 150, 142],
                              index=["Sen", "Sel", "Rab", "Kam", "Jum"],
                              name="penjualan")
penjualan_harian
```
```{python}
#| label: dataframe-demo
# DataFrame: kumpulan Series yang berbagi indeks
toko = pd.DataFrame({
    "kota": ["Jakarta", "Bandung", "Surabaya", "Medan"],
    "jumlah_karyawan": [45, 22, 30, 18],
    "pendapatan_juta": [1200, 560, 780, 420],
})
toko
```
Operasi dasar yang akan sering kita gunakan:
```{python}
#| label: basic-ops
print("--- Bentuk (baris, kolom) ---")
print(toko.shape)

print("\n--- Nama kolom ---")
print(toko.columns.tolist())

print("\n--- Tipe data per kolom ---")
print(toko.dtypes)

print("\n--- Akses satu kolom (Series) ---")
print(toko["pendapatan_juta"])

print("\n--- Ringkasan statistik ---")
toko.describe()
```
::: {.callout-tip}
**Aturan praktis.** Jika kita membutuhkan satu variabel, gunakan `Series`. Jika kita membutuhkan tabel, gunakan `DataFrame`. Hampir semua operasi agregasi (`groupby`, `mean`, `sum`) mengembalikan `Series`, dan hampir semua operasi penggabungan mengembalikan `DataFrame`.
:::
## Tipe Data dan Mengapa Ia Penting
Salah satu kesalahan paling umum pemula adalah **mengabaikan tipe data**. `pandas` memberi setiap kolom sebuah *dtype*, dan tipe yang salah akan menyebabkan analisis yang salah—sering tanpa error sama sekali.
| Kelompok dtype | Contoh | Konsekuensi jika salah |
|---|---|---|
| **Numerik** (`int64`, `float64`) | `usia=34`, `harga=2.5e6` | Operasi statistik gagal atau menghasilkan `NaN` |
| **Boolean** (`bool`) | `is_active=True` | Perbandingan logika tidak berjalan |
| **Kategorikal** (`category`) | `kota="Jakarta"` | Mengonsumsi memori besar & memperlambat grouping |
| **Object** (`object`) | Campuran string dan angka | Sering menjadi tanda data kotor |
| **Datetime** (`datetime64`) | `waktu="2025-01-01"` | Analisis time series tidak mungkin dilakukan |
::: {.callout-warning}
Kolom numerik yang **terbaca sebagai string** adalah salah satu jebakan paling umum. Ini sering terjadi ketika file CSV memuat angka dengan pemisah ribuan (misalnya `"1,200"`) atau simbol mata uang (`"Rp 1.200"`). Selalu periksa `dtypes` setelah memuat dataset.
:::
Untuk mengonversi tipe data secara eksplisit:
```{python}
#| label: convert-dtype
contoh = pd.DataFrame({
    "harga_str": ["1,200", "560", "780"],
    "tanggal_str": ["2025-01-01", "2025-01-02", "2025-01-03"],
    "kategori_str": ["A", "B", "A"],
})

contoh["harga"] = (
    contoh["harga_str"].str.replace(",", "", regex=False).astype(float)
)
contoh["tanggal"] = pd.to_datetime(contoh["tanggal_str"])
contoh["kategori"] = contoh["kategori_str"].astype("category")

contoh[["harga", "tanggal", "kategori"]].dtypes
```
## Memuat Dataset Pendamping
Seluruh buku ini menggunakan **satu dataset pendamping**: *Telco Customer Churn*—data pelanggan perusahaan telekomunikasi dengan label biner `Churn` (berhenti berlangganan atau tidak). Dataset ini ideal untuk buku kita karena:
- Memiliki **variabel numerik** (tenure, monthly charges, total charges).
- Memiliki **variabel kategorikal** (kontrak, layanan internet, metode pembayaran).
- Memiliki **target biner** yang memungkinkan klasifikasi prediktif.
- Memiliki **struktur waktu** (tenure dalam bulan) yang memungkinkan analisis survival dan time series sederhana.
- Memiliki **makna bisnis langsung** yang memungkinkan perumusan model optimasi di Bagian III.
Dataset tersedia di folder `data/raw/telco_churn.csv` pada repositori buku. Jika kita belum mengunduhnya, jalankan blok berikut untuk mengunduh ke folder `data/raw/`:
```{python}
#| label: download-data
#| eval: false
from pathlib import Path
import urllib.request

URL = ("https://raw.githubusercontent.com/IBM/telco-customer-churn-on-icp4d/"
       "master/data/Telco-Customer-Churn.csv")
target = Path("data/raw/telco_churn.csv")
target.parent.mkdir(parents=True, exist_ok=True)
urllib.request.urlretrieve(URL, target)
print(f"Dataset tersimpan di {target.resolve()}")
```
::: {.callout-note}
Blok di atas diberi `#| eval: false` karena tidak perlu dijalankan ulang setiap kali buku dirender—cukup sekali. Setelah file ada di `data/raw/`, blok-blok berikutnya akan memuatnya dari disk.
:::
Sekarang muat dataset:
```{python}
#| label: load-churn
from pathlib import Path
import pandas as pd

DATA_PATH = Path("data/raw/telco_churn.csv")
df = pd.read_csv(DATA_PATH)

print(f"Bentuk dataset: {df.shape[0]} baris × {df.shape[1]} kolom")
```
## Inspeksi Awal: Lima Langkah Sistematis
Setiap kali kita menerima dataset baru—baik dari repositori publik maupun dari klien—jalankan **lima langkah inspeksi** berikut sebelum melakukan apa pun. Kebiasaan ini akan menyelamatkan kita dari banyak masalah di kemudian hari.
### Langkah 1 — Lihat Bentuk dan Kolom
```{python}
#| label: inspect-shape
print(f"Baris  : {df.shape[0]:,}")
print(f"Kolom  : {df.shape[1]}")
print(f"\nKolom-kolom: {df.columns.tolist()}")
```
### Langkah 2 — Periksa Tipe Data
```{python}
#| label: inspect-dtypes
df.dtypes
```
Perhatikan kolom `TotalCharges`—secara logis ia seharusnya numerik (total tagihan), tetapi sering terbaca sebagai `object` karena ada nilai kosong yang direpresentasikan sebagai string `" "`. Kita akan membahas ini di Bab 2 (wrangling), tetapi catat dulu bahwa **ini adalah masalah yang akan kita selesaikan**.
### Langkah 3 — Lihat Beberapa Baris Pertama
```{python}
#| label: inspect-head
df.head()
```
### Langkah 4 — Nilai Hilang
```{python}
#| label: inspect-missing
missing = df.isna().sum().sort_values(ascending=False)
missing[missing > 0]
```
Jika hasilnya kosong (atau hanya sedikit), kita beruntung. Pada dataset ini, `NaN` dari `isna()` mungkin tidak menangkap nilai kosong yang direpresentasikan sebagai string. Kita akan melihat cara yang lebih komprehensif di Bab 2.
### Langkah 5 — Ringkasan Statistik & Distribusi Kategorikal
```{python}
#| label: inspect-numeric-summary
df.describe()
```
```{python}
#| label: inspect-categorical
for col in ["gender", "Contract", "InternetService", "Churn"]:
    if col in df.columns:
        print(f"\n--- {col} ---")
        print(df[col].value_counts(dropna=False))
```
::: {.callout-tip}
**Ringkasan lima langkah.**
1. **Bentuk & kolom** — apa yang kita punya?
2. **Tipe data** — apakah tipe sesuai dengan makna logis?
3. **Cuplikan data** — apakah nilainya masuk akal?
4. **Nilai hilang** — di mana data bolong?
5. **Distribusi** — apakah sebarannya wajar, atau ada outlier ekstrem?
Jalankan kelima langkah ini setiap kali membuka dataset baru, bahkan sebelum membaca dokumentasinya. Sering kali kita akan menemukan anomali yang tidak disebutkan dalam dokumentasi.
:::
## Variabel Target dan Variabel Fitur
Karena dataset ini akan digunakan untuk klasifikasi prediktif di Bagian II, kita perlu membedakan **variabel target** dari **variabel fitur** sejak awal.
- **Target**: kolom `Churn` (biner: `Yes`/`No`). Inilah yang akan kita coba prediksi.
- **Fitur**: semua kolom lain yang berpotensi informatif tentang target.
```{python}
#| label: target-distribution
churn_counts = df["Churn"].value_counts()
churn_pct = df["Churn"].value_counts(normalize=True).mul(100).round(2)

pd.DataFrame({"jumlah": churn_counts, "persentase (%)": churn_pct})
```
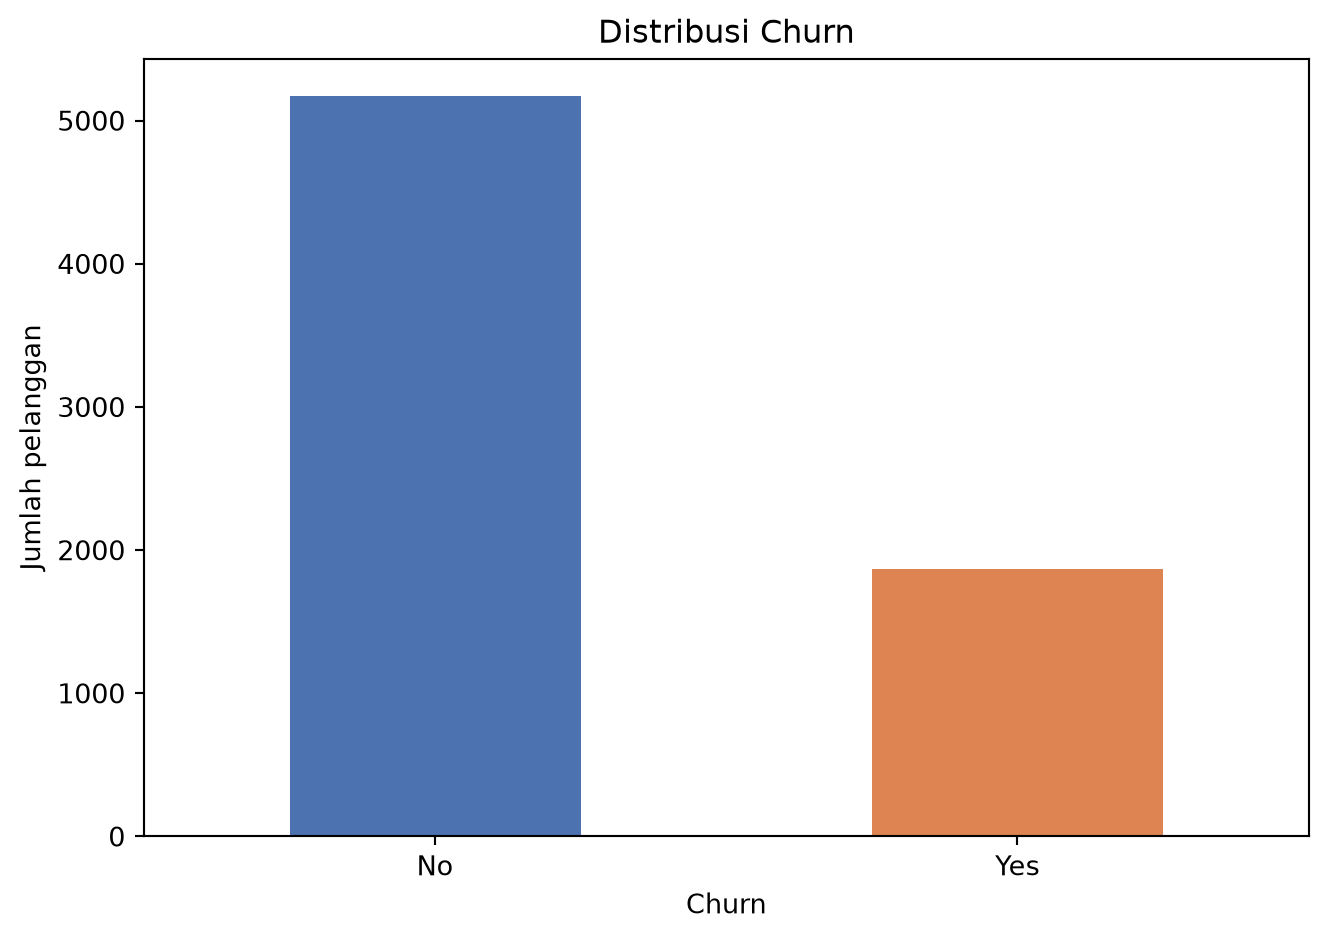
Distribusi kelas pada dataset ini tidak seimbang—sekitar seperempat pelanggan churn. Ini adalah pola yang khas di dunia nyata dan akan menjadi pertimbangan penting ketika kita memilih metrik evaluasi di Bab 9.
```{python}
#| label: fig-target-dist
#| fig-cap: "Distribusi variabel target Churn."
#| fig-width: 6
#| fig-height: 3.5
import matplotlib.pyplot as plt

ax = df["Churn"].value_counts().plot(kind="bar", color=["#4C72B0", "#DD8452"])
ax.set_title("Distribusi Churn")
ax.set_xlabel("Churn")
ax.set_ylabel("Jumlah pelanggan")
ax.set_xticklabels(["No", "Yes"], rotation=0)
plt.tight_layout()
plt.show()
```
## Konvensi Dataset untuk Buku Ini
Untuk menjaga konsistensi di seluruh bab, tetapkan konvensi berikut dan jangan mengubahnya:
| Konvensi | Nilai |
|---|---|
| Nama variabel `DataFrame` utama | `df` |
| Nama variabel target | `y` (Series) |
| Nama matriks fitur | `X` (DataFrame) |
| Path dataset mentah | `data/raw/telco_churn.csv` |
| Path dataset bersih | `data/processed/telco_clean.csv` |
| `random_state` bawaan | `42` |
::: {.callout-note}
**Mengapa `random_state=42`?** Karena kita ingin hasil dapat direproduksi—kita, pembaca lain, dan CI/CD kita harus mendapatkan angka yang identik setiap kali buku dirender. Angka 42 hanyalah konvensi populer; yang penting adalah **konsisten di seluruh buku**.
:::
Untuk menghindari duplikasi kode pemuatan, kita bisa membuat helper kecil di `code/utils.py`:
```{python}
#| label: utils-demo
#| eval: false
# code/utils.py
from pathlib import Path
import pandas as pd

DATA_DIR = Path("data")

def load_churn() -> pd.DataFrame:
    """Dataset pendamping buku Decision Analytics."""
    return pd.read_csv(DATA_DIR / "raw" / "telco_churn.csv")

def load_churn_clean() -> pd.DataFrame:
    """Dataset bersih hasil Bab 2."""
    return pd.read_csv(DATA_DIR / "processed" / "telco_clean.csv")
```
Di bab-bab selanjutnya, kita akan memuat data dengan:
```python
import sys; sys.path.append(".")
from code.utils import load_churn
df = load_churn()
```
::: {.callout-tip}
Membuat helper seperti di atas mungkin terasa berlebihan untuk satu dataset. Tetapi ketika buku kita memiliki 18 bab yang semuanya memuat dataset yang sama, **satu titik perubahan** (misalnya jika path atau nama file berubah) jauh lebih mudah dikelola daripada mengedit 18 file.
:::
## Latihan Terbimbing
Kerjakan latihan berikut langsung di notebook kita. Solusi tersedia di folder `solutions/` pada repositori buku.
**Latihan 1.1 — Inspeksi mandiri.**
Muat dataset dengan `pd.read_csv("data/raw/telco_churn.csv")`. Jawab pertanyaan berikut **tanpa** melihat jawaban di bawah:
- Berapa banyak baris dan kolom?
- Kolom mana saja yang bertipe `object`?
- Kolom mana yang seharusnya numerik tetapi bertipe `object`?
- Apakah ada kolom dengan nilai kosong (`NaN`)?
**Latihan 1.2 — Konversi tipe.**
Kolom `TotalCharges` seharusnya bertipe numerik. Lakukan:
```python
df["TotalCharges"] = pd.to_numeric(df["TotalCharges"], errors="coerce")
```
Kemudian periksa berapa banyak nilai yang berubah menjadi `NaN`. Mengapa hal ini terjadi? (Petunjuk: periksa nilai unik yang bukan angka.)
**Latihan 1.3 — Distribusi kategorikal.**
Untuk setiap kolom kategorikal (`dtype == "object"`), tampilkan `value_counts()`. Kolom mana yang memiliki **kardinalitas tinggi** (banyak nilai unik)? Mengapa kolom seperti `customerID` **tidak** boleh dimasukkan sebagai fitur dalam model prediktif?
**Latihan 1.4 — Series vs DataFrame.**
Jelaskan mengapa `df["tenure"]` mengembalikan `Series` sedangkan `df[["tenure"]]` mengembalikan `DataFrame`. Dalam situasi apa kita membutuhkan yang kedua?
::: {.callout-note collapse="true"}
**Petunjuk Latihan 1.2.** Kolom `TotalCharges` memuat string kosong `" "` (satu spasi) untuk pelanggan baru dengan `tenure = 0`. `pd.to_numeric` dengan `errors="coerce"` akan mengubah string tersebut menjadi `NaN`, yang secara semantik **benar**—pelanggan baru belum memiliki total tagihan. Ini akan kita tangani secara eksplisit di Bab 2.
:::
## Kotak "Jembatan": Dari Data ke Keputusan
::: {.callout-important}
**Jembatan.** Di akhir setiap bab Bagian I, kotak ini menanyakan: *jika analisis di bab ini benar, keputusan apa yang bisa berubah?*
Bab ini belum menghasilkan insight substantif—ia menghasilkan **fondasi**. Tetapi ia sudah memengaruhi keputusan dengan cara yang halus namun penting:
- **Keputusan tentang data mana yang dipercaya.** Dengan memeriksa tipe data dan nilai hilang sebelum analisis, kita menghindari keputusan yang didasarkan pada kolom `TotalCharges` yang salah tafsir sebagai string.
- **Keputusan tentang apa yang bisa diprediksi.** Dengan memahami distribusi `Churn` (~26% positif), kita sudah dapat mengantisipasi bahwa metrik akurasi sederhana akan menyesatkan—dan memilih metrik yang lebih tepat di Bab 9.
- **Keputusan tentang batas analisis.** Kolom `customerID` adalah pengenal unik, bukan fitur. Mengabaikannya adalah keputusan desain yang mencegah *data leakage* di kemudian hari.
Fondasi yang baik tidak menghasilkan rekomendasi langsung, tetapi ia menentukan apakah rekomendasi di bab-bab selanjutnya dapat dipercaya.
:::
## Rangkuman
Dalam bab ini kita telah:
- **Menyiapkan lingkungan** Python `decanal` dan memverifikasi bahwa semua paket inti tersedia.
- **Memahami dua struktur data inti** `pandas`—`Series` (1D) dan `DataFrame` (2D)—beserta kapan menggunakannya.
- **Membedakan tipe data** dan memahami mengapa tipe yang salah (terutama numerik yang terbaca sebagai `object`) adalah sumber kesalahan yang sering tidak terdeteksi.
- **Memuat dataset pendamping** *Telco Customer Churn* dan menjalankan **lima langkah inspeksi** sistematis: bentuk, tipe, cuplikan, nilai hilang, dan distribusi.
- **Menetapkan konvensi** nama variabel dan path yang akan dipakai konsisten di seluruh buku.
- **Mengidentifikasi dua masalah data** yang akan diselesaikan di Bab 2: kolom `TotalCharges` yang bertipe salah dan nilai kosong yang direpresentasikan sebagai string.
- **Menetapkan target dan fitur** untuk pemodelan prediktif di Bagian II, dengan catatan penting bahwa distribusi kelas tidak seimbang.
## Jembatan ke Bab 2
Dataset yang baru kita muat masih "mentah" dalam banyak hal: tipe data yang salah, nilai hilang yang tersembunyi, kolom yang mungkin tidak informatif, dan skala yang belum seragam. Di bab berikutnya—**Data Wrangling & Manajemen Data**—kita akan membersihkan dataset ini secara sistematis:
- Menangani nilai hilang, baik dengan penghapusan, imputasi, maupun transformasi.
- Mengonversi tipe data yang salah, termasuk `TotalCharges`.
- Mendeteksi dan menangani outlier.
- Menggabungkan data dari beberapa sumber (jika diperlukan).
- Menyimpan dataset bersih ke `data/processed/telco_clean.csv` untuk digunakan di seluruh bab selanjutnya.
Setelah Bab 2 selesai, kita akan memiliki **dataset bersih yang siap dianalisis**—dan itulah fondasi sesungguhnya untuk semua yang akan kita bangun di Bagian II dan III.