---
jupyter: decanal
---
# Unsupervised Learning: Menemukan Struktur Tersembunyi {#sec-unsupervised}
::: {.callout-note appearance="simple"}
**Tujuan pembelajaran.** Setelah menyelesaikan bab ini, kita akan mampu:
1. Membedakan supervised dari unsupervised learning, dan memahami kapan masing-masing tepat digunakan.
2. Menerapkan **K-means clustering** dan memilih jumlah cluster secara sistematis.
3. Menerapkan **hierarchical clustering** dan membaca **dendrogram**.
4. Menggunakan **PCA** untuk mereduksi dimensi dan memvisualisasikan data berdimensi tinggi.
5. Menemukan **association rules** dalam data transaksi (market basket analysis).
6. Menginterpretasikan segmen pelanggan secara bisnis dan menghubungkannya ke keputusan retensi.
7. Memahami mengapa segmentasi adalah **input penting** untuk model optimasi di Bagian III.
:::
## Mengapa Unsupervised Learning?
Sampai Bab 10, semua model kita adalah **supervised**—kita memiliki label (churn/tidak, unit terjual) dan model belajar memprediksi label tersebut. Tetapi tidak semua pertanyaan analytics memiliki label:
- *"Apakah ada kelompok pelanggan alami yang tidak kita ketahui?"*
- *"Fitur mana yang paling penting dalam menjelaskan variasi data?"*
- *"Produk apa yang sering dibeli bersama?"*
Pertanyaan-pertanyaan ini tidak memiliki "jawaban benar" yang dapat dilatih. Kita tidak tahu berapa banyak segmen yang ada, atau segmen mana yang "benar"—kita ingin **menemukan struktur** dari data itu sendiri.
Inilah domain **unsupervised learning**: menemukan pola dalam data **tanpa label**.
::: {.callout-important}
**Tiga kegunaan utama unsupervised learning dalam decision analytics:**
1. **Segmentasi**—mengelompokkan pelanggan/produk ke dalam segmen yang bermakna secara bisnis. Ini adalah input langsung untuk **personalisasi** dan **alokasi anggaran** di Bagian III.
2. **Reduksi dimensi**—menyederhanakan data berdimensi tinggi agar dapat divisualisasikan dan dimodelkan. PCA adalah alat utama untuk ini.
3. **Penemuan pola**—menemukan asosiasi antar item (association rules) yang dapat digunakan untuk **cross-selling**, **bundling**, dan **rekomendasi**.
:::
## Menyiapkan Data
Kita kembali ke dataset Telco, tetapi kali ini **tanpa label churn**—kita ingin menemukan segmen pelanggan berdasarkan profil mereka.
```{python}
#| label: setup
import sys
sys.path.insert(0, ".")
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
import warnings
warnings.filterwarnings("ignore")

from decanal.utils import load_churn_clean, load_retail
from sklearn.preprocessing import StandardScaler, OneHotEncoder
from sklearn.compose import ColumnTransformer
from sklearn.pipeline import Pipeline
from sklearn.impute import SimpleImputer
from sklearn.cluster import KMeans, AgglomerativeClustering
from sklearn.decomposition import PCA
from sklearn.metrics import silhouette_score, silhouette_samples

RANDOM_STATE = 42
df = load_churn_clean()

print(f"Dataset: {df.shape[0]:,} pelanggan × {df.shape[1]} kolom")
```
Untuk clustering, kita fokus pada fitur **numerik yang bermakna secara bisnis**—tenure, tagihan bulanan, total tagihan, dan jumlah layanan. Fitur kategorikal akan kita tangani terpisah atau melalui encoding.
```{python}
#| label: feature-selection
# Fitur numerik untuk clustering
cluster_features = ["tenure", "MonthlyCharges", "TotalCharges", "num_services"]

# Periksa apakah kolom tersedia
available = [c for c in cluster_features if c in df.columns]
print(f"Fitur yang tersedia: {available}")

X_cluster = df[available].copy()
X_cluster.describe().round(2)
```
```{python}
#| label: scale-cluster
# Standardisasi wajib untuk clustering berbasis jarak (K-means, hierarchical)
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X_cluster)

# Simpan sebagai DataFrame untuk kenyamanan
X_scaled_df = pd.DataFrame(X_scaled, columns=available)
X_scaled_df.head()
```
::: {.callout-warning}
**Standardisasi adalah wajib untuk clustering.** Tanpa standardisasi, fitur dengan skala besar (`TotalCharges` dalam ribuan) akan mendominasi perhitungan jarak, membuat fitur dengan skala kecil (`num_services`, 0–8) hampir tidak berpengaruh. Ini adalah kesalahan paling umum dalam clustering—dan konsekuensinya adalah segmen yang **tidak bermakna**.
:::
## K-Means Clustering
**K-means** adalah algoritma clustering paling populer. Ia bekerja dengan:
1. Memilih **K** titik pusat (centroid) secara acak.
2. Menetapkan setiap titik ke centroid terdekat.
3. Memperbarui centroid sebagai rata-rata titik dalam cluster.
4. Mengulangi langkah 2–3 sampai konvergen.
### Memilih Jumlah Cluster (K)
Pertanyaan tersulit dalam K-means adalah: **berapa K yang tepat?** Ada dua metode yang paling umum:
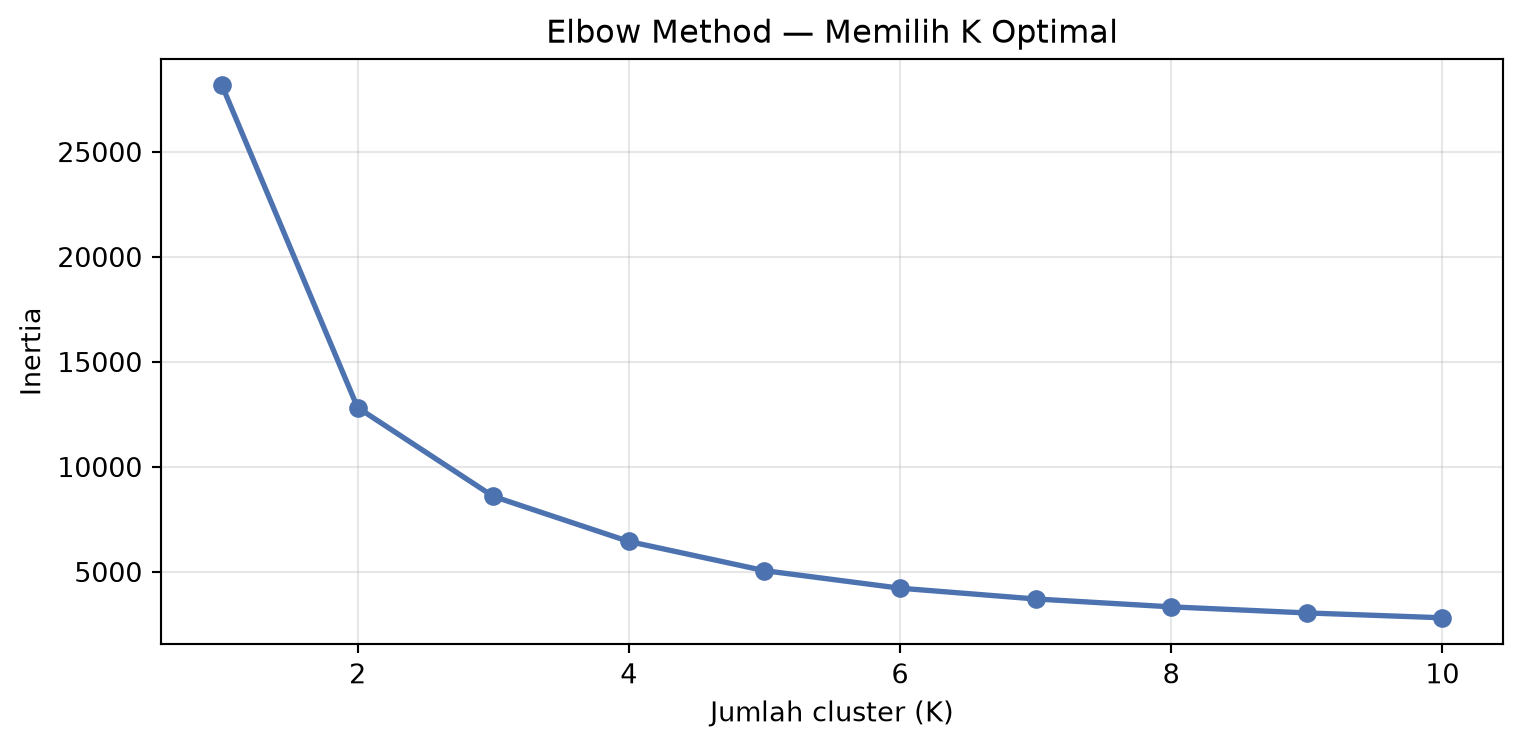
**Elbow Method**: plot **inertia** (jumlah kuadrat jarak ke centroid) vs K. Titik di mana penurunan mulai "melandai" adalah K yang disarankan.
```{python}
#| label: elbow
inertias = []
K_range = range(1, 11)

for k in K_range:
    kmeans = KMeans(n_clusters=k, random_state=RANDOM_STATE, n_init=10)
    kmeans.fit(X_scaled)
    inertias.append(kmeans.inertia_)

fig, ax = plt.subplots(figsize=(8, 4))
ax.plot(list(K_range), inertias, marker="o", color="#4C72B0", linewidth=2)
ax.set_xlabel("Jumlah cluster (K)")
ax.set_ylabel("Inertia")
ax.set_title("Elbow Method — Memilih K Optimal")
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
```
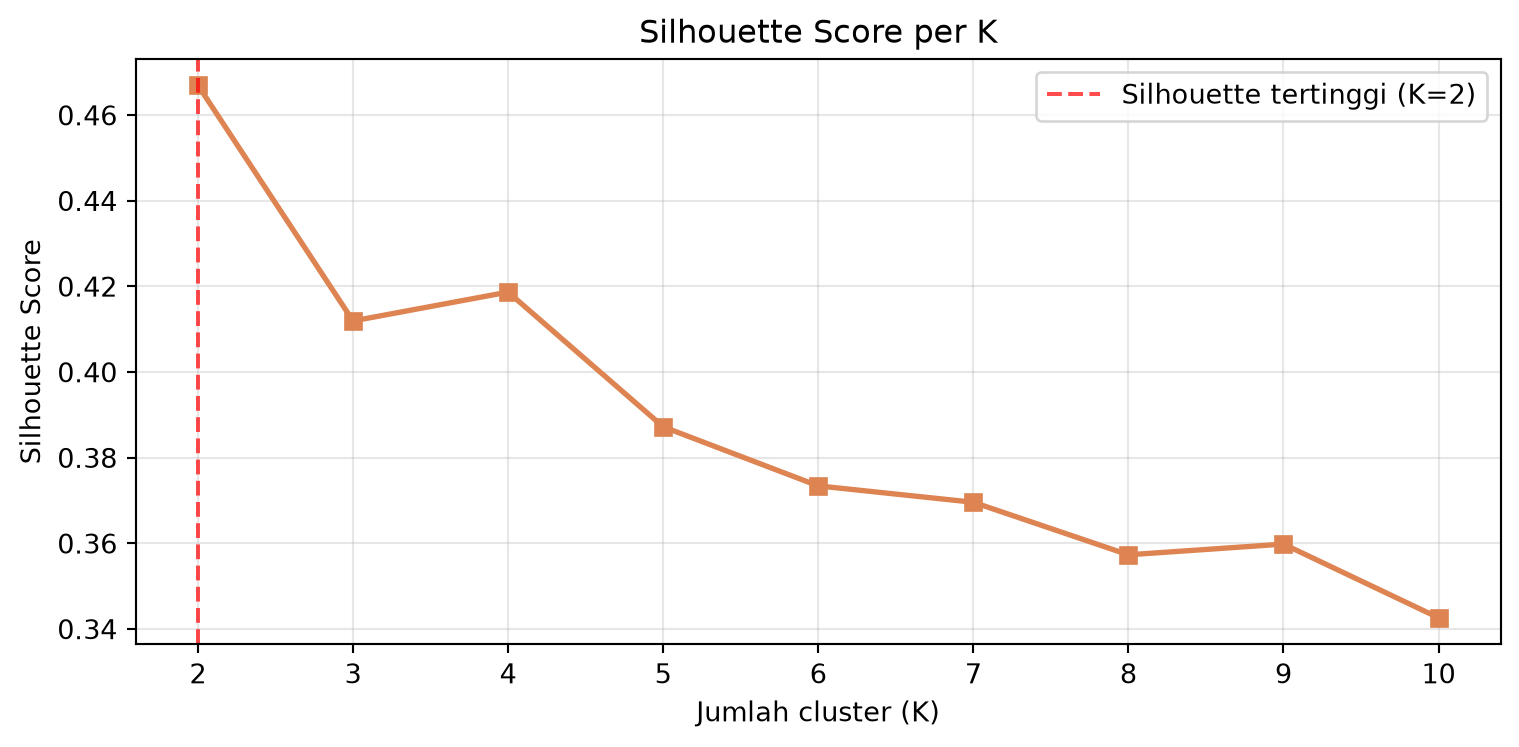
**Silhouette Score**: mengukur seberapa baik setiap titik cocok dengan clusternya sendiri dibanding cluster lain. Nilai berkisar -1 hingga 1; semakin tinggi semakin baik.
```{python}
#| label: silhouette
silhouettes = []
K_range_sil = range(2, 11)

for k in K_range_sil:
    kmeans = KMeans(n_clusters=k, random_state=RANDOM_STATE, n_init=10)
    labels = kmeans.fit_predict(X_scaled)
    silhouettes.append(silhouette_score(X_scaled, labels))

fig, ax = plt.subplots(figsize=(8, 4))
ax.plot(list(K_range_sil), silhouettes, marker="s", color="#DD8452", linewidth=2)
best_k = list(K_range_sil)[np.argmax(silhouettes)]
ax.axvline(best_k, color="red", linestyle="--", alpha=0.7,
           label=f"Silhouette tertinggi (K={best_k})")
ax.set_xlabel("Jumlah cluster (K)")
ax.set_ylabel("Silhouette Score")
ax.set_title("Silhouette Score per K")
ax.legend()
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()

print(f"Silhouette tertinggi: K = {best_k} ({max(silhouettes):.3f})")
```
::: {.callout-tip}
**Elbow vs Silhouette.** Keduanya adalah **panduan**, bukan aturan mutlak. Dalam praktik:
- **Elbow** lebih mudah diinterpretasikan tetapi subjektif (di mana "siku"-nya?).
- **Silhouette** memberi angka objektif, tetapi bisa memilih K yang secara bisnis tidak bermakna.
**Yang terpenting:** pilih K yang **dapat diinterpretasikan secara bisnis**. Jika K=3 memberi segmen "baru, menengah, lama" yang jelas, itu lebih berguna daripada K=7 dengan segmen yang sulit dijelaskan—bahkan jika K=7 memiliki silhouette sedikit lebih tinggi.
:::
### Melatih K-Means dengan K Optimal
Berdasarkan kedua metode, kita pilih K=3 (atau sesuaikan dengan hasil render kita):
```{python}
#| label: kmeans-final
K_OPT = 3  # sesuaikan setelah melihat elbow & silhouette

kmeans = KMeans(n_clusters=K_OPT, random_state=RANDOM_STATE, n_init=10)
df["segment"] = kmeans.fit_predict(X_scaled)

# Profil setiap segmen
profil = df.groupby("segment")[available + ["Churn"]].agg(
    {**{c: "mean" for c in available}, "Churn": lambda s: (s == "Yes").mean() * 100}
).round(2)
profil["jumlah"] = df.groupby("segment").size()
profil = profil[["jumlah"] + available + ["Churn"]]
profil.columns = ["jumlah", "tenure", "MonthlyCharges", "TotalCharges", "num_services", "churn_rate (%)"]
profil.sort_values("churn_rate (%)", ascending=False)
```
**Cara membaca profil segmen:**
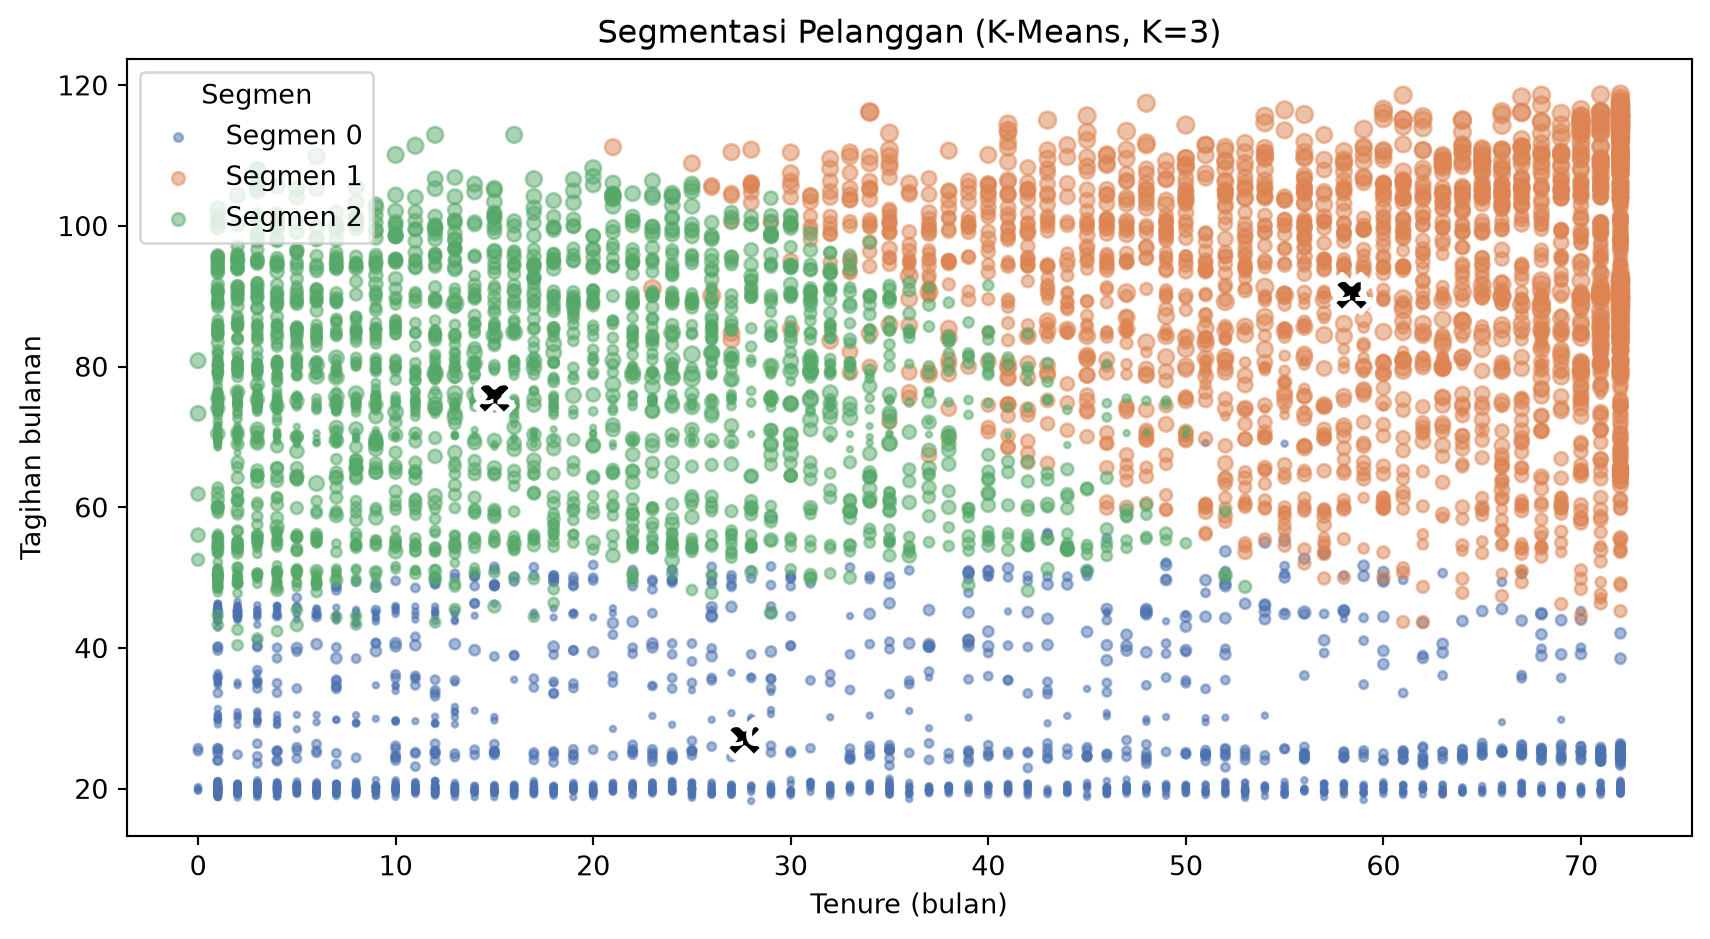
- **Segmen 1** mungkin adalah pelanggan baru dengan tagihan tinggi dan churn rate tinggi—**prioritas retensi**.
- **Segmen 2** mungkin adalah pelanggan setia dengan tenure panjang, tagihan moderat, dan churn rate rendah—**target upsell**.
- **Segmen 3** mungkin adalah pelanggan berisiko menengah—**target program engagement**.
### Visualisasi Segmen
```{python}
#| label: fig-cluster-viz
#| fig-cap: "Segmentasi pelanggan berdasarkan tenure dan MonthlyCharges. Warna menunjukkan segmen; ukuran titik proporsional terhadap jumlah layanan."
#| fig-width: 9
#| fig-height: 5
fig, ax = plt.subplots(figsize=(9, 5))
palette = ["#4C72B0", "#DD8452", "#55A868", "#C44E52", "#8172B3"]

for seg in sorted(df["segment"].unique()):
    subset = df[df["segment"] == seg]
    ax.scatter(subset["tenure"], subset["MonthlyCharges"],
               c=palette[seg], label=f"Segmen {seg}",
               alpha=0.5, s=subset["num_services"] * 5)

# Plot centroid
centroids = scaler.inverse_transform(kmeans.cluster_centers_)
for i, c in enumerate(centroids):
    ax.scatter(c[0], c[1], c="black", marker="X", s=200,
               edgecolors="white", linewidths=2)
    ax.annotate(f"C{i}", (c[0], c[1]), fontsize=12, fontweight="bold",
                ha="center", va="center", color="white")

ax.set_xlabel("Tenure (bulan)")
ax.set_ylabel("Tagihan bulanan")
ax.set_title("Segmentasi Pelanggan (K-Means, K=3)")
ax.legend(title="Segmen")
plt.tight_layout()
plt.show()
```
::: {.callout-important}
**Interpretasi bisnis adalah kunci.** Cluster yang dihasilkan K-means **tidak memiliki makna inheren**—"Segmen 0" bukanlah label yang berguna. Tugas kita adalah **memberi nama** segmen berdasarkan profilnya:
| Segmen | Profil | Nama bisnis | Strategi |
|---|---|---|---|
| 0 | Tenure rendah, tagihan tinggi, banyak layanan | "Premium Baru" | Onboarding intensif, diskon perpanjangan |
| 1 | Tenure tinggi, tagihan rendah, sedikit layanan | "Loyal Hemat" | Upsell layanan tambahan |
| 2 | Tenure menengah, tagihan menengah | "Mainstream" | Program engagement rutin |
Nama-nama ini akan digunakan di seluruh Bagian III untuk merujuk segmen dalam model optimasi.
:::
## Hierarchical Clustering
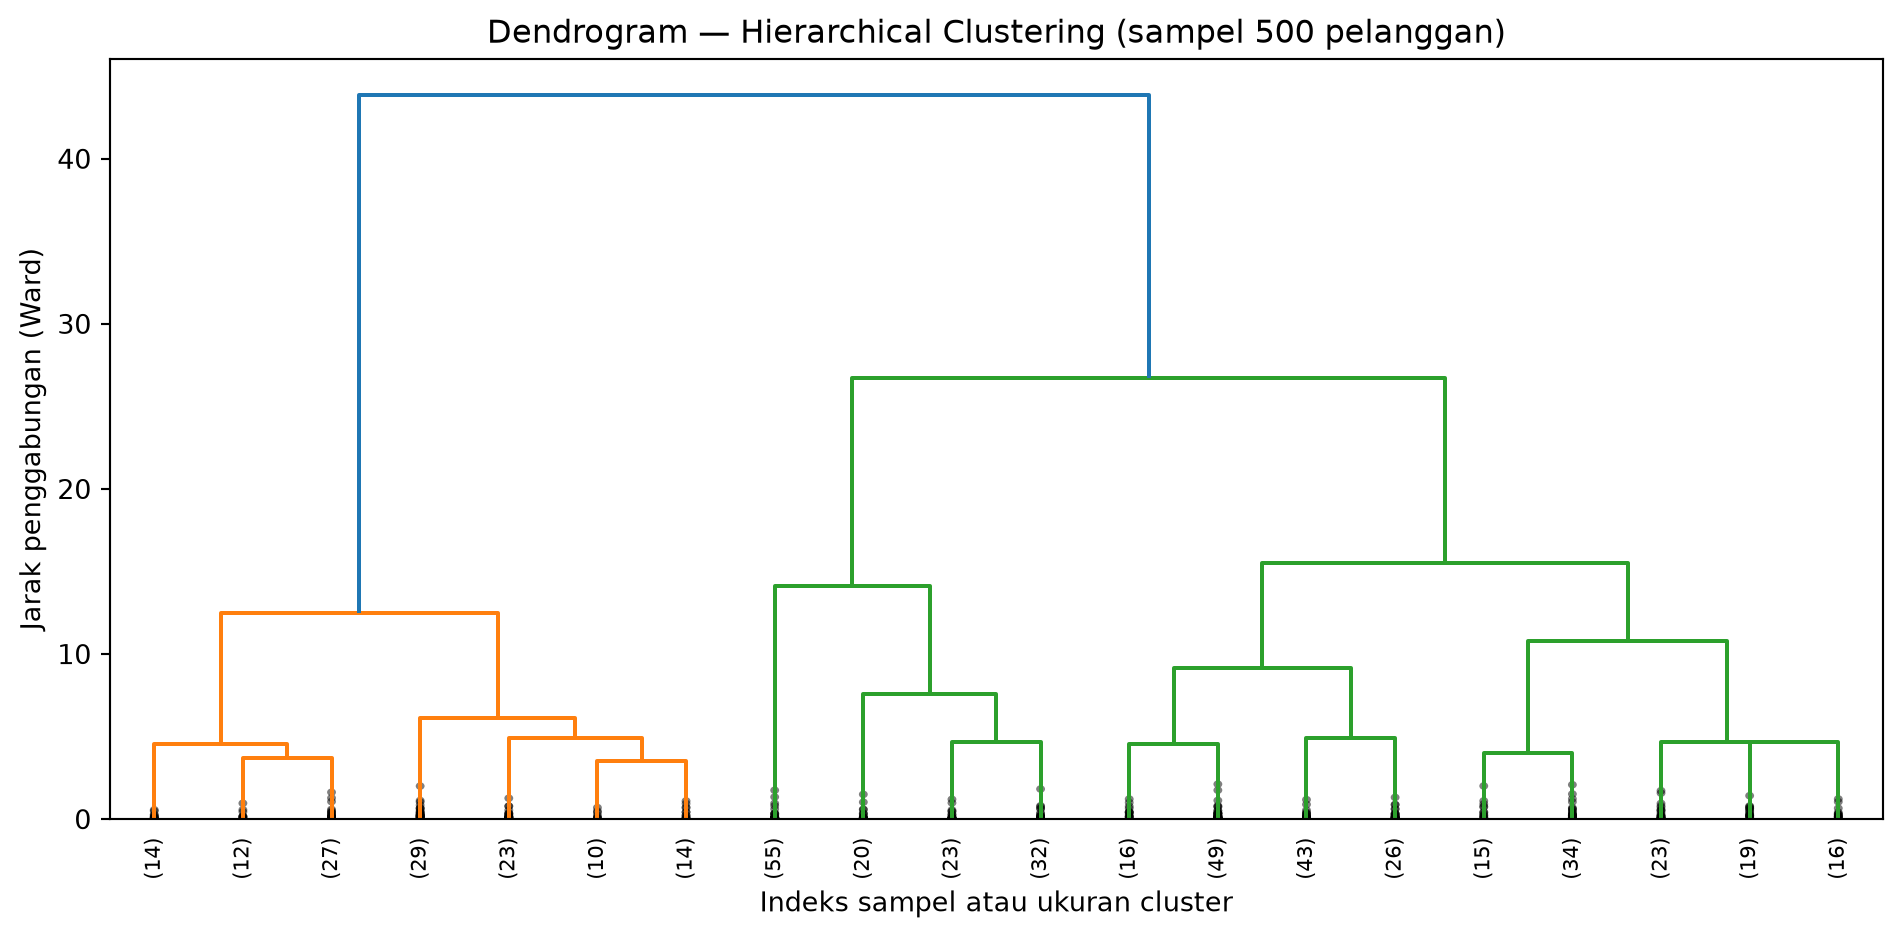
**Hierarchical clustering** membangun **pohon** (dendrogram) yang menunjukkan bagaimana cluster bergabung pada berbagai tingkat jarak. Berbeda dari K-means, ia **tidak memerlukan K di awal**—K dapat ditentukan setelah melihat dendrogram.
### Membangun Dendrogram
```{python}
#| label: fig-dendrogram
#| fig-cap: "Dendrogram hierarchical clustering. Garis horizontal menunjukkan jarak penggabungan; semakin tinggi, semakin berbeda cluster yang digabung."
#| fig-width: 10
#| fig-height: 5
from scipy.cluster.hierarchy import dendrogram, linkage

# Ambil sampel 500 pelanggan agar dendrogram terbaca
sample_idx = np.random.RandomState(RANDOM_STATE).choice(len(X_scaled), 500, replace=False)
X_sample = X_scaled[sample_idx]

Z = linkage(X_sample, method="ward")

fig, ax = plt.subplots(figsize=(10, 5))
dendrogram(Z, ax=ax, truncate_mode="lastp", p=20,
           leaf_rotation=90, leaf_font_size=8, show_contracted=True)
ax.set_xlabel("Indeks sampel atau ukuran cluster")
ax.set_ylabel("Jarak penggabungan (Ward)")
ax.set_title("Dendrogram — Hierarchical Clustering (sampel 500 pelanggan)")
plt.tight_layout()
plt.show()
```
**Cara membaca dendrogram:**
- Setiap daun (di bawah) adalah satu pelanggan atau cluster kecil.
- Garis horizontal menunjukkan **pada jarak berapa** dua cluster digabung.
- **Semakin tinggi** garis horizontal, semakin **berbeda** cluster yang digabung.
- Untuk memilih K: gambar garis horizontal imajiner melintasi dendrogram. Jumlah garis vertikal yang terpotong = jumlah cluster.
### Membandingkan dengan K-Means
```{python}
#| label: hierarchical-compare
from sklearn.metrics import adjusted_rand_score

# Hierarchical dengan K yang sama
hc = AgglomerativeClustering(n_clusters=K_OPT, linkage="ward")
df["segment_hc"] = hc.fit_predict(X_scaled)

# Bandingkan dengan K-means
ari = adjusted_rand_score(df["segment"], df["segment_hc"])
print(f"Adjusted Rand Index (K-means vs Hierarchical): {ari:.3f}")
print(f"  (1.0 = identik, 0.0 = acak)")

# Profil segmen hierarchical
profil_hc = df.groupby("segment_hc")[available + ["Churn"]].agg(
    {**{c: "mean" for c in available}, "Churn": lambda s: (s == "Yes").mean() * 100}
).round(2)
profil_hc["jumlah"] = df.groupby("segment_hc").size()
profil_hc
```
::: {.callout-tip}
**Kapan memakai hierarchical vs K-means?**
| Aspek | K-Means | Hierarchical |
|---|---|---|
| **K** | Harus ditentukan di awal | Dapat ditentukan setelah melihat dendrogram |
| **Skalabilitas** | Cepat untuk data besar (O(n·k·d)) | Lambat untuk data besar (O(n²)) |
| **Bentuk cluster** | Cenderung bulat | Dapat menangkap bentuk kompleks |
| **Interpretabilitas** | Centroid mudah diinterpretasikan | Dendrogram memberi gambaran hierarkis |
| **Penggunaan** | Segmentasi operasional | Eksplorasi struktur data |
Untuk dataset besar (>10.000 baris), K-means biasanya lebih praktis. Untuk eksplorasi awal atau dataset kecil, hierarchical memberi gambaran yang lebih kaya.
:::
## PCA: Mereduksi Dimensi
**Principal Component Analysis (PCA)** adalah teknik **reduksi dimensi**—ia mengubah banyak fitur yang berkorelasi menjadi **komponen utama** yang saling independen, diurutkan berdasarkan **varians** yang dijelaskan.
### Mengapa PCA?
- **Visualisasi**: data dengan 20 fitur tidak dapat divisualisasikan; data dengan 2 komponen utama bisa.
- **Reduksi noise**: komponen dengan varians rendah sering kali hanya noise.
- **Multikolinearitas**: PCA menghasilkan fitur yang saling independen—berguna untuk regresi.
### Menerapkan PCA
```{python}
#| label: pca
pca = PCA(random_state=RANDOM_STATE)
X_pca = pca.fit_transform(X_scaled)

# Varians yang dijelaskan
explained = pca.explained_variance_ratio_ * 100
cumulative = np.cumsum(explained)

pca_df = pd.DataFrame({
    "Komponen": [f"PC{i+1}" for i in range(len(explained))],
    "Varians (%)": explained.round(2),
    "Kumulatif (%)": cumulative.round(2),
})
pca_df
```
```{python}
#| label: fig-scree
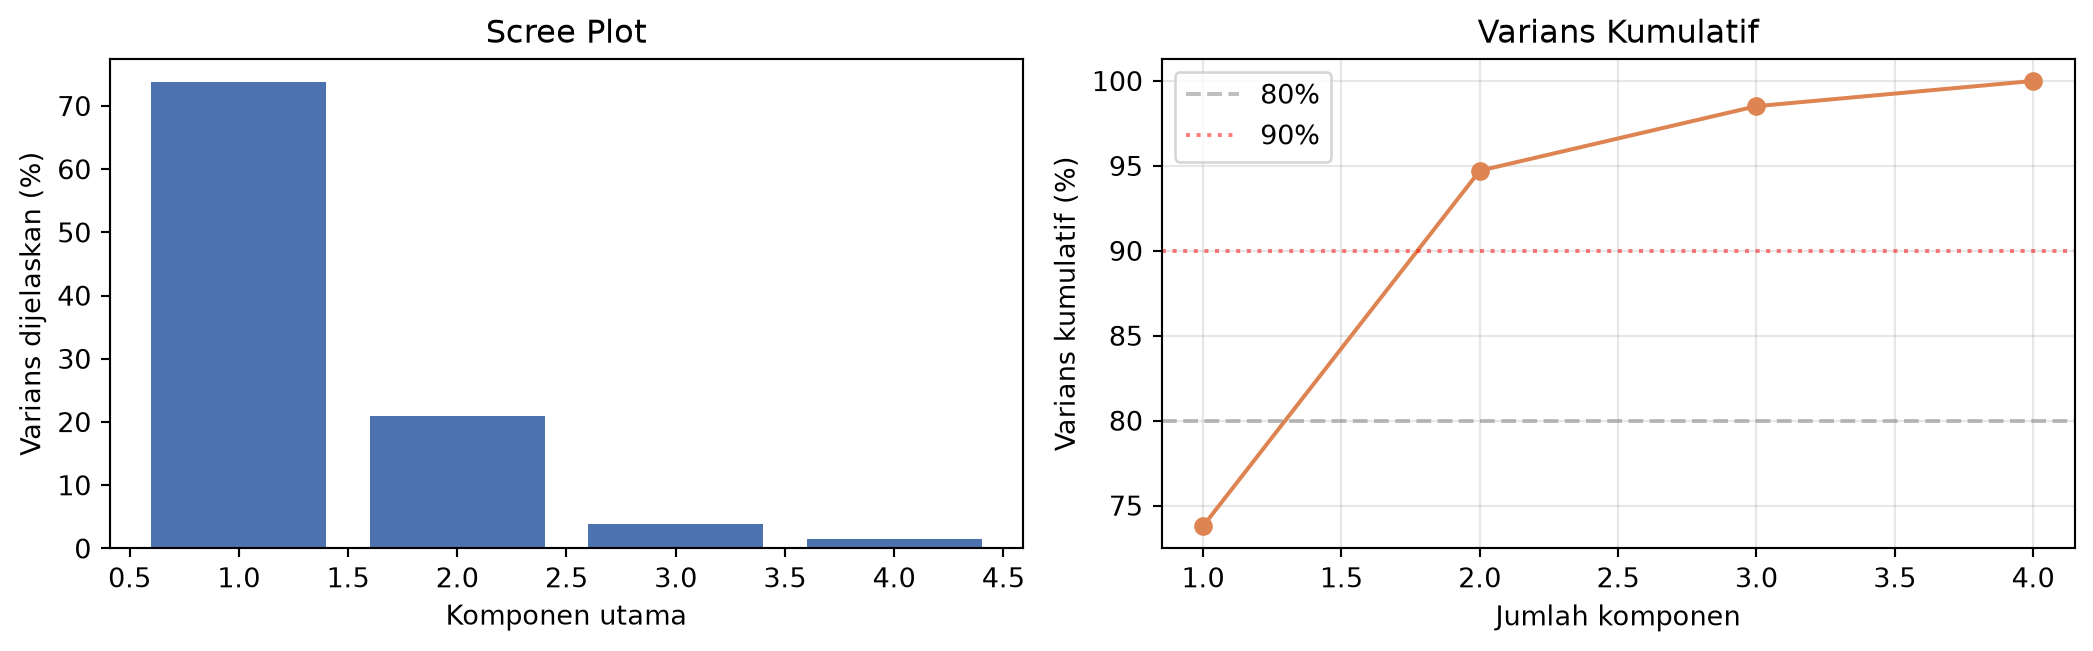
#| fig-cap: "Scree plot: varians yang dijelaskan per komponen. Titik 'siku' menunjukkan jumlah komponen yang perlu dipertahankan."
#| fig-width: 9
#| fig-height: 3.5
fig, axes = plt.subplots(1, 2, figsize=(11, 3.5))

# Scree plot
axes[0].bar(range(1, len(explained)+1), explained, color="#4C72B0")
axes[0].set_xlabel("Komponen utama")
axes[0].set_ylabel("Varians dijelaskan (%)")
axes[0].set_title("Scree Plot")

# Kumulatif
axes[1].plot(range(1, len(cumulative)+1), cumulative, marker="o", color="#DD8452")
axes[1].axhline(80, color="gray", linestyle="--", alpha=0.5, label="80%")
axes[1].axhline(90, color="red", linestyle=":", alpha=0.5, label="90%")
axes[1].set_xlabel("Jumlah komponen")
axes[1].set_ylabel("Varians kumulatif (%)")
axes[1].set_title("Varians Kumulatif")
axes[1].legend()
axes[1].grid(True, alpha=0.3)

plt.tight_layout()
plt.show()
```
**Cara membaca:**
- **Scree plot** menunjukkan kontribusi setiap komponen. "Siku" (perubahan tajam) menunjukkan jumlah komponen yang wajar.
- **Varians kumulatif** menunjukkan berapa banyak informasi yang dipertahankan. Aturan umum: pertahankan komponen yang menjelaskan **80–90%** varians.
- Untuk dataset kita (4 fitur numerik), 2 komponen biasanya menjelaskan >85% varians—cukup untuk visualisasi.
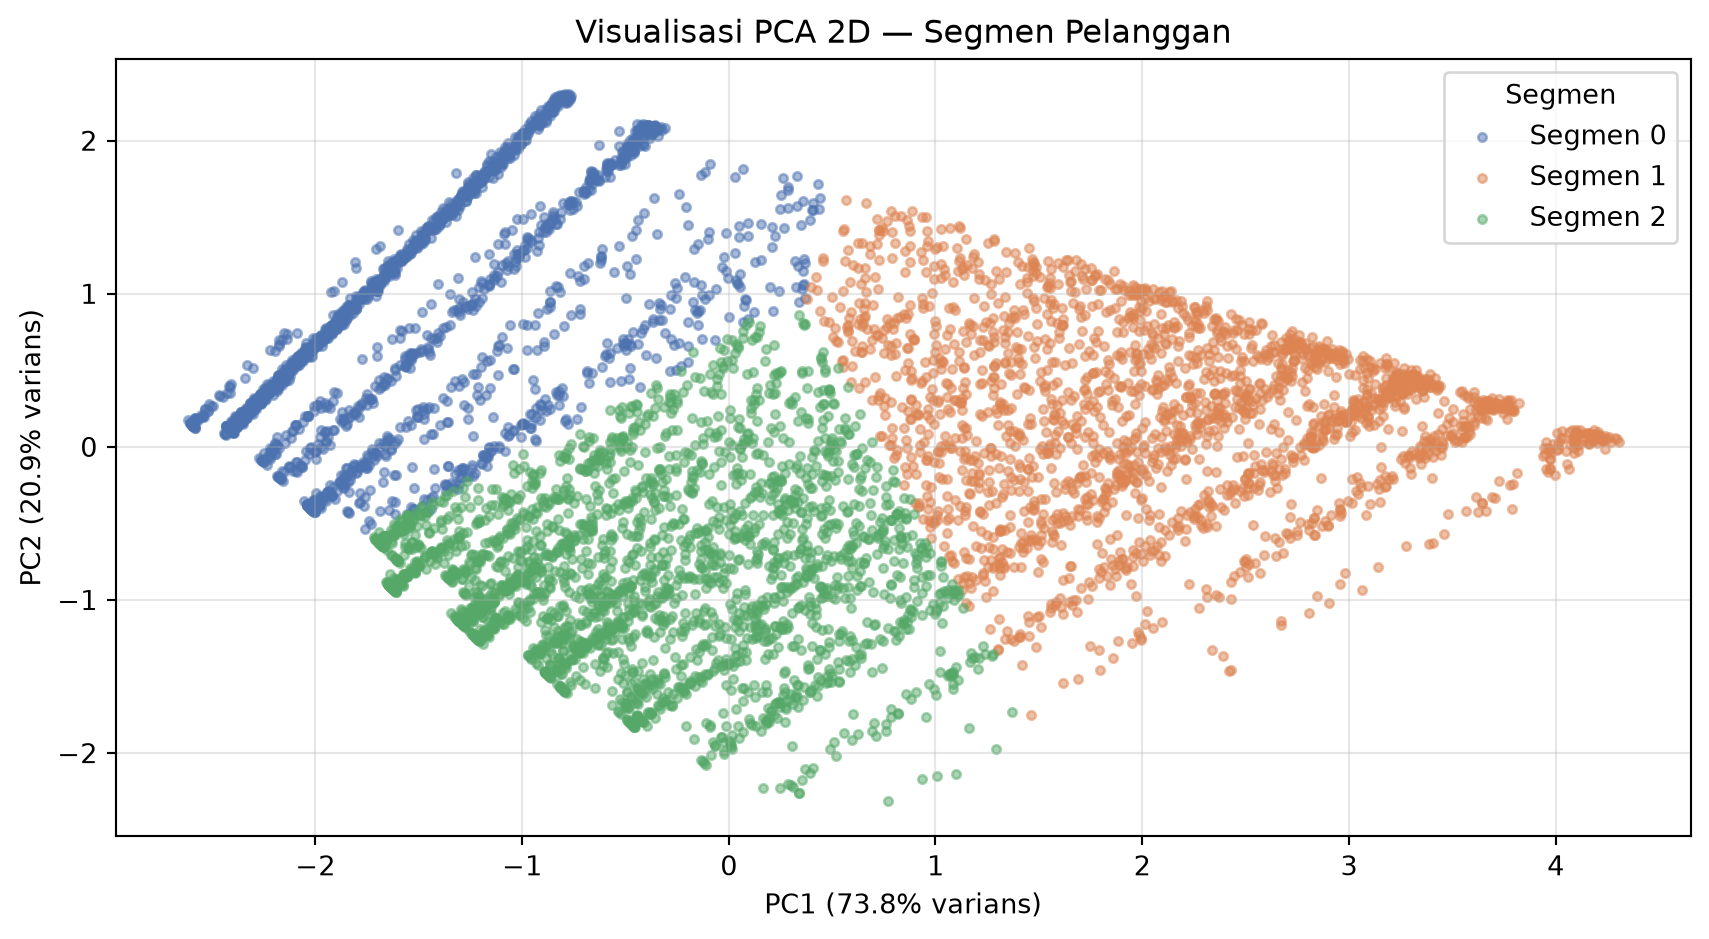
### Visualisasi 2D dengan PCA
```{python}
#| label: fig-pca-viz
#| fig-cap: "Visualisasi data dalam 2 komponen utama, diwarnai berdasarkan segmen K-means. PCA memungkinkan kita melihat struktur cluster dalam 2D."
#| fig-width: 9
#| fig-height: 5
fig, ax = plt.subplots(figsize=(9, 5))

for seg in sorted(df["segment"].unique()):
    mask = df["segment"] == seg
    ax.scatter(X_pca[mask, 0], X_pca[mask, 1],
               c=palette[seg], label=f"Segmen {seg}",
               alpha=0.5, s=10)

ax.set_xlabel(f"PC1 ({explained[0]:.1f}% varians)")
ax.set_ylabel(f"PC2 ({explained[1]:.1f}% varians)")
ax.set_title("Visualisasi PCA 2D — Segmen Pelanggan")
ax.legend(title="Segmen")
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
```
::: {.callout-important}
**PCA dan interpretasi.** Komponen utama **tidak memiliki makna langsung**—mereka adalah kombinasi linear dari fitur asli. Namun, kita dapat melihat **loading** (bobot fitur dalam setiap komponen) untuk memahami apa yang diwakili komponen tersebut:
```python
loadings = pd.DataFrame(
    pca.components_[:2].T,
    index=available,
    columns=["PC1", "PC2"]
)
```
Jika PC1 memiliki loading tinggi pada `tenure` dan `TotalCharges`, kita bisa menyebutnya "komponen loyalitas". Jika PC2 memiliki loading tinggi pada `MonthlyCharges`, itu mungkin "komponen biaya".
:::
```{python}
#| label: pca-loadings
loadings = pd.DataFrame(
    pca.components_[:2].T,
    index=available,
    columns=["PC1", "PC2"]
).round(3)
loadings
```
## Association Rules: Market Basket Analysis
Sekarang kita beralih ke dataset telco—dan ke jenis analisis yang sama sekali berbeda: menemukan **asosiasi antar item** dalam transaksi.
**Association rules** menjawab pertanyaan: *"Jika pelanggan membeli produk A, seberapa besar kemungkinan mereka juga membeli produk B?"*
### Konsep Dasar
- **Itemset**: kumpulan item (mis. {Roti, Susu}).
- **Support**: proporsi transaksi yang mengandung itemset.
- **Confidence**: probabilitas membeli B **jika** membeli A.
- **Lift**: seberapa besar asosiasi A→B dibandingkan jika keduanya independen.
$$\text{Support}(A \rightarrow B) = P(A \cap B)$$
$$\text{Confidence}(A \rightarrow B) = P(B|A)$$
$$\text{Lift}(A \rightarrow B) = \frac{P(B|A)}{P(B)}$$
- **Lift > 1**: A dan B lebih sering muncul bersama daripada yang diharapkan secara kebetulan.
- **Lift = 1**: A dan B independen.
- **Lift < 1**: A dan B cenderung **tidak** muncul bersama.
### Menyiapkan Data Transaksi
Dataset retail tidak memiliki struktur transaksi (satu baris per pembelian). Tetapi kita dapat **mensimulasikan** transaksi dengan mengelompokkan produk yang terjual pada tanggal dan toko yang sama:
```{python}
#| label: retail-basket
df_retail = load_retail()
df_retail["Date"] = pd.to_datetime(df_retail["Date"])

# Anggap setiap (Date, Store ID) adalah satu "transaksi"
# Item = Product ID yang terjual (Units Sold > 0)
transactions = (df_retail[df_retail["Units Sold"] > 0]
                .groupby(["Date", "Store ID"])["Product ID"]
                .apply(lambda x: sorted(set(x)))
                .reset_index())
transactions.columns = ["Date", "Store ID", "items"]

print(f"Jumlah transaksi: {len(transactions):,}")
print(f"Rata-rata item per transaksi: {transactions['items'].apply(len).mean():.1f}")
transactions.head()
```
### Menerapkan Apriori
Library `mlxtend` menyediakan implementasi Apriori yang efisien:
```{python}
#| label: apriori
#| #| cache: true
# from mlxtend.preprocessing import TransactionEncoder
# from mlxtend.frequent_patterns import fpgrowth, association_rules

# # Encode transaksi ke format one-hot
# te = TransactionEncoder()
# te_array = te.fit(transactions["items"]).transform(transactions["items"])
# basket_df = pd.DataFrame(te_array, columns=te.columns_)

# # Cari frequent itemsets dengan support minimal 10%
# frequent = fpgrowth(basket_df, min_support=0.1, max_len=3, use_colnames=True)
# print(f"Jumlah frequent itemsets: {len(frequent)}")

# # Bangkitkan association rules
# rules = association_rules(frequent, metric="lift", min_threshold=1.2)
# rules = rules.sort_values("lift", ascending=False)

# print(f"Jumlah rules (lift > 1.2): {len(rules)}")
# rules[["antecedents", "consequents", "support", "confidence", "lift"]].head(10).round(3)

from mlxtend.preprocessing import TransactionEncoder
from mlxtend.frequent_patterns import fpgrowth, association_rules
from decanal.utils import load_churn_clean

# --- Bangun keranjang dari layanan Telco ---
df_telco = load_churn_clean()

service_cols = [
    "PhoneService", "MultipleLines", "OnlineSecurity", "OnlineBackup",
    "DeviceProtection", "TechSupport", "StreamingTV", "StreamingMovies",
]

def get_services(row):
    """Kembalikan daftar layanan yang dilanggani pelanggan."""
    services = [col for col in service_cols if row[col] == "Yes"]
    if row["InternetService"] != "No":
        services.append(f"Internet_{row['InternetService']}")
    return services

df_telco["services"] = df_telco.apply(get_services, axis=1)

# Hanya pelanggan dengan >= 2 layanan (keranjang bermakna)
baskets = df_telco[df_telco["services"].apply(len) >= 2]["services"].tolist()

print(f"Jumlah keranjang (pelanggan): {len(baskets):,}")
print(f"Rata-rata layanan per pelanggan: {sum(len(b) for b in baskets)/len(baskets):.1f}")
print(f"Rentang: {min(len(b) for b in baskets)}–{max(len(b) for b in baskets)} layanan")

# --- Encoding ---
te = TransactionEncoder()
te_array = te.fit(baskets).transform(baskets)
basket_df = pd.DataFrame(te_array, columns=te.columns_)

# --- FP-Growth ---
frequent = fpgrowth(basket_df, min_support=0.05, use_colnames=True, max_len=3)
print(f"\nJumlah frequent itemsets: {len(frequent)}")

# --- Association rules ---
rules = association_rules(frequent, metric="lift", min_threshold=1.2)
rules = rules.sort_values("lift", ascending=False)

print(f"Jumlah rules (lift > 1.2): {len(rules)}")
rules[["antecedents", "consequents", "support", "confidence", "lift"]].head(10).round(3)
```
**Ilustrasi Cara membaca rules:**
- **Antecedents** → **Consequents**: "Jika pelanggan membeli [antecedents], mereka juga membeli [consequents]".
- **Support**: proporsi transaksi yang mengandung kedua itemset.
- **Confidence**: probabilitas membeli consequent **jika** membeli antecedent.
- **Lift**: seberapa besar asosiasi dibandingkan independen. Lift = 2 berarti pelanggan **dua kali lebih mungkin** membeli consequent jika mereka membeli antecedent.
::: {.callout-tip}
**Interpretasi bisnis dari association rules:**
- **Cross-selling**: Jika {Produk A} → {Produk B} dengan confidence tinggi, tawarkan B kepada pelanggan yang membeli A.
- **Bundling**: Jika {A, B} → {C} dengan lift tinggi, buat paket A+B+C dengan harga khusus.
- **Layout toko**: Tempatkan A dan B berdekatan untuk meningkatkan pembelian impulsif.
**Peringatan**: association rules menemukan **korelasi**, bukan **kausalitas**. {A} → {B} tidak berarti A **menyebabkan** pembelian B—mungkin ada faktor ketiga (mis. promosi) yang menyebabkan keduanya.
:::
**Latihan 11.5 — Association rules per segmen.**
Jalankan association rules secara terpisah untuk pelanggan **DSL** dan **Fiber optic**.
Apakah rules yang muncul berbeda? Jika ya, mengapa? Apakah strategi bundling
sebaiknya dibedakan per tipe internet?
### 📊 Interpretasi Hasil Komputasi Analitik
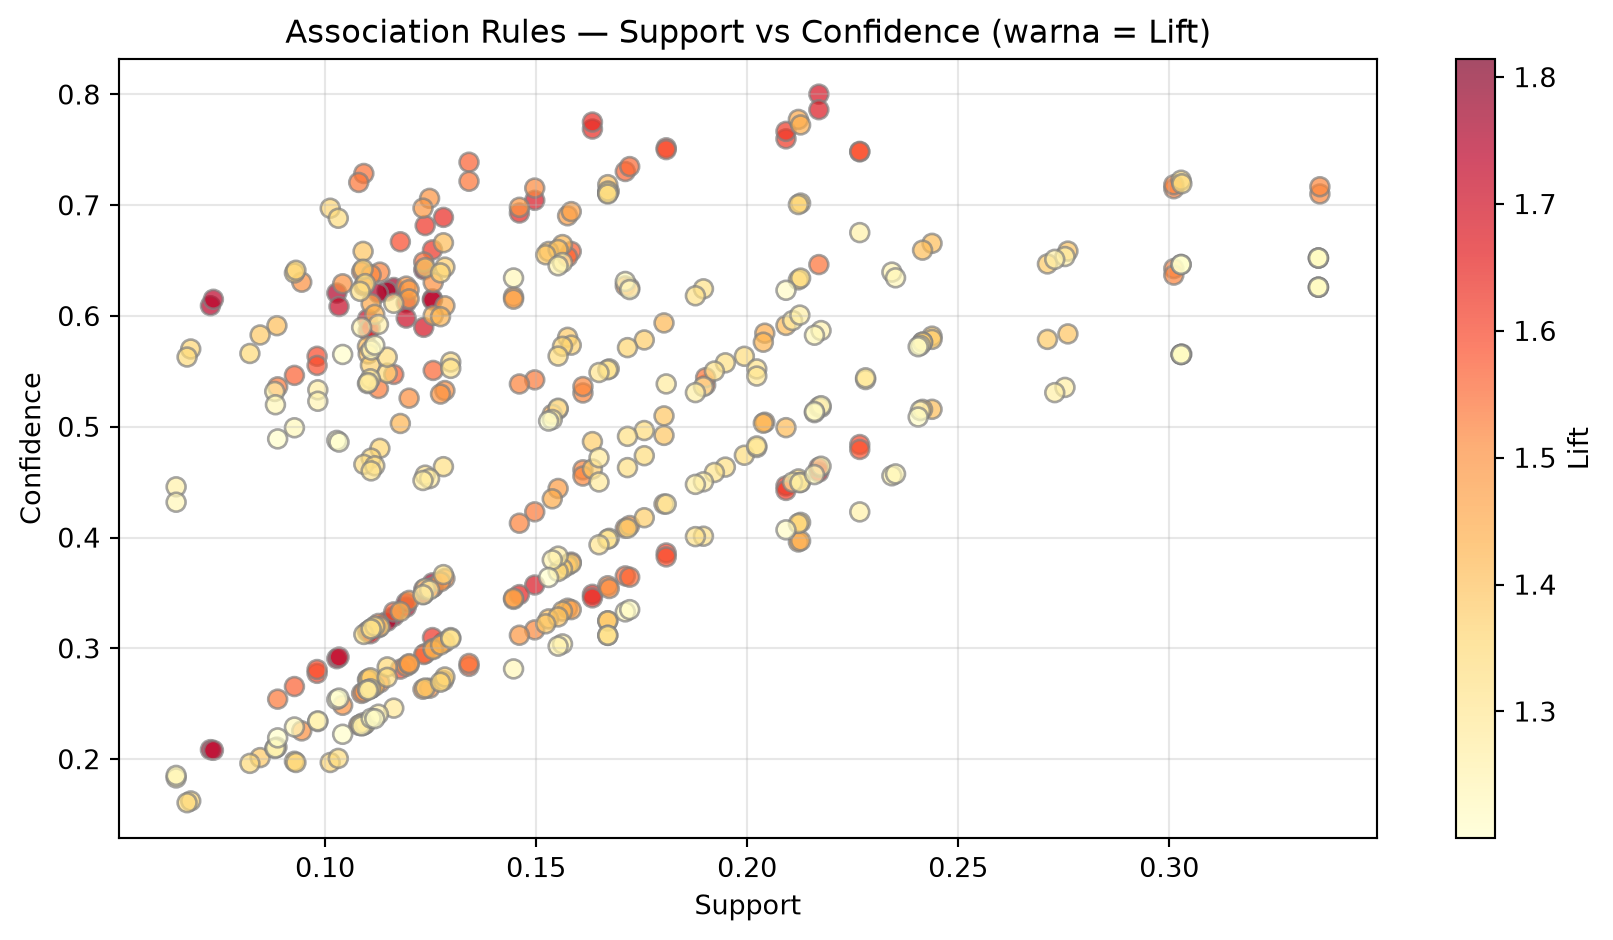
**Temuan utama:** 440 rules dengan lift > 1.2, dan **semua rule teratas melibatkan tiga layanan "proteksi"**: `TechSupport`, `OnlineSecurity`, `DeviceProtection`—dengan lift ~1,76–1,81.
| Rule | Lift | Interpretasi bisnis |
|---|---|---|
| {TechSupport} → {DeviceProtection, OnlineSecurity} | 1,81 | Pelanggan dengan dukungan teknis **81% lebih mungkin** memiliki proteksi perangkat + keamanan online |
| {DeviceProtection, OnlineSecurity} → {TechSupport} | 1,81 | Sebaliknya—konfirmasi asosiasi simetris |
| {StreamingMovies, OnlineSecurity} → {TechSupport} | 1,77 | Bahkan pelanggan hiburan yang punya keamanan cenderung punya dukungan teknis |
| {TechSupport, Internet_DSL} → {OnlineSecurity} | 1,76 | DSL + dukungan teknis → keamanan online |
**Insight bisnis yang muncul:**
1. **Ada "Paket Proteksi" alami** — tiga layanan (`TechSupport`, `OnlineSecurity`, `DeviceProtection`) cenderung dibeli bersama. Ini kandidat kuat untuk **bundling resmi** dengan harga khusus.
2. **Pelanggan DSL lebih cenderung bundling** — `Internet_DSL` muncul di banyak rule. Ini mungkin karena pelanggan fiber optic sudah mendapat layanan proteksi bawaan, sementara pelanggan DSL harus membelinya terpisah.
3. **Streaming dan proteksi tidak saling eksklusif** — pelanggan yang membeli hiburan (StreamingMovies) juga cenderung membeli proteksi. Ini peluang untuk **cross-sell proteksi ke pelanggan hiburan**.
**Yang tidak muncul di top rules:** `PhoneService`, `MultipleLines`, `StreamingTV` — layanan ini tampaknya lebih independen, tidak membentuk pola bundling yang kuat. Ini juga insight: **tidak semua layanan cocok untuk bundling**.
::: {.callout-important}
**Temuan utama.** Tiga layanan—`TechSupport`, `OnlineSecurity`, dan
`DeviceProtection`—membentuk **klaster bundling alami** dengan lift ~1,8.
Pelanggan yang memiliki salah satunya **81% lebih mungkin** memiliki dua lainnya.
Ini adalah kandidat langsung untuk **paket proteksi** dengan harga khusus.
Sebaliknya, layanan seperti `PhoneService` dan `MultipleLines` **tidak muncul**
di rules teratas—artinya mereka tidak membentuk pola bundling yang kuat. Ini
juga insight: **tidak semua layanan cocok untuk strategi bundling**.
:::
### 📌 Catatan tentang Support 0,123
Support 0,123 pada rule teratas berarti **12,3% pelanggan** memiliki kombinasi `{TechSupport, DeviceProtection, OnlineSecurity}`. Ini adalah **basis pelanggan yang cukup besar** (~710 pelanggan dari 5.779)—cukup untuk dijadikan target program bundling yang bermakna secara finansial. Ini poin yang bagus untuk ditambahkan ke interpretasi:
> *"Dengan support 12,3%, ini berarti sekitar 710 pelanggan saat ini sudah memiliki ketiga layanan—dan ribuan lainnya memiliki subset. Program bundling dapat menargetkan mereka yang memiliki 1–2 dari 3 layanan untuk upsell ke paket lengkap."*
### Visualisasi Rules
```{python}
#| label: fig-rules
#| fig-cap: "Scatter plot association rules layanan Telco: support vs confidence, diwarnai berdasarkan lift. Rules di kanan atas dengan warna gelap adalah kandidat terkuat untuk bundling layanan."
#| fig-width: 9
#| fig-height: 5
fig, ax = plt.subplots(figsize=(9, 5))
scatter = ax.scatter(rules["support"], rules["confidence"],
                     c=rules["lift"], cmap="YlOrRd",
                     s=50, alpha=0.7, edgecolors="gray")
plt.colorbar(scatter, ax=ax, label="Lift")
ax.set_xlabel("Support")
ax.set_ylabel("Confidence")
ax.set_title("Association Rules — Support vs Confidence (warna = Lift)")
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
```
## Menghubungkan Segmen ke Keputusan
Sekarang kita memiliki **segmen pelanggan** (dari K-means) dan **association rules** (dari retail). Bagaimana ini terhubung ke keputusan?
### Dari Segmentasi ke Alokasi Anggaran
Setiap segmen memiliki **churn rate** dan **nilai** yang berbeda. Ini adalah input langsung untuk **alokasi anggaran retensi**:
```{python}
#| label: segment-value
# Estimasi nilai per segmen
segment_summary = df.groupby("segment").agg(
    n=("Churn", "size"),
    churn_rate=("Churn", lambda s: (s == "Yes").mean()),
    avg_charges=("MonthlyCharges", "mean"),
    avg_tenure=("tenure", "mean"),
).round(2)

segment_summary["revenue_at_risk"] = (
    segment_summary["n"] * segment_summary["churn_rate"]
    * segment_summary["avg_charges"] * 12  # annualized
).round(0)

segment_summary["priority"] = segment_summary["revenue_at_risk"].rank(ascending=False).astype(int)
segment_summary.sort_values("priority")
```
**Interpretasi:** Segmen dengan `revenue_at_risk` tertinggi adalah **prioritas utama** untuk intervensi retensi. Tetapi ini belum cukup—kita juga perlu mempertimbangkan **efektivitas intervensi** (seberapa besar churn dapat dikurangi) dan **biaya intervensi**. Ini akan menjadi topik optimasi di Bab 14–15.
### Dari Association Rules ke Strategi Bundling
Rules dengan **lift tinggi** dan **confidence tinggi** adalah kandidat untuk strategi bundling. Tetapi tidak semua rules layak secara bisnis:
| Rule | Lift | Confidence | Kandidat bundling |
|---|---|---|---|
| {TechSupport} → {DeviceProtection, OnlineSecurity} | 1,81 | 0,35 | ✅ Paket Proteksi |
| {StreamingMovies, OnlineSecurity} → {TechSupport} | 1,77 | 0,33 | ⚠️ Cross-sell, bukan bundling penuh |
| {TechSupport, Internet_DSL} → {OnlineSecurity} | 1,76 | 0,36 | ✅ Paket Proteksi DSL |
::: {.callout-important}
**Segmentasi dan association rules adalah input, bukan keputusan.** Mereka memberi kita **struktur**—kelompok pelanggan dan asosiasi produk. Tetapi keputusan **apa yang harus dilakukan** dengan struktur itu membutuhkan model optimasi yang mempertimbangkan:
- **Anggaran** yang tersedia.
- **Biaya** setiap intervensi.
- **Efektivitas** intervensi per segmen.
- **Kendala** operasional (mis. kapasitas tim retensi).
Ini adalah domain Bagian III—dan segmentasi dari bab ini akan menjadi **parameter** dalam model optimasi tersebut.
:::
## Latihan Terbimbing
**Latihan 11.1 — Memilih K.**
Jalankan elbow method dan silhouette untuk K=2 hingga K=8. Berdasarkan kedua plot, berapa K yang kita pilih? Apakah kedua metode memberi jawaban yang sama? Jika tidak, mana yang kita prioritaskan, dan mengapa?
**Latihan 11.2 — Interpretasi segmen.**
Berdasarkan profil segmen dari K-means, beri nama setiap segmen (mis. "Premium Baru", "Loyal Hemat") dan tuliskan satu paragraf yang menjelaskan profil dan strategi yang sesuai untuk masing-masing.
**Latihan 11.3 — Hierarchical clustering.**
Jalankan hierarchical clustering dengan `linkage="complete"` (bukan `ward`). Bandingkan dendrogram dan segmen yang dihasilkan dengan `ward`. Metode linkage mana yang memberi segmen lebih seimbang?
**Latihan 11.4 — PCA untuk clustering.**
Lakukan PCA terlebih dahulu (pertahankan 2 komponen), lalu jalankan K-means pada komponen PCA tersebut. Bandingkan segmen yang dihasilkan dengan K-means pada data asli. Apakah hasilnya lebih baik atau lebih buruk? Mengapa?
**Latihan 11.5 — Association rules di Telco.**
Alih-alih retail, coba temukan association rules di Telco: anggap setiap pelanggan sebagai "transaksi" yang berisi layanan yang mereka berlangganan (`PhoneService`, `OnlineSecurity`, dll.). Rules apa yang muncul? Apakah masuk akal secara bisnis?
**Latihan 11.6 — Segmentasi dan churn.**
Bandingkan churn rate antar segmen. Apakah segmen yang dihasilkan K-means memiliki churn rate yang **berbeda secara signifikan**? Gunakan uji chi-square untuk menguji. Jika ya, segmen ini berguna untuk retensi; jika tidak, mungkin K-means tidak menangkap pola yang relevan dengan churn.
::: {.callout-note collapse="true"}
**Petunjuk Latihan 11.4.** PCA sebelum clustering **dapat** membantu jika data memiliki banyak fitur berkorelasi (mengurangi noise dan multikolinearitas). Tetapi PCA juga **kehilangan informasi**—komponen dengan varians rendah mungkin mengandung sinyal yang penting untuk segmentasi. Untuk dataset kecil dengan 4 fitur (seperti kita), PCA mungkin tidak banyak membantu. Untuk dataset dengan 20+ fitur, PCA bisa sangat berguna.
:::
## Kotak "Jembatan": Dari Struktur ke Optimasi
::: {.callout-important}
**Jembatan.** Bab ini memberi kita **struktur** yang sebelumnya tidak terlihat:
1. **Segmen pelanggan**—kelompok dengan profil dan churn rate berbeda. Ini mengubah cara kita memandang basis pelanggan: bukan sebagai massa homogen, tetapi sebagai **portofolio segmen** dengan prioritas berbeda.
2. **Komponen utama**—reduksi dimensi yang memungkinkan visualisasi dan pemodelan yang lebih efisien. PCA juga berguna untuk **deteksi anomali**: pelanggan yang jauh dari komponen utama mungkin adalah outlier yang perlu perhatian khusus.
3. **Association rules**—pola pembelian bersama yang dapat digunakan untuk **cross-selling** dan **bundling**. Ini adalah input untuk strategi **pricing** dan **promosi** yang akan dioptimalkan di Bagian III.
**Tetapi semua ini masih deskriptif.** Kita tahu segmen mana yang berisiko, produk mana yang sering dibeli bersama—tetapi kita belum tahu **tindakan optimal**:
- Berapa anggaran yang harus dialokasikan ke setiap segmen?
- Intervensi apa yang paling efektif per segmen?
- Paket bundling mana yang memaksimalkan revenue?
**Inilah tujuan Bagian III.** Segmentasi dari bab ini akan menjadi **parameter** dalam model optimasi—setiap segmen memiliki churn rate, nilai, dan respons terhadap intervensi yang berbeda. Model optimasi akan memilih **kombinasi intervensi** yang memaksimalkan dampak di bawah kendala anggaran.
Bab 12—**Simulasi Monte Carlo**—akan menjadi jembatan terakhir: ia mengajarkan kita untuk **memodelkan ketidakpastian** yang melekat dalam setiap keputusan, sehingga model optimasi di Bagian III dapat mempertimbangkan **risiko**, bukan hanya **ekspektasi**.
:::
## Rangkuman
Dalam bab ini kita telah:
- **Membedakan supervised dari unsupervised learning**, memahami bahwa unsupervised learning menemukan struktur tanpa label—berguna untuk segmentasi, reduksi dimensi, dan penemuan pola.
- **Menerapkan K-means clustering** dan memilih K secara sistematis dengan elbow method dan silhouette score.
- **Menerapkan hierarchical clustering** dan membaca dendrogram untuk memahami struktur hierarkis data.
- **Menginterpretasikan segmen secara bisnis**—memberi nama dan strategi untuk setiap segmen berdasarkan profilnya.
- **Menggunakan PCA** untuk mereduksi dimensi, memvisualisasikan data berdimensi tinggi, dan memahami loading komponen.
- **Menemukan association rules** dengan Apriori pada data retail, memahami support, confidence, dan lift.
- **Menghubungkan segmentasi ke keputusan**: segmen dengan revenue-at-risk tertinggi adalah prioritas retensi; rules dengan lift tinggi adalah kandidat bundling.
- **Menyadari batas unsupervised learning**: ia menemukan struktur, tetapi tidak memberi tahu **apa yang harus dilakukan**—keputusan membutuhkan model optimasi.
## Jembatan ke Bab 12
Kita telah membangun model prediktif (Bab 7–9), model waktu (Bab 10), dan segmentasi (Bab 11). Tetapi semua model ini menghasilkan **satu titik prediksi**—satu probabilitas, satu forecast, satu segmen.
Keputusan nyata selalu menghadapi **ketidakpastian**:
- Permintaan bisa lebih tinggi atau lebih rendah dari forecast.
- Churn bisa terjadi lebih cepat atau lebih lambat.
- Efektivitas intervensi bisa bervariasi.
**Simulasi Monte Carlo**—topik Bab 12—akan mengajarkan kita untuk **membangkitkan ribuan skenario** berdasarkan distribusi probabilitas dari data historis. Ini memungkinkan kita untuk:
- Menghitung **distribusi hasil**, bukan hanya nilai tunggal.
- Mengukur **risiko** (mis. probabilitas kerugian melebihi ambang tertentu).
- Mengevaluasi keputusan berdasarkan **expected value** dan **risk profile**.
Bab 12 adalah **jembatan terakhir** sebelum Bagian III: setelah kita dapat memprediksi, mengelompokkan, dan mensimulasikan, kita akan **mengoptimalkan**.