Code
import sys
sys.path.insert(0,".")
import pandas as pd
import numpy as np
from decanal.utils import load_churn

df = load_churn()
print(f"Bentuk awal: {df.shape[0]} baris × {df.shape[1]} kolom")
Bentuk awal: 7043 baris × 21 kolomTujuan pembelajaran. Setelah menyelesaikan bab ini, kita akan mampu: 1. Mengenali sumber data yang umum di organisasi dan memilih cara memuatnya dengan tepat. 2. Mendiagnosis masalah kualitas data secara sistematis—bukan hanya “menemukan yang hilang”, tetapi memahami mengapa ia hilang. 3. Menerapkan strategi penanganan nilai hilang, duplikat, dan outlier dengan pertimbangan konteks, bukan aturan mekanis. 4. Melakukan feature engineering dasar untuk menyiapkan dataset bagi pemodelan di Bagian II. 5. Menyimpan dataset bersih dengan tata kelola yang dapat direproduksi.
Di Bab 1 kita berkenalan dengan dataset mentah dan menemukan dua masalah: kolom TotalCharges bertipe salah, dan beberapa nilai kosong tersembunyi. Di dunia nyata, inilah norma, bukan pengecualian. Sebuah studi yang sering dikutip menyebutkan bahwa analis data menghabiskan 60–80% waktunya untuk menemukan, membersihkan, dan mengorganisasi data—bukan untuk membangun model.
Karena itu, wrangling bukan “pekerjaan kotor sebelum pekerjaan sesungguhnya”. Ia adalah pekerjaan sesungguhnya. Model terbaik sekalipun akan menghasilkan keputusan yang salah jika dilatih pada data yang salah—sebuah prinsip yang dikenal sebagai garbage in, garbage out.
Jika kita baru mengenal pandas, bab ini mungkin terasa padat. Fokuslah pada pola pikir: setiap keputusan wrangling harus dapat dijelaskan alasannya. Kode dapat dicari; penalaran harus dibangun.
Sebelum masuk ke teknik, penting untuk mengenali bahwa data datang dalam berbagai bentuk. Buku ini fokus pada file tabular karena itulah bentuk paling umum di lingkungan pengajaran, tetapi kita perlu tahu lanskapnya.
| Sumber | Contoh | Alat Python | Kapan dipakai |
|---|---|---|---|
| File datar | CSV, TSV, Excel | pandas.read_csv, read_excel |
Data kecil–menengah, transfer manual |
| Database relasional | PostgreSQL, MySQL, SQLite | SQLAlchemy + pandas.read_sql |
Data besar, banyak pengguna, integritas transaksional |
| API | REST endpoints (JSON) | requests, httpx |
Data real-time dari layanan eksternal |
| Semi-terstruktur | JSON, XML, Parquet | pandas.read_json, read_parquet |
Log, event streams, data bersarang |
| Data warehouse | BigQuery, Snowflake, Redshift | Driver native atau dbt |
Skala organisasi, analitik historis |
Untuk buku ini kita memakai file CSV karena paling mudah direproduksi dan disebarkan. Namun pola yang sama berlaku untuk sumber lain: muat → inspeksi → perbaiki → simpan.
Mengapa Parquet lebih baik dari CSV untuk dataset besar? CSV menyimpan semuanya sebagai teks; Parquet menyimpan tipe data secara biner, terkompresi, dan kolumnar. Untuk dataset berukuran gigabyte, Parquet bisa 10× lebih cepat dibaca. Kita tetap memakai CSV di buku ini karena lebih portabel, tetapi di produksi Parquet hampir selalu lebih baik.
Kualitas data bukan satu konsep tunggal. Literatur kualitas data biasanya membedakan enam dimensi, dan setiap dimensi memiliki teknik diagnosis dan perbaikan yang berbeda:
| Dimensi | Pertanyaan | Contoh masalah |
|---|---|---|
| Completeness | Apakah semua data yang seharusnya ada, ada? | TotalCharges kosong untuk pelanggan baru |
| Accuracy | Apakah nilainya benar? | Usia tercatat 200 tahun |
| Consistency | Apakah nilainya konsisten antarsumber/kolom? | Kota “Jakarta” vs “DKI Jakarta” |
| Timeliness | Apakah datanya cukup baru untuk keputusan? | Data churn 3 tahun lalu untuk prediksi hari ini |
| Uniqueness | Apakah ada duplikasi? | Pelanggan yang sama tercatat dua kali |
| Validity | Apakah nilainya memenuhi aturan domain? | tenure = -5 (bulan negatif) |
Bab ini akan menyentuh kelima dimensi pertama; timeliness akan menjadi fokus khusus di Bab 10 (Time Series).
Mari kita muat ulang dataset dengan pola yang konsisten—menggunakan helper code/utils.py yang sudah diperkenalkan di Bab 1.
import sys
sys.path.insert(0,".")
import pandas as pd
import numpy as np
from decanal.utils import load_churn
df = load_churn()
print(f"Bentuk awal: {df.shape[0]} baris × {df.shape[1]} kolom")Bentuk awal: 7043 baris × 21 kolomTidak semua nilai hilang diciptakan sama. Dalam statistika, kita membedakan tiga mekanisme:
Membedakan MCAR, MAR, dan MNAR dari data saja tidak selalu mungkin. Yang penting adalah menyadari mekanismenya dan tidak melakukan imputasi yang menghasilkan bias sistematis. Sebagai aturan praktis: jika proporsi nilai hilang kecil (<5%) dan tidak berpola, penghapusan sederhana biasanya aman.
Pelajaran pertama Bab 1 terulang di sini: isna() tidak selalu cukup. Nilai kosong bisa direpresentasikan sebagai string " ", "NA", "?", "-", 0 (padahal 0 berarti tidak ada), atau 999 (kode sentinel).
missing = df.isna().sum().sort_values(ascending=False)
print("--- Nilai NaN eksplisit ---")
print(missing[missing > 0])
--- Nilai NaN eksplisit ---
Series([], dtype: int64)Hasilnya kosong atau sangat sedikit. Namun kita tahu dari Bab 1 bahwa TotalCharges bermasalah. Mari kita periksa dengan pendekatan yang lebih teliti:
tc = df["TotalCharges"]
print(f"Tipe data: {tc.dtype}")
print(f"Nilai unik yang bukan angka: {sorted(set(tc) - set(pd.to_numeric(tc, errors='coerce').dropna().astype(str)), key=str)[:5]}")
print(f"Jumlah string kosong: {(tc.str.strip() == '').sum() if tc.dtype == object else 0}")
Tipe data: object
Nilai unik yang bukan angka: [' ', '1010', '1024', '1032', '1033']
Jumlah string kosong: 11Nilai " " (satu spasi) itulah yang membuat pandas menganggap seluruh kolom sebagai object. Ini adalah contoh sempurna dari nilai hilang tersembunyi: secara logis NaN, tetapi secara tekstual tampak “ada”.
Untuk TotalCharges, konteksnya sangat jelas: pelanggan dengan tenure = 0 (baru mendaftar) belum memiliki total tagihan. Ini adalah MCAR yang ditentukan domain—hilangnya nilai adalah konsekuensi dari status pelanggan, bukan dari nilai yang hilang itu sendiri.
Tiga strategi yang mungkin:
| Strategi | Kelebihan | Kekurangan |
|---|---|---|
| Drop baris | Sederhana | Kehilangan 11 pelanggan (dari 7.043) — tidak signifikan |
| Imputasi 0 | Masuk akal domain | Menciptakan nilai yang secara semantik berarti “belum ada tagihan” |
| Imputasi median | Mempertahankan distribusi | Menyesatkan: pelanggan baru dianggap punya tagihan rata-rata |
Keputusan: imputasi 0 untuk pelanggan dengan tenure = 0, dan drop baris yang masih kosong setelahnya (jika ada). Alasan: pelanggan baru memang belum memiliki tagihan; 0 adalah representasi yang benar secara semantik, bukan sekadar “menambal” angka.
# Konversi ke numerik; string kosong menjadi NaN
df["TotalCharges"] = pd.to_numeric(df["TotalCharges"], errors="coerce")

# Diagnostik: siapa yang NaN?
mask_nan = df["TotalCharges"].isna()
print(f"Baris dengan TotalCharges NaN: {mask_nan.sum()}")
print(f"Tenure pada baris tersebut: {df.loc[mask_nan, 'tenure'].unique()}")

# Imputasi 0 untuk pelanggan baru
df.loc[mask_nan & (df["tenure"] == 0), "TotalCharges"] = 0.0

# Sisa NaN (jika ada) kita drop dengan log
sisa = df["TotalCharges"].isna().sum()
print(f"NaN tersisa setelah imputasi: {sisa}")
Baris dengan TotalCharges NaN: 11
Tenure pada baris tersebut: [0]
NaN tersisa setelah imputasi: 0print(f"Tipe akhir: {df['TotalCharges'].dtype}")
print(f"Rentang : [{df['TotalCharges'].min():.2f}, {df['TotalCharges'].max():.2f}]")
df[["tenure", "MonthlyCharges", "TotalCharges"]].describe().round(2)Tipe akhir: float64
Rentang : [0.00, 8684.80]| tenure | MonthlyCharges | TotalCharges | |
|---|---|---|---|
| count | 7043.00 | 7043.00 | 7043.00 |
| mean | 32.37 | 64.76 | 2279.73 |
| std | 24.56 | 30.09 | 2266.79 |
| min | 0.00 | 18.25 | 0.00 |
| 25% | 9.00 | 35.50 | 398.55 |
| 50% | 29.00 | 70.35 | 1394.55 |
| 75% | 55.00 | 89.85 | 3786.60 |
| max | 72.00 | 118.75 | 8684.80 |
dup_rows = df.duplicated().sum()
dup_ids = df["customerID"].duplicated().sum()
print(f"Baris duplikat penuh  : {dup_rows}")
print(f"customerID duplikat   : {dup_ids}")
Baris duplikat penuh : 0
customerID duplikat : 0Jika ada duplikat, keputusan standarnya adalah menyimpan yang pertama (df.drop_duplicates()), kecuali ada alasan domain untuk menyimpan yang lain (misalnya, catatan terbaru berdasarkan timestamp).
Nilai kategorikal sering masuk dalam variasi yang tidak konsisten: "Yes" vs "yes", "Jakarta" vs " DKI Jakarta ". Periksa nilai unik untuk kolom kategorikal penting:
for col in ["gender", "Contract", "PaymentMethod", "InternetService"]:
    if col in df.columns:
        uniques = df[col].dropna().unique()
        print(f"\n--- {col} ({len(uniques)} nilai unik) ---")
        print(uniques)
--- gender (2 nilai unik) ---
['Female' 'Male']

--- Contract (3 nilai unik) ---
['Month-to-month' 'One year' 'Two year']

--- PaymentMethod (4 nilai unik) ---
['Electronic check' 'Mailed check' 'Bank transfer (automatic)'
 'Credit card (automatic)']

--- InternetService (3 nilai unik) ---
['DSL' 'Fiber optic' 'No']
Gunakan .str.strip() untuk menghapus spasi di tepi, dan .str.title() atau mapping manual untuk menyamakan kapitalisasi jika perlu. Pada dataset ini nilainya sudah konsisten—tetapi periksa selalu, karena dataset publik pun kadang tidak konsisten.
# Normalisasi defensif: strip spasi di semua kolom string
obj_cols = df.select_dtypes(include="object").columns
for col in obj_cols:
    if col != "customerID":  # ID tidak boleh diubah
        df[col] = df[col].str.strip()
print(f"Kolom string yang dinormalisasi: {list(obj_cols)}")
Kolom string yang dinormalisasi: ['customerID', 'gender', 'Partner', 'Dependents', 'PhoneService', 'MultipleLines', 'InternetService', 'OnlineSecurity', 'OnlineBackup', 'DeviceProtection', 'TechSupport', 'StreamingTV', 'StreamingMovies', 'Contract', 'PaperlessBilling', 'PaymentMethod', 'Churn']Outlier adalah nilai yang jauh dari mayoritas data. Mereka bisa menjadi sumber insight (misalnya, pelanggan premium) atau sumber noise (misalnya, kesalahan entri). Yang penting adalah mendeteksinya secara sadar, bukan menghapusnya membabi buta.
Aturan paling umum: nilai di luar rentang [Q1 - 1.5×IQR, Q3 + 1.5×IQR] dianggap outlier.
def count_iqr_outliers(series: pd.Series) -> int:
    q1, q3 = series.quantile([0.25, 0.75])
    iqr = q3 - q1
    lower, upper = q1 - 1.5 * iqr, q3 + 1.5 * iqr
    return ((series < lower) | (series > upper)).sum()

for col in ["tenure", "MonthlyCharges", "TotalCharges"]:
    print(f"{col:16s}: {count_iqr_outliers(df[col]):3d} outlier")
tenure : 0 outlier
MonthlyCharges : 0 outlier
TotalCharges : 0 outlierAlternatif: nilai dengan |z| > 3 dianggap outlier. Cocok ketika distribusi mendekati normal.
from scipy import stats

for col in ["tenure", "MonthlyCharges", "TotalCharges"]:
    z = np.abs(stats.zscore(df[col]))
    print(f"{col:16s}: {(z > 3).sum():3d} outlier (|z| > 3)")
tenure : 0 outlier (|z| > 3)
MonthlyCharges : 0 outlier (|z| > 3)
TotalCharges : 0 outlier (|z| > 3)Aturan praktis. Jangan hapus outlier hanya karena terdeteksi secara statistik. Tanyakan dulu:
MonthlyCharges = 120 mungkin memang ada (paket premium). Bukan outlier untuk dihapus.200 atau tagihan -50 adalah kesalahan—perbaiki atau hapus.Untuk dataset Telco, hasil pemeriksaan IQR menunjukkan nol outlier pada ketiga kolom numerik. Ini adalah kabar baik: seluruh nilai berada dalam rentang yang wajar untuk domainnya. Ini juga pengingat bahwa outlier bukanlah masalah universal—banyak dataset publik sudah dibersihkan sebelumnya.
import matplotlib.pyplot as plt

fig, axes = plt.subplots(1, 3, figsize=(10, 3))
for ax, col in zip(axes, ["tenure", "MonthlyCharges", "TotalCharges"]):
    ax.boxplot(df[col], vert=True)
    ax.set_title(col)
    ax.set_ylabel("Nilai")
plt.tight_layout()
plt.show()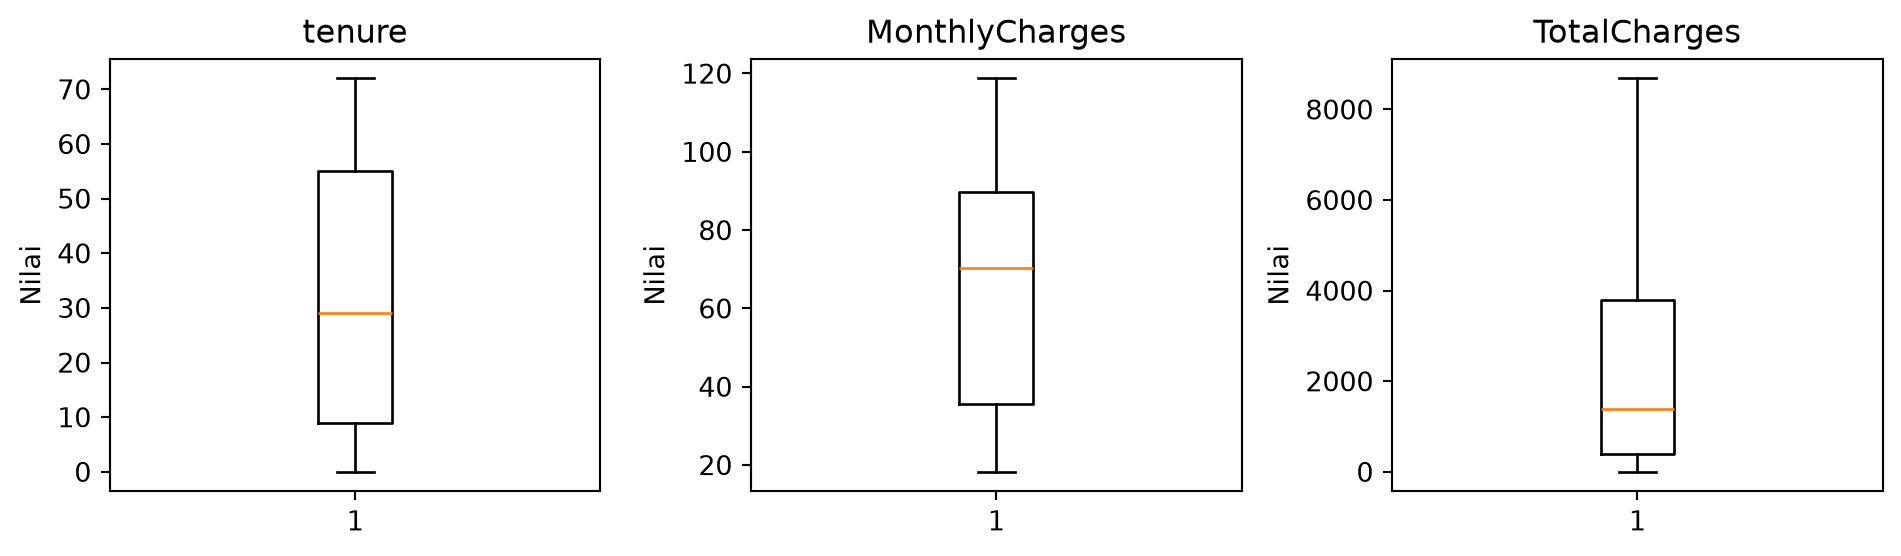
Feature engineering adalah seni membuat variabel baru dari variabel yang ada untuk memperkaya model. Ia bukan sekadar trik teknis—ia adalah tempat pengetahuan domain bertemu data.
Variabel seperti tenure (bulan) sulit diinterpretasikan dalam bentuk mentah. Mengelompokkannya ke dalam bin membuatnya lebih bermakna secara bisnis dan sering meningkatkan performa model.
# Bin tenure ke kelompok bermakna secara bisnis
bins = [-1, 6, 12, 24, 48, np.inf]
labels = ["0-6 bln", "7-12 bln", "13-24 bln", "25-48 bln", ">48 bln"]

df["tenure_group"] = pd.cut(df["tenure"], bins=bins, labels=labels)
df["tenure_group"].value_counts().sort_index()
tenure_group
0-6 bln 1481
7-12 bln 705
13-24 bln 1024
25-48 bln 1594
>48 bln 2239
Name: count, dtype: int64Model machine learning hanya memahami angka. Variabel kategorikal harus dikodekan. Dua strategi utama:
pd.get_dummies): membuat kolom biner untuk setiap kategori. Cocok untuk variabel nominal (tanpa urutan).Contract: month-to-month < one year < two year).Jangan ordinal-encode variabel nominal seperti PaymentMethod atau InternetService. Memberi angka sembarang akan menciptakan hubungan palsu yang menyesatkan model linear. Untuk variabel nominal, selalu one-hot.
Untuk buku ini, kita tidak melakukan encoding di Bab 2. Encoding akan dilakukan di dalam pipeline scikit-learn di Bab 8–9 agar tidak terjadi data leakage antara data latih dan uji. Bab 2 hanya menyiapkan kolom kategorikal apa adanya.
Beberapa fitur turunan yang masuk akal untuk dataset Telco:
# Jumlah layanan berlangganan (proxy "keterikatan pelanggan")
service_cols = ["PhoneService", "MultipleLines", "OnlineSecurity",
                "OnlineBackup", "DeviceProtection", "TechSupport",
                "StreamingTV", "StreamingMovies"]
df["num_services"] = (df[service_cols] == "Yes").sum(axis=1)

# Rasio tagihan bulanan terhadap total (proxy "lama berlangganan efektif")
df["charge_ratio"] = df["TotalCharges"] / (df["MonthlyCharges"] * df["tenure"] + 1)

print(df[["num_services", "charge_ratio"]].describe().round(2))
num_services charge_ratio
count 7043.00 7043.00
mean 3.36 0.99
std 2.06 0.06
min 0.00 0.00
25% 1.00 0.97
50% 3.00 1.00
75% 5.00 1.02
max 8.00 1.53Fitur-fitur ini akan dipertimbangkan saat membangun model di Bagian II, bukan langsung dipakai. Kadang fitur turunan membantu; kadang ia hanya menambah noise. Kita akan mengujinya secara empiris.
Setelah semua transformasi, simpan dataset bersih ke data/processed/. Ini memberi kita satu titik referensi untuk semua bab selanjutnya—jika terjadi kesalahan, kita tahu persis versi data apa yang digunakan.
from pathlib import Path

out = Path("data/processed/telco_clean.csv")
out.parent.mkdir(parents=True, exist_ok=True)

# Drop kolom yang tidak akan dipakai
cols_to_drop = ["customerID"]  # pengenal unik, bukan fitur
df_clean = df.drop(columns=cols_to_drop)

df_clean.to_csv(out, index=False)
print(f"Dataset bersih: {df_clean.shape[0]} baris × {df_clean.shape[1]} kolom")
print(f"Disimpan di   : {out.resolve()}")
Dataset bersih: 7043 baris × 23 kolom
Disimpan di : /Users/chakraroy/Documents/Ebook/Decision-Analytics/data/processed/telco_clean.csvSelalu catat transformasi yang dilakukan. Idealnya dalam file data/README.md atau skrip code/prepare_data.py yang menjalankan seluruh alur dari mentah ke bersih secara otomatis. Prinsipnya: jika kita harus mengulang wrangling dari awal, kita tidak ingin mengingat-ingat apa yang sudah dilakukan. Skrip yang dapat dijalankan ulang adalah dokumentasi terbaik.
Verifikasi bahwa dataset tersimpan dengan benar:
df_check = pd.read_csv("data/processed/telco_clean.csv")
print(f"Bentuk  : {df_check.shape}")
print(f"Kolom   : {df_check.columns.tolist()}")
print(f"Tipe    : \n{df_check.dtypes.value_counts()}")
Bentuk : (7043, 23)
Kolom : ['gender', 'SeniorCitizen', 'Partner', 'Dependents', 'tenure', 'PhoneService', 'MultipleLines', 'InternetService', 'OnlineSecurity', 'OnlineBackup', 'DeviceProtection', 'TechSupport', 'StreamingTV', 'StreamingMovies', 'Contract', 'PaperlessBilling', 'PaymentMethod', 'MonthlyCharges', 'TotalCharges', 'Churn', 'tenure_group', 'num_services', 'charge_ratio']
Tipe :
object 17
int64 3
float64 3
Name: count, dtype: int64Latihan 2.1 — Mekanisme nilai hilang. Untuk setiap kolom yang masih memiliki NaN (jika ada), tentukan apakah mekanismenya MCAR, MAR, atau MNAR. Jelaskan alasannya dalam satu paragraf. Jika tidak ada NaN tersisa, jelaskan mengapa Bab 1 menemukan “nilai hilang” padahal Bab 2 tidak.
Latihan 2.2 — Encoding alternatif. Kode di Bab 2 memakai pd.cut untuk tenure. Coba ganti dengan pd.qcut (kuantil). Bandingkan distribusi kelompok yang dihasilkan. Kapan kita memilih cut (bin yang ditentukan domain) dan kapan qcut (bin yang ditentukan data)?
Latihan 2.3 — Fitur turunan yang diuji. Fitur charge_ratio yang kita buat punya rumus TotalCharges / (MonthlyCharges × tenure + 1). Untuk pelanggan dengan tenure = 0, nilai ini menjadi 0 / (0 + 1) = 0. Apakah ini masuk akal? Bagaimana kita akan mendefinisikannya ulang agar lebih bermakna? (Petunjuk: lihat pelanggan dengan tenure ≥ 1 saja.)
Latihan 2.4 — Skrip yang dapat dijalankan ulang. Buat file code/prepare_data.py yang menjalankan seluruh wrangling di bab ini dari mentah ke bersih, dengan satu perintah python code/prepare_data.py. Ini adalah latihan penting untuk reproduksibilitas—keterampilan yang akan terus kita pakai di sepanjang karier.
Petunjuk Latihan 2.1. Jika kita hanya menemukan TotalCharges yang bermasalah di Bab 1, itu karena nilai hilang di kolom lain tidak ada—dataset Telco relatif bersih. Ketika kita bekerja dengan dataset nyata, kita akan menemukan bahwa nilai hilang tersebar di banyak kolom, dan diagnosis mekanisme menjadi jauh lebih penting.
Jembatan. Bab 2 memengaruhi keputusan di tiga tingkat:
Keputusan tentang kepercayaan. Setelah wrangling, kita kini dapat menjawab pertanyaan dengan TotalCharges tanpa ragu bahwa nilainya mencerminkan string atau bukan. Analisis rata-rata tagihan pelanggan baru kini valid.
Keputusan tentang metrik. Mengetahui bahwa 11 pelanggan baru memiliki TotalCharges = 0 (setelah imputasi) memberi tahu kita bahwa rata-rata tagihan akan bias ke bawah jika tidak difilter. Keputusan pengukuran KPI pelanggan baru harus menggunakan median atau subset.
Keputusan tentang fitur. Menambahkan tenure_group dan num_services bukan sekadar trik teknis—ini adalah hipotesis: “Pelanggan baru mungkin berperilaku berbeda dari pelanggan lama; pelanggan dengan lebih banyak layanan mungkin lebih setia.” Hipotesis ini akan diuji di Bagian II. Jika terbukti, mereka memengaruhi strategi retensi; jika tidak, mereka hanya menambah noise dan harus dibuang.
Wrangling yang baik adalah pertanyaan yang diajukan dengan hati-hati kepada data—bukan sekadar pembersihan mekanis.
Dalam bab ini kita telah:
TotalCharges dengan keputusan berbasis domain—imputasi 0 untuk pelanggan baru, bukan drop yang kehilangan informasi.tenure_group, num_services, charge_ratio) yang akan diuji secara empiris di Bagian II, bukan langsung dipakai.data/processed/telco_clean.csv dan memverifikasi hasilnya.Dataset kita kini bersih, konsisten, dan tersimpan. Tetapi kita belum benar-benar melihatnya. Berapa rata-rata pelanggan yang churn? Apakah pelanggan dengan kontrak bulanan lebih sering churn? Apakah MonthlyCharges berbeda antara pelanggan yang churn dan yang bertahan?
Bab berikutnya—Statistik Deskriptif & Eksplorasi Data—akan mulai menjawab pertanyaan-pertanyaan ini secara sistematis. Kita akan berkenalan dengan ukuran pusat dan sebaran, uji statistik dasar, dan mulai membangun intuisi tentang dataset yang akan menjadi fondasi semua analisis berikutnya.