---
jupyter: decanal
---
# Diagnostic Analytics {#sec-diagnostik}
::: {.callout-note appearance="simple"}
**Tujuan pembelajaran.** Setelah menyelesaikan bab ini, kita akan mampu:
1. Membedakan pertanyaan deskriptif ("apa") dari pertanyaan diagnostik ("mengapa").
2. Menerapkan stratifikasi dan *drill-down* untuk mengurai pola yang tampak sederhana.
3. Mengenali **Simpson's Paradox** dan memahami mengapa agregasi bisa menyesatkan.
4. Menggunakan analisis kohort untuk memahami bagaimana perilaku berubah sepanjang siklus hidup pelanggan.
5. Menerapkan kerangka *root cause analysis* (5 Whys, Ishikawa) pada data.
6. Memisahkan korelasi dari kausalitas secara eksplisit—dan tahu kapan diagnosis berhenti menjadi bukti.
:::
## Dari "Apa" ke "Mengapa"
Di Bab 3 kita menemukan bahwa pelanggan kontrak bulanan churn sekitar 43%, sementara kontrak dua tahun hanya sekitar 3%. Di Bab 4 kita melihatnya dalam bar chart dan langsung menangkap besarnya perbedaan.
Tetapi **mengapa**? Apakah karena kontrak bulanan *menyebabkan* churn? Atau karena pelanggan yang *berniat* churn memang memilih kontrak bulanan? Atau karena ada faktor ketiga—usia, tenure, jenis layanan—yang menjelaskan keduanya?
Pertanyaan-pertanyaan inilah yang menjadi inti **diagnostic analytics**. Ia tidak berhenti pada pola; ia mengejar **mekanisme** di balik pola.
::: {.callout-important}
**Perbedaan mendasar.**
- **Descriptive**: *"Churn rate kontrak bulanan 43%."* — Fakta.
- **Diagnostic**: *"Churn rate kontrak bulanan tinggi **karena** pelanggan baru cenderung memilih kontrak bulanan, dan pelanggan baru memiliki churn rate tinggi terlepas dari kontrak."* — Mekanisme.
Yang kedua jauh lebih berguna untuk keputusan, karena ia menunjukkan **di mana intervensi harus diarahkan**.
:::
## Pola Pikir Diagnostik
Seorang analis diagnostik yang baik mengajukan pertanyaan berlapis:
1. **Apa yang kita lihat?** (deskriptif)
2. **Apakah pola ini nyata, atau artefak dari cara kita mengagregasi data?** (stratifikasi)
3. **Variabel mana yang paling menjelaskan pola ini?** (atribusi)
4. **Apakah hubungan ini kausal, atau ada penjelasan lain?** (kausalitas)
5. **Jika pola ini benar, apa implikasinya untuk keputusan?** (aksi)
Bab ini akan memandu kita melalui kelima lapisan ini menggunakan dataset Telco.
## Stratifikasi: Mengurai Pola yang Tampak Sederhana
**Stratifikasi** adalah teknik paling dasar dalam diagnostic analytics: memecah data menjadi subkelompok berdasarkan satu atau lebih variabel, lalu memeriksa apakah pola yang kita amati bertahan di setiap subkelompok.
### Contoh Pertama: Apakah Efek Kontrak Bertahan di Semua Tingkat Tenure?
Di Bab 3 kita melihat bahwa kontrak bulanan memiliki churn rate jauh lebih tinggi. Tetapi pelanggan kontrak bulanan juga cenderung **baru** (tenure pendek). Apakah efek kontrak bertahan ketika kita mengontrol tenure?
```{python}
#| label: stratify-contract-tenure
import sys
sys.path.insert(0, ".")
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns

from decanal.utils import load_churn_clean

df = load_churn_clean()

# Buat kelompok tenure
df["tenure_bin"] = pd.cut(
    df["tenure"], bins=[-1, 6, 12, 24, 48, np.inf],
    labels=["0-6", "7-12", "13-24", "25-48", ">48"]
)

# Churn rate per (tenure_bin, Contract)
strat = (df.groupby(["tenure_bin", "Contract"], observed=True)["Churn"]
           .apply(lambda s: (s == "Yes").mean() * 100)
           .round(1)
           .unstack())

strat
```
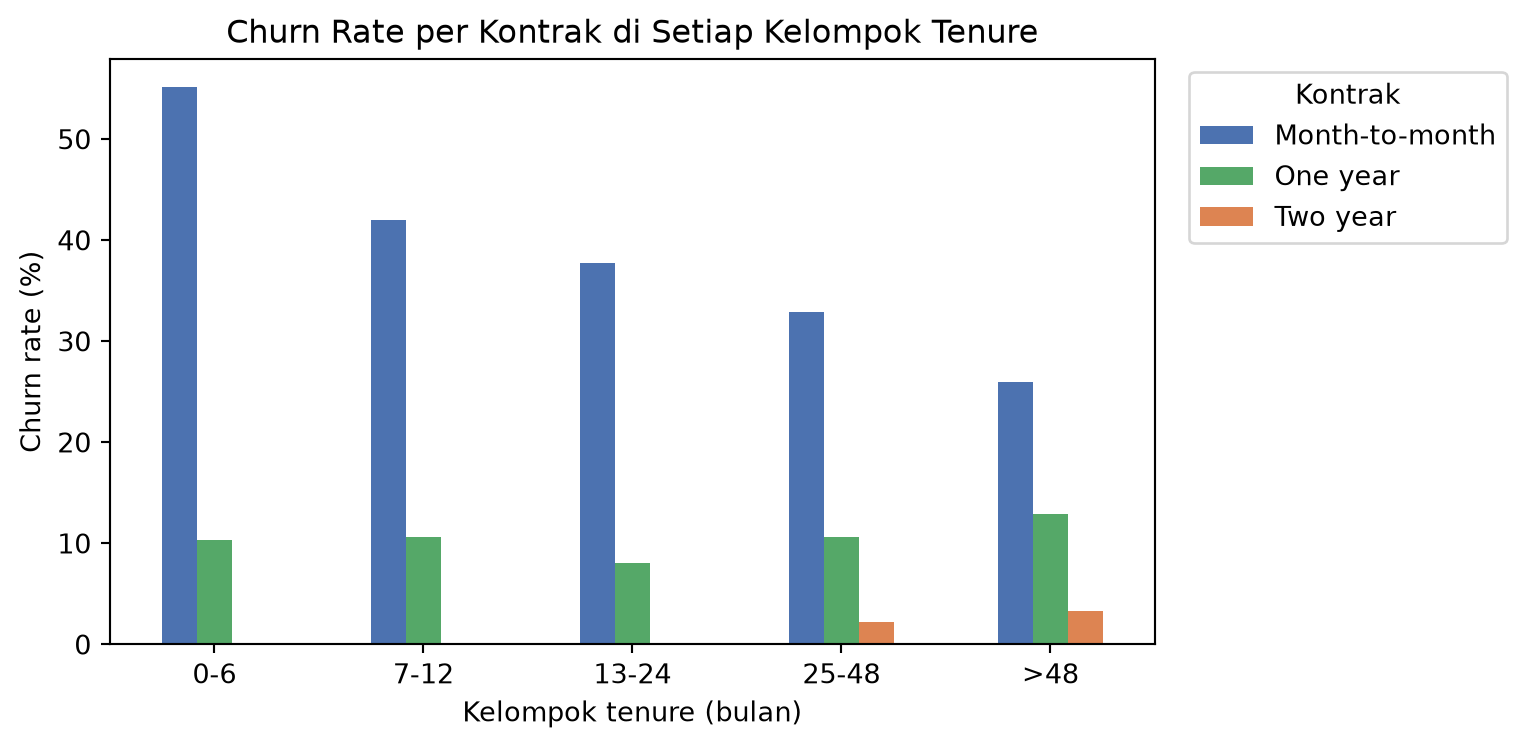
**Cara membaca.** Setiap baris adalah kelompok tenure. Setiap kolom adalah tipe kontrak. Angka di dalam sel adalah churn rate (%) untuk kombinasi tersebut.
Jika efek kontrak **bertahan di setiap tingkat tenure**, kita akan melihat pola yang konsisten: kolom `Month-to-month` selalu lebih tinggi dari `One year`, yang selalu lebih tinggi dari `Two year`. Jika efeknya **hilang** di beberapa tingkat, itu tanda bahwa efek kontrak sebenarnya **dijelaskan oleh tenure**.
```{python}
#| label: fig-strat-contract-tenure
#| fig-cap: "Churn rate per kontrak, dipisah per kelompok tenure. Pola konsisten di semua kelompok."
#| fig-width: 8
#| fig-height: 4
fig, ax = plt.subplots(figsize=(8, 4))
strat.plot(kind="bar", ax=ax, color=["#4C72B0", "#55A868", "#DD8452"])
ax.set_xlabel("Kelompok tenure (bulan)")
ax.set_ylabel("Churn rate (%)")
ax.set_title("Churn Rate per Kontrak di Setiap Kelompok Tenure")
ax.legend(title="Kontrak", bbox_to_anchor=(1.02, 1), loc="upper left")
ax.set_xticklabels(ax.get_xticklabels(), rotation=0)
plt.tight_layout()
plt.show()
```
**Temuan.** Efek kontrak **bertahan di semua kelompok tenure**—bahkan di antara pelanggan yang baru bergabung (0–6 bulan), kontrak bulanan memiliki churn rate yang jauh lebih tinggi. Ini menunjukkan bahwa efek kontrak **bukan artefak dari tenure**. Kontrak itu sendiri (atau faktor yang berkorelasi dengannya) memang berperan.
::: {.callout-tip}
**Prinsip stratifikasi.** Ketika kita mencurigai bahwa pola X→Y sebenarnya dijelaskan oleh variabel Z, **stratifikasi berdasarkan Z**. Jika pola X→Y bertahan di setiap tingkat Z, Z bukan penjelas utama. Jika pola X→Y hilang setelah stratifikasi, Z-lah yang sebenarnya berperan.
:::
## Simpson's Paradox: Ketika Agregasi Menyesatkan
**Simpson's Paradox** adalah fenomena di mana sebuah tren muncul dalam data agregat, tetapi **terbalik** ketika data dipecah menjadi subkelompok. Ini adalah salah satu jebakan paling berbahaya dalam analisis data—dan salah satu alasan paling kuat mengapa stratifikasi bukan opsional.
### Contoh Klasik
Bayangkan dua rumah sakit. Rumah sakit A memiliki tingkat kematian keseluruhan 10%, rumah sakit B 15%. Sekilas, A tampak lebih baik. Tetapi ketika kita memecah pasien berdasarkan tingkat keparahan:
| | Pasien ringan | Pasien berat |
|---|---|---|
| **RS A** | 100 pasien, 5 meninggal (5%) | 900 pasien, 95 meninggal (10,6%) |
| **RS B** | 800 pasien, 80 meninggal (10%) | 200 pasien, 22 meninggal (11%) |
Di **setiap** tingkat keparahan, RS A memiliki tingkat kematian lebih rendah. Tetapi secara agregat, RS A tampak lebih buruk—karena RS A menerima **lebih banyak pasien berat**. Ini adalah Simpson's Paradox: tren agregat menyesatkan karena distribusi subkelompok tidak seimbang.
### Mencari Simpson's Paradox di Dataset Telco
Mari kita cari apakah ada Simpson's Paradox di dataset kita. Kita akan memeriksa hubungan antara `InternetService` dan `Churn`, dengan `Contract` sebagai variabel stratifikasi.
```{python}
#| label: simpson-check
# Agregat: churn rate per InternetService
agregat = (df.groupby("InternetService")["Churn"]
             .apply(lambda s: (s == "Yes").mean() * 100)
             .round(1))
print("--- Agregat ---")
print(agregat)

# Stratifikasi: churn rate per (InternetService, Contract)
strat_internet = (df.groupby(["InternetService", "Contract"], observed=True)["Churn"]
                    .apply(lambda s: (s == "Yes").mean() * 100)
                    .round(1)
                    .unstack())
print("\n--- Stratifikasi per Contract ---")
print(strat_internet)
```
Perhatikan: secara agregat, `Fiber optic` memiliki churn rate tertinggi. Tetapi ketika kita stratifikasi berdasarkan `Contract`, apakah urutan ini bertahan? Jika ya, efek `InternetService` nyata. Jika tidak—jika dalam setiap tipe kontrak urutannya berubah—kita mungkin sedang melihat Simpson's Paradox.
::: {.callout-warning}
**Mengapa ini penting?** Keputusan berdasarkan data agregat bisa **sepenuhnya salah arah**. Jika kita melihat "fiber optic memiliki churn tertinggi" dan memutuskan untuk menghentikan layanan fiber optic, kita mungkin menghancurkan bisnis—padahal masalah sebenarnya adalah **komposisi pelanggan** (pelanggan fiber optic lebih sering memilih kontrak bulanan), bukan layanan itu sendiri.
Selalu stratifikasi ketika variabel stratifikasi (di sini: `Contract`) **berkorelasi dengan variabel penjelas** (`InternetService`) **dan** dengan target (`Churn`).
:::
## Drill-Down: Menelusuri Ke Dalam
**Drill-down** adalah teknik memperdalam analisis dengan menambahkan dimensi. Jika agregat memberi kita gambaran besar, drill-down memberi kita detail yang menjelaskan gambaran itu.
### Contoh: Churn Rate per Segmen Bertingkat
```{python}
#| label: drill-down
# Level 1: Contract
level1 = (df.groupby("Contract")["Churn"]
            .apply(lambda s: (s == "Yes").mean() * 100)
            .round(1))
print("--- Level 1: Contract ---")
print(level1)

# Level 2: Contract × InternetService
level2 = (df.groupby(["Contract", "InternetService"], observed=True)["Churn"]
            .apply(lambda s: (s == "Yes").mean() * 100)
            .round(1)
            .unstack())
print("\n--- Level 2: Contract × InternetService ---")
print(level2)

# Level 3: Contract × InternetService × Partner
level3 = (df.groupby(["Contract", "InternetService", "Partner"], observed=True)["Churn"]
            .apply(lambda s: (s == "Yes").mean() * 100)
            .round(1)
            .unstack())
print("\n--- Level 3: Contract × InternetService × Partner ---")
print(level3.head(12))
```
**Cara membaca drill-down.** Di setiap level, kita menambahkan satu dimensi. Jika churn rate berubah drastis antar subkelompok, kita menemukan **segmen yang sangat berbeda**—dan segmen itulah yang paling membutuhkan perhatian.
::: {.callout-note}
**Hati-hati dengan sampel kecil.** Semakin dalam drill-down, semakin kecil ukuran sampel per sel. Churn rate 50% dari 10 pelanggan jauh kurang dapat diandalkan daripada 50% dari 1.000 pelanggan. **Selalu periksa ukuran sampel** saat melakukan drill-down—ini adalah alasan kita menambahkan `count` di dashboard Bab 4.
:::
## Analisis Kohort: Bagaimana Perilaku Berubah Sepanjang Waktu
**Kohort** adalah kelompok pelanggan yang berbagi karakteristik umum—biasanya **waktu bergabung**. Analisis kohort menjawab pertanyaan: *"Bagaimana perilaku pelanggan berubah seiring bertambahnya usia mereka dalam layanan?"*
Untuk dataset Telco, kita tidak memiliki tanggal bergabung yang eksplisit, tetapi kita memiliki `tenure` (bulan sejak bergabung). Kita dapat membentuk kohort berdasarkan `tenure` dan melihat bagaimana churn rate berubah.
### Churn Rate per Kelompok Tenure
```{python}
#| label: cohort-tenure
# Churn rate per kelompok tenure (kohort berdasarkan lama berlangganan)
kohort = (df.groupby("tenure_bin", observed=True)
            .agg(
                jumlah=("Churn", "size"),
                churn_rate=("Churn", lambda s: (s == "Yes").mean() * 100)
            )
            .round(1))
kohort
```
```{python}
#| label: fig-cohort-tenure
#| fig-cap: "Churn rate per kelompok tenure. Churn tertinggi pada pelanggan baru; menurun seiring tenure."
#| fig-width: 8
#| fig-height: 4
fig, ax1 = plt.subplots(figsize=(8, 4))

x = np.arange(len(kohort))
bars = ax1.bar(x, kohort["churn_rate"], color="#DD8452", alpha=0.8)
ax1.bar_label(bars, fmt="%.1f%%", padding=3)
ax1.set_xticks(x)
ax1.set_xticklabels(kohort.index, rotation=0)
ax1.set_xlabel("Kelompok tenure (bulan)")
ax1.set_ylabel("Churn rate (%)", color="#DD8452")
ax1.set_title("Churn Rate per Kelompok Tenure")

# Sumbu kedua untuk jumlah pelanggan
ax2 = ax1.twinx()
ax2.plot(x, kohort["jumlah"], color="#4C72B0", marker="o", linewidth=2)
ax2.set_ylabel("Jumlah pelanggan", color="#4C72B0")

plt.tight_layout()
plt.show()
```
::: {.callout-warning}
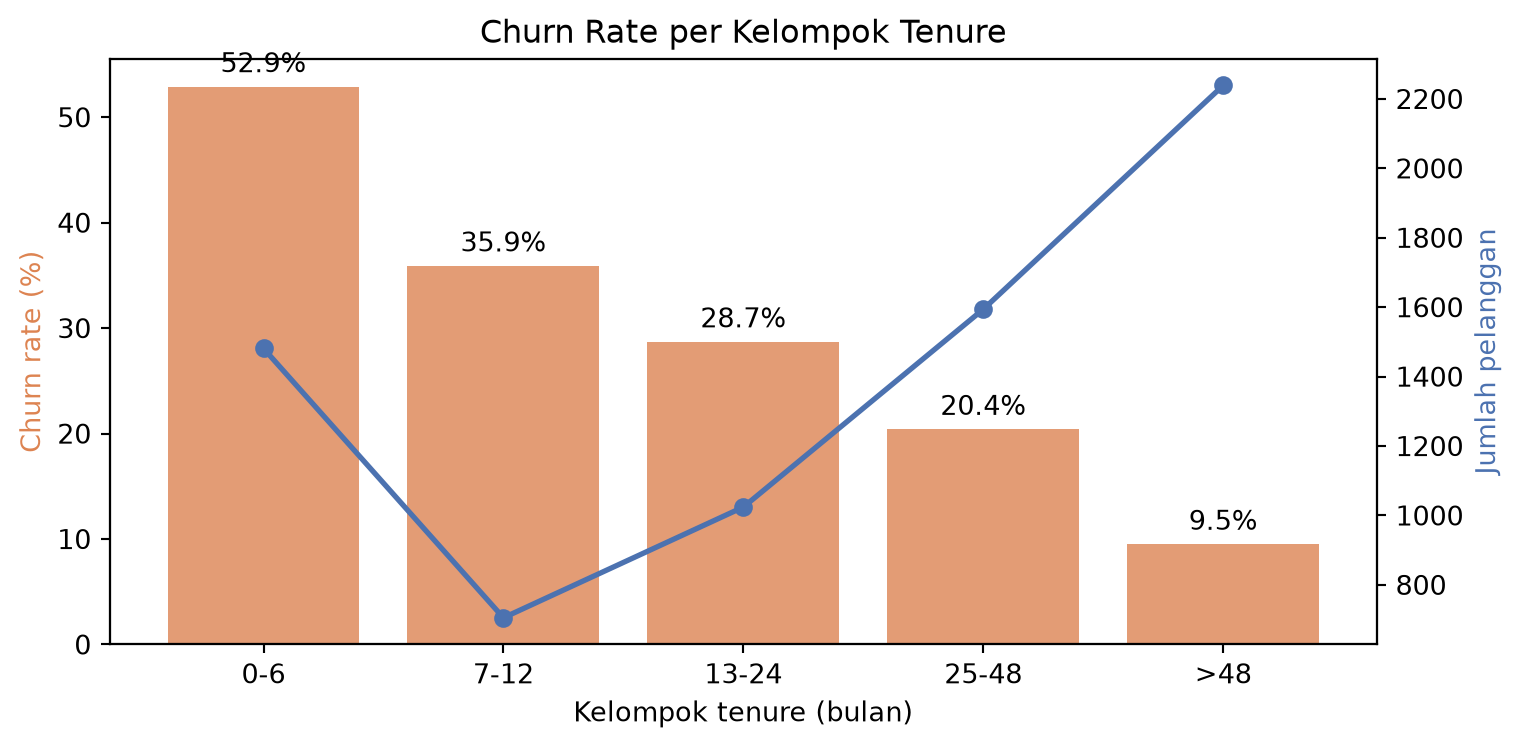
**Kesalahan umum: dual axis.** Grafik di atas menggunakan dual axis (churn rate di kiri, jumlah di kanan). Seperti yang diperingatkan di Bab 4, dual axis bisa menyesatkan—tetapi di sini saya menggunakannya **secara sadar** untuk menunjukkan bahwa churn rate tinggi di kelompok tenure pendek **bertepatan** dengan jumlah pelanggan yang juga besar. Insight ini penting: masalah churn paling akut bukan hanya karena rate-nya tinggi, tetapi karena **volume pelanggan baru juga besar**. Jika kita mempublikasikan grafik ini, beri anotasi eksplisit bahwa dua sumbu memiliki skala berbeda.
:::
**Temuan.** Churn rate **tertinggi pada pelanggan baru** (0–6 bulan: ~53%) dan **menurun drastis** seiring tenure. Pelanggan dengan tenure > 48 bulan memiliki churn rate sangat rendah (~7%). Ini menunjukkan bahwa **risiko churn paling besar ada di awal siklus hidup pelanggan**—dan intervensi retensi paling efektif jika dilakukan **segera setelah onboarding**.
### Kurva "Survival" Sederhana
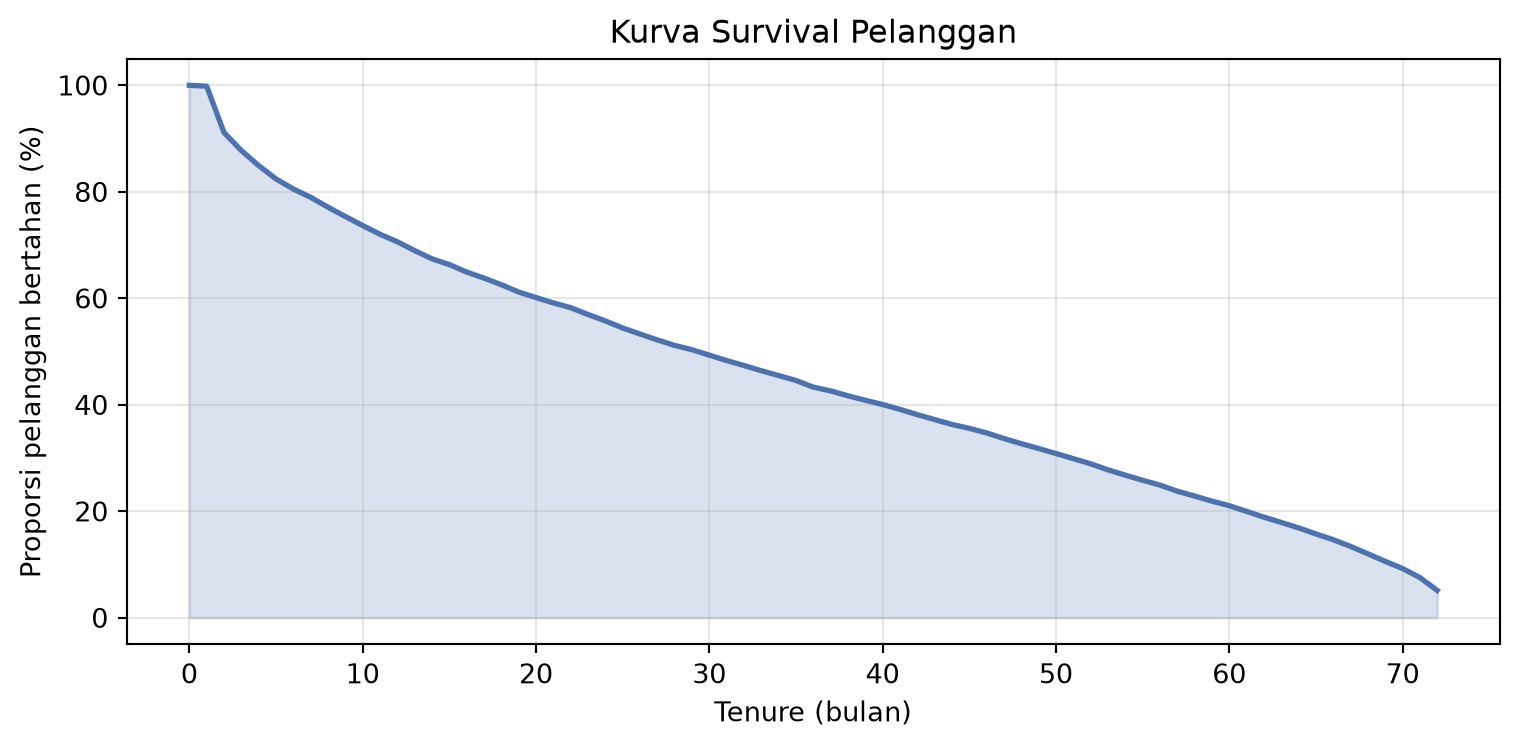
Kita dapat memvisualisasikan ini sebagai **kurva survival**: berapa proporsi pelanggan yang bertahan setelah N bulan?
```{python}
#| label: fig-survival
#| fig-cap: "Kurva survival sederhana: proporsi pelanggan yang bertahan hingga tenure tertentu."
#| fig-width: 8
#| fig-height: 4
# Hitung proporsi pelanggan dengan tenure >= t
tenure_range = np.arange(0, 73, 1)
survival = [(df["tenure"] >= t).mean() * 100 for t in tenure_range]

fig, ax = plt.subplots(figsize=(8, 4))
ax.plot(tenure_range, survival, color="#4C72B0", linewidth=2)
ax.fill_between(tenure_range, survival, alpha=0.2, color="#4C72B0")
ax.set_xlabel("Tenure (bulan)")
ax.set_ylabel("Proporsi pelanggan bertahan (%)")
ax.set_title("Kurva Survival Pelanggan")
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
```
Kurva ini menunjukkan **penurunan tajam** di awal (bulan 0–12) dan **melandai** setelahnya. Ini adalah pola khas **"churn dini"**—sebagian besar pelanggan yang akan churn melakukannya di tahun pertama. Implikasi untuk keputusan: **program retensi harus fokus pada 12 bulan pertama**, bukan tersebar merata sepanjang siklus hidup pelanggan.
::: {.callout-note}
Analisis survival formal—dengan *hazard function* dan model seperti Cox Proportional Hazards—akan dibahas di Bab 10 sebagai jembatan ke time series. Di sini kita hanya menggunakan versi deskriptif sederhana untuk membangun intuisi.
:::
## Root Cause Analysis: Kerangka Sistematis
Stratifikasi dan drill-down adalah **teknik**. Tetapi diagnosis yang baik membutuhkan **kerangka berpikir**. Dua kerangka yang paling banyak digunakan:
### 5 Whys
Teknik sederhana namun kuat: tanyakan **"mengapa"** lima kali berturut-turut, masing-masing jawaban menjadi dasar pertanyaan berikutnya.
**Contoh pada dataset Telco:**
1. **Mengapa churn rate tinggi?**
→ Karena pelanggan kontrak bulanan churn sangat sering.
2. **Mengapa pelanggan kontrak bulanan churn sangat sering?**
→ Karena mereka merasa tidak terikat dan mudah pindah.
3. **Mengapa mereka merasa tidak terikat?**
→ Karena mereka belum menggunakan banyak layanan tambahan (security, backup, tech support).
4. **Mengapa mereka belum menggunakan banyak layanan tambahan?**
→ Karena layanan tambahan ditawarkan sebagai add-on berbayar, dan pelanggan baru enggan menambah biaya.
5. **Mengapa pelanggan baru enggan menambah biaya?**
→ Karena mereka belum merasakan nilai layanan inti—dan belum ada program onboarding yang membangun keterikatan.
**Akar masalah yang ditemukan:** bukan kontrak bulanan itu sendiri, melainkan **kurangnya keterikatan pelanggan baru melalui layanan tambahan**. Ini mengarahkan intervensi ke **program onboarding dan bundling layanan**, bukan sekadar memaksa pelanggan pindah ke kontrak tahunan.
::: {.callout-tip}
**5 Whys bukan alat statistik.** Ia adalah alat **berpikir**. Kekuatannya terletak pada memaksa kita bergerak dari gejala ke akar. Namun ia juga punya kelemahan: ia bisa berhenti di jawaban yang salah jika asumsi kita keliru. Karena itu, **validasi setiap "mengapa" dengan data**—jangan hanya mengandalkan intuisi.
:::
### Diagram Ishikawa (Fishbone)
Kerangka kedua memetakan **penyebab potensial** ke dalam kategori-kategori. Untuk churn, kategori yang masuk akal adalah:
- **Produk**: kualitas layanan, harga, fitur
- **Pelanggan**: demografi, kebutuhan, ekspektasi
- **Proses**: onboarding, dukungan pelanggan, penagihan
- **Lingkungan**: kompetitor, kondisi pasar
Setiap kategori diisi dengan hipotesis yang kemudian **diuji dengan data**. Diagram ini berguna untuk **memastikan kita tidak melewatkan kategori penyebab**—dan untuk berkomunikasi dengan pemangku kepentingan non-teknis.
## Visual Analytics untuk Diagnosis
Diagnosis yang baik membutuhkan visualisasi yang **mengungkap**, bukan sekadar **menampilkan**. Tiga jenis grafik sangat berguna untuk diagnosis:
### 1. Heatmap Stratifikasi
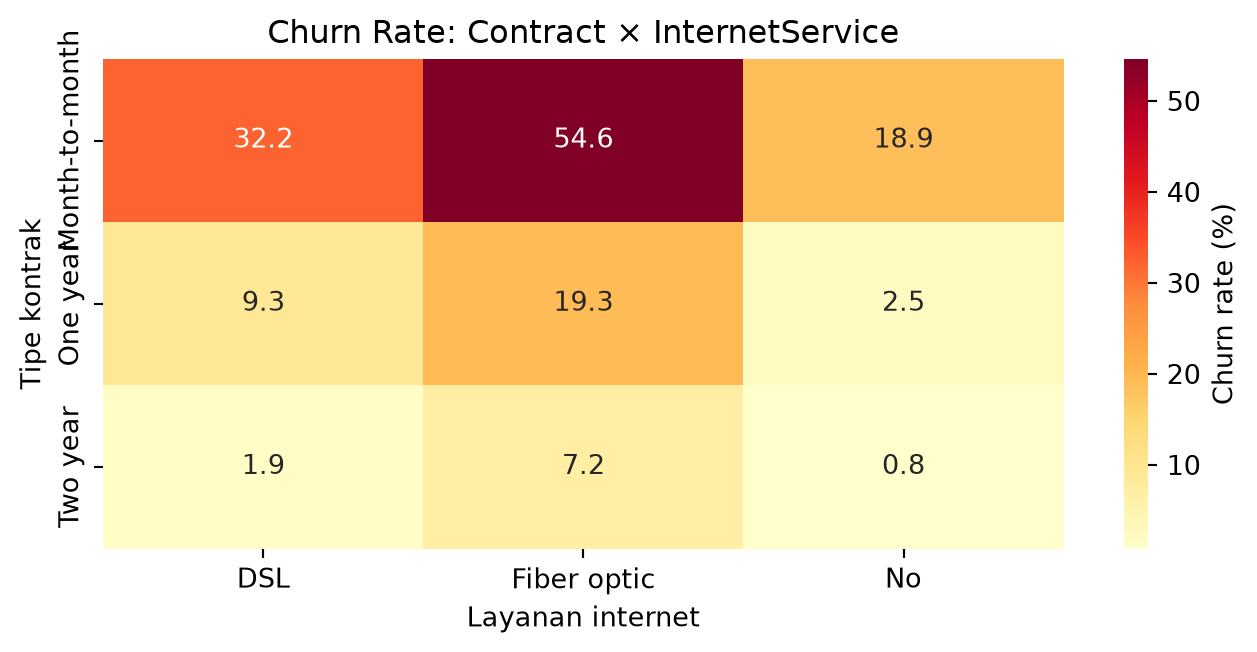
Heatmap memungkinkan kita melihat pola di **banyak subkelompok sekaligus**—jauh lebih efisien daripada tabel.
```{python}
#| label: fig-heatmap-strat
#| fig-cap: "Heatmap churn rate per kombinasi Contract dan InternetService. Warna lebih gelap = churn lebih tinggi."
#| fig-width: 7
#| fig-height: 3.5
heat_data = (df.groupby(["Contract", "InternetService"], observed=True)["Churn"]
               .apply(lambda s: (s == "Yes").mean() * 100)
               .unstack())

fig, ax = plt.subplots(figsize=(7, 3.5))
sns.heatmap(heat_data, annot=True, fmt=".1f", cmap="YlOrRd",
            cbar_kws={"label": "Churn rate (%)"}, ax=ax)
ax.set_title("Churn Rate: Contract × InternetService")
ax.set_xlabel("Layanan internet")
ax.set_ylabel("Tipe kontrak")
plt.tight_layout()
plt.show()
```
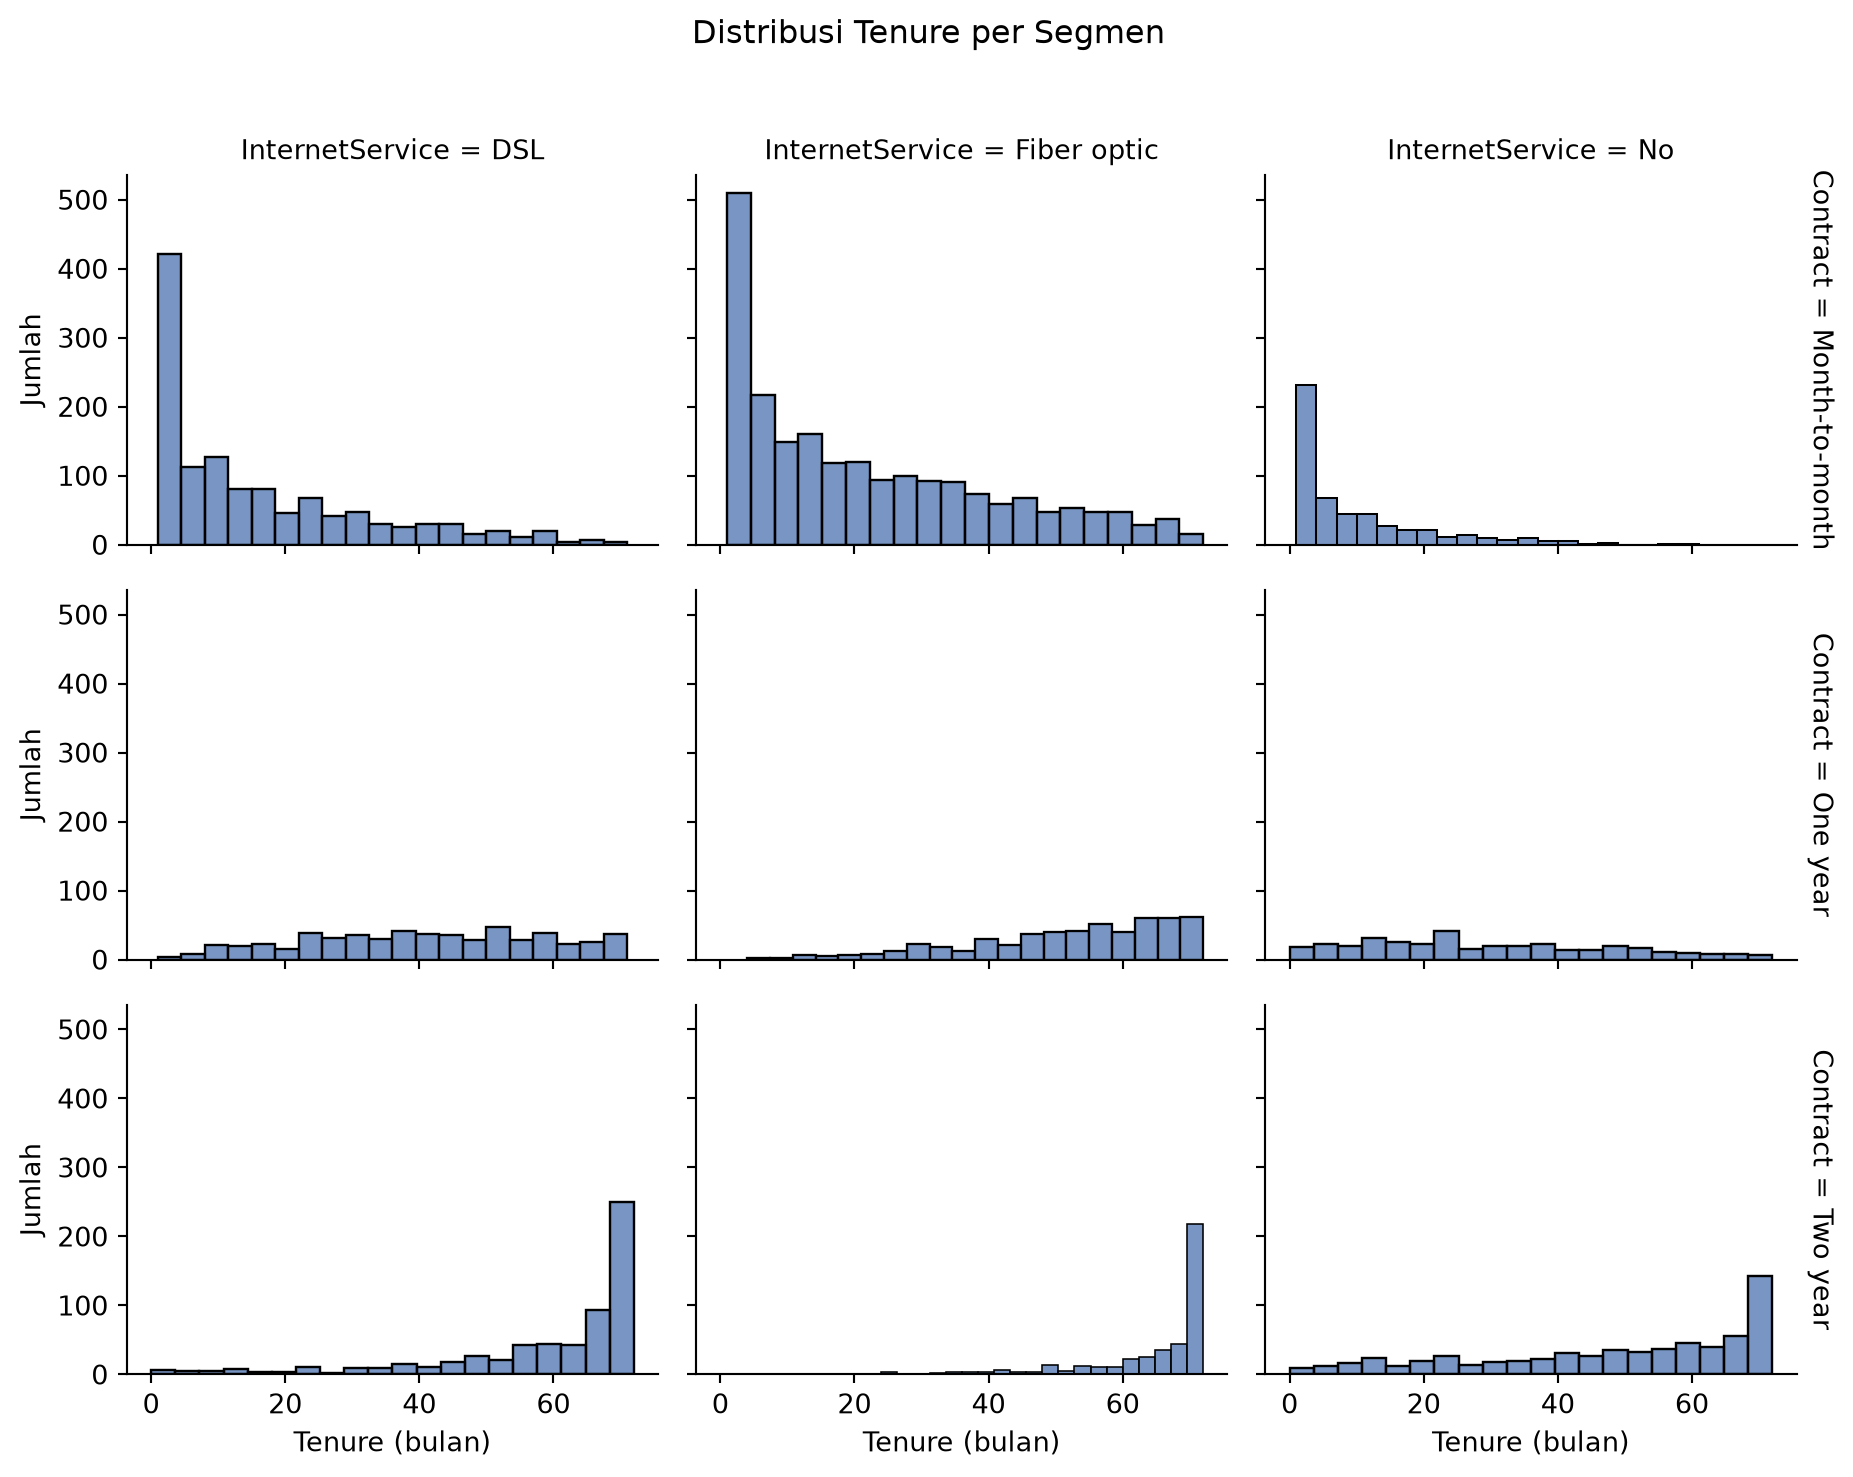
### 2. Small Multiples untuk Perbandingan
Ketika kita ingin membandingkan pola yang sama di banyak segmen, **small multiples** (facet) jauh lebih efektif daripada menumpuk semua garis di satu grafik.
```{python}
#| label: fig-small-multiples-diag
#| fig-cap: "Distribusi tenure per segmen kontrak dan layanan internet."
#| fig-width: 10
#| fig-height: 3.5
g = sns.FacetGrid(df, col="InternetService", row="Contract",
                  height=2.5, aspect=1.3, margin_titles=True)
g.map(sns.histplot, "tenure", bins=20, color="#4C72B0")
g.set_axis_labels("Tenure (bulan)", "Jumlah")
g.figure.suptitle("Distribusi Tenure per Segmen", y=1.02)
plt.tight_layout()
plt.show()
```
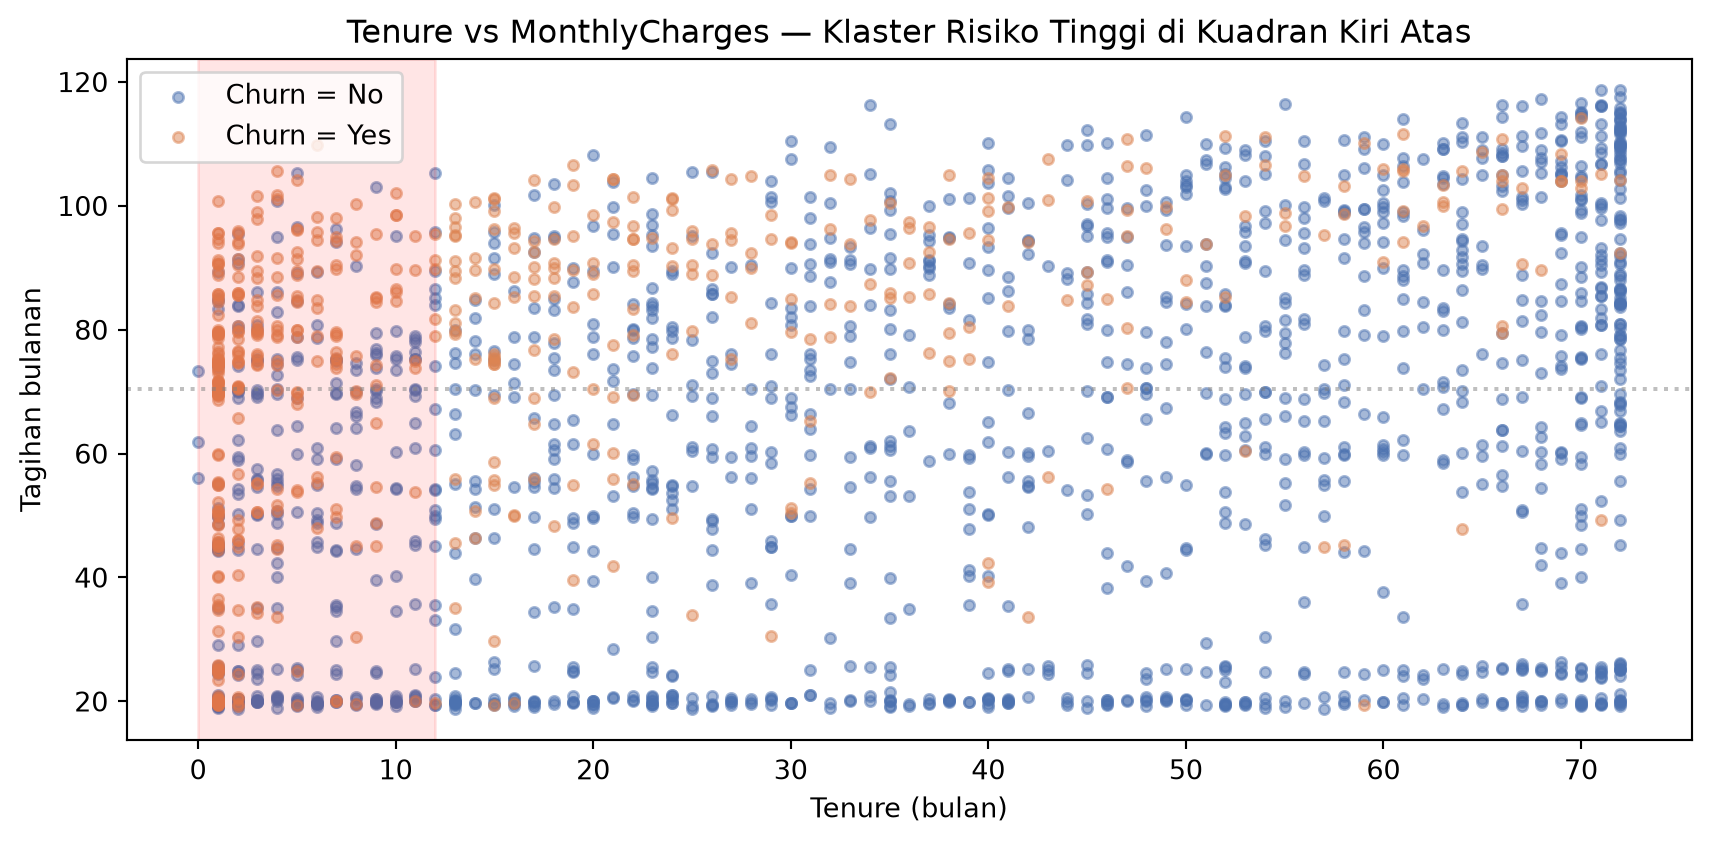
### 3. Scatter dengan Anotasi
Scatter plot dengan anotasi memungkinkan kita **menyoroti** titik-titik tertentu yang penting—misalnya, pelanggan dengan kombinasi fitur yang tidak biasa.
```{python}
#| label: fig-scatter-annotated
#| fig-cap: "Scatter tenure vs MonthlyCharges, diwarnai berdasarkan churn. Perhatikan klaster pelanggan berisiko tinggi."
#| fig-width: 9
#| fig-height: 4.5
sample = df.sample(2000, random_state=42)
fig, ax = plt.subplots(figsize=(9, 4.5))
for status, color in [("No", "#4C72B0"), ("Yes", "#DD8452")]:
    subset = sample[sample["Churn"] == status]
    ax.scatter(subset["tenure"], subset["MonthlyCharges"],
               c=color, label=f"Churn = {status}", alpha=0.5, s=15)

# Sorot area berisiko tinggi: tenure rendah + tagihan tinggi
ax.axvspan(0, 12, alpha=0.1, color="red")
ax.axhline(df["MonthlyCharges"].median(), color="gray", linestyle=":", alpha=0.5)

ax.set_xlabel("Tenure (bulan)")
ax.set_ylabel("Tagihan bulanan")
ax.set_title("Tenure vs MonthlyCharges — Klaster Risiko Tinggi di Kuadran Kiri Atas")
ax.legend()
plt.tight_layout()
plt.show()
```
**Temuan.** Pelanggan dengan **tenure rendah** (0–12 bulan, area merah) dan **tagihan bulanan tinggi** (di atas median) membentuk klaster dengan proporsi churn yang sangat tinggi. Ini adalah segmen dengan **nilai tinggi tetapi risiko tinggi**—pelanggan yang membayar mahal tetapi belum berkomitmen. Keputusan: segmen ini membutuhkan **intervensi retensi prioritas**—mungkin diskon perpanjangan kontrak, atau penawaran layanan tambahan gratis selama 3 bulan pertama.
## Batas Diagnosis: Korelasi vs Kausalitas
Kita telah menemukan banyak pola. Tetapi kita harus **jujur tentang batasnya**: semua teknik di bab ini menemukan **asosiasi**, bukan **kausalitas**.
### Tiga Syarat Kausalitas
Untuk menyimpulkan bahwa X **menyebabkan** Y, kita membutuhkan tiga hal:
1. **Korelasi**: X dan Y bergerak bersama. ✅ (sudah kita punya)
2. **Urutan waktu**: X terjadi sebelum Y. ❓ (kita tidak tahu kapan churn terjadi relatif terhadap perubahan kontrak)
3. **Eliminasi penjelasan alternatif**: tidak ada variabel ketiga yang menjelaskan keduanya. ❌ (kita tidak bisa memastikan ini tanpa eksperimen atau desain kausal)
### Metode Kausal yang Sederhana
Untuk dataset observasional seperti Telco, kita bisa mendekati kausalitas dengan beberapa teknik sederhana—meskipun tidak sekuat eksperimen:
| Teknik | Prinsip | Keterbatasan |
|---|---|---|
| **Stratifikasi** | Bandingkan X→Y dalam subkelompok Z | Hanya mengontrol Z yang teramati |
| **Regresi multivariabel** | Estimasi efek X sambil mengontrol variabel lain | Tetap hanya mengontrol yang teramati; tidak menangani endogenitas |
| **Propensity score matching** | Pasangkan pelanggan dengan karakteristik serupa | Membutuhkan banyak data; tidak menangani confounder tak teramati |
| **A/B test** | Eksperimen acak | Tidak selalu mungkin atau etis |
::: {.callout-important}
**Diagnosis yang baik tahu batasnya.** Kita bisa menyimpulkan bahwa "pelanggan fiber optic dengan kontrak bulanan memiliki churn rate tinggi" dengan yakin—itu fakta deskriptif yang kuat. Tetapi menyimpulkan bahwa "mengubah pelanggan dari fiber optic ke DSL akan mengurangi churn" membutuhkan eksperimen. **Diagnosis mengidentifikasi kandidat penyebab; konfirmasi membutuhkan desain yang lebih kuat.**
:::
## Studi Kasus: Diagnosis Churn Telco
Mari kita gabungkan semua teknik di atas dalam satu studi kasus yang menjawab pertanyaan:
> *"Segmen mana yang paling berisiko churn, dan mengapa?"*
### Langkah 1: Identifikasi Segmen Berisiko Tinggi
```{python}
#| label: case-risk-segments
# Definisikan segmen berisiko tinggi berdasarkan analisis di atas
df["risk_segment"] = np.select(
    [
        (df["Contract"] == "Month-to-month") & (df["tenure"] <= 12) & (df["InternetService"] == "Fiber optic"),
        (df["Contract"] == "Month-to-month") & (df["tenure"] <= 12),
        (df["Contract"] == "Month-to-month"),
    ],
    ["Sangat tinggi", "Tinggi", "Menengah"],
    default="Rendah"
)

segmen_ringkasan = (df.groupby("risk_segment", observed=True)
                      .agg(
                          jumlah=("Churn", "size"),
                          churn_rate=("Churn", lambda s: (s == "Yes").mean() * 100),
                          avg_tenure=("tenure", "mean"),
                          avg_charges=("MonthlyCharges", "mean"),
                      )
                      .round(1)
                      .sort_values("churn_rate", ascending=False))
segmen_ringkasan
```
### Langkah 2: Drill-Down ke Segmen "Sangat Tinggi"
```{python}
#| label: case-drilldown
high_risk = df[df["risk_segment"] == "Sangat tinggi"]

print(f"Pelanggan di segmen 'Sangat tinggi': {len(high_risk):,} "
      f"({len(high_risk)/len(df)*100:.1f}% dari total)")
print(f"Churn rate segmen ini             : {(high_risk['Churn'] == 'Yes').mean()*100:.1f}%")
print(f"\nDistribusi fitur di segmen ini:")
for col in ["PaymentMethod", "Partner", "Dependents", "OnlineSecurity"]:
    vc = high_risk[col].value_counts(normalize=True).mul(100).round(1)
    print(f"\n  {col}:")
    for k, v in vc.items():
        print(f"    {k:20s}: {v:5.1f}%")
```
### Langkah 3: 5 Whys untuk Segmen Ini
**1. Mengapa segmen ini churn?**
→ Karena mereka kontrak bulanan, tenure pendek, dan menggunakan fiber optic.
**2. Mengapa mereka memilih kontrak bulanan?**
→ Karena mereka baru—belum yakin dengan layanan, belum berkomitmen.
**3. Mengapa mereka memilih fiber optic?**
→ Mungkin karena promosi awal atau karena ingin kecepatan tinggi.
**4. Mengapa mereka churn meskipun membayar mahal?**
→ Karena ekspektasi tinggi tidak terpenuhi, atau karena mereka tidak terikat kontrak dan mudah pindah ke kompetitor.
**5. Mengapa mereka tidak terikat?**
→ Karena belum ada program onboarding yang membangun keterikatan—tidak ada diskon perpanjangan, tidak ada layanan tambahan gratis, tidak ada komunikasi proaktif.
**Hipotesis akar masalah:** **Kurangnya strategi onboarding dan retensi dini untuk pelanggan fiber optic baru.**
### Langkah 4: Implikasi untuk Keputusan
Berdasarkan diagnosis ini, tiga intervensi yang masuk akal:
| Intervensi | Target | Dasar diagnosis |
|---|---|---|
| **Diskon perpanjangan kontrak** untuk pelanggan fiber optic baru | Segmen "Sangat tinggi" | Mengurangi insentif churn dengan menciptakan biaya peralihan |
| **Bundling layanan tambahan gratis** 3 bulan pertama | Segmen "Sangat tinggi" | Membangun keterikatan melalui penggunaan fitur |
| **Program onboarding proaktif** (check-in di bulan 1, 3, 6) | Semua pelanggan baru | Mengurangi churn dini yang terlihat di kurva survival |
::: {.callout-note}
**Ini masih hipotesis.** Intervensi di atas masuk akal berdasarkan diagnosis, tetapi **belum terbukti efektif**. Untuk mengujinya, kita perlu **A/B test**—yang akan kita bahas sebagai bagian dari integrasi di Bab 18. Diagnosis yang baik menghasilkan **hipotesis yang dapat diuji**, bukan keputusan final.
:::
## Latihan Terbimbing
**Latihan 5.1 — Stratifikasi.**
Apakah efek `InternetService` terhadap `Churn` bertahan ketika kita stratifikasi berdasarkan `PaymentMethod`? Buat tabel stratifikasi dan jelaskan temuan kita dalam satu paragraf.
**Latihan 5.2 — Simpson's Paradox.**
Cari satu pasangan variabel di dataset Telco yang menunjukkan Simpson's Paradox ketika distratifikasi oleh variabel ketiga. Tunjukkan tabel agregat dan tabel stratifikasinya, dan jelaskan mengapa paradox itu muncul.
**Latihan 5.3 — Analisis kohort.**
Buat kurva survival untuk pelanggan yang dipisah berdasarkan `Contract`. Apakah bentuk kurva berbeda? Apa implikasinya untuk strategi retensi?
**Latihan 5.4 — 5 Whys.**
Lakukan latihan 5 Whys untuk pertanyaan: *"Mengapa pelanggan dengan `PaperlessBilling` (jika ada di dataset kita) memiliki churn rate yang berbeda?"* Tuliskan lima "mengapa" berturut-turut dan akar masalah yang kita temukan. Untuk setiap "mengapa", identifikasi data apa yang akan kita gunakan untuk memvalidasinya.
**Latihan 5.5 — Batas diagnosis.**
Pilih satu temuan dari bab ini dan tuliskan satu paragraf yang menjelaskan mengapa temuan itu **belum** merupakan bukti kausal. Apa eksperimen yang akan kita rancang untuk mengujinya?
::: {.callout-note collapse="true"}
**Petunjuk Latihan 5.2.** Simpson's Paradox paling mungkin muncul ketika variabel stratifikasi berkorelasi **positif** dengan variabel penjelas **dan** berkorelasi **negatif** dengan target (atau sebaliknya). Periksa korelasi antara `InternetService`, `Contract`, dan `Churn`—kemungkinan besar kita akan menemukan kombinasi yang menarik.
:::
## Kotak "Jembatan": Dari Data ke Keputusan
::: {.callout-important}
**Jembatan.** Bab ini mengubah cara kita memandang data secara fundamental:
1. **Dari gejala ke akar masalah.** Di Bab 3 kita tahu *bahwa* kontrak bulanan memiliki churn tinggi. Di Bab 5 kita tahu *mengapa*—dan "mengapa" itu mengarahkan intervensi ke tempat yang berbeda: bukan pada kontrak itu sendiri, tetapi pada **program onboarding dan keterikatan pelanggan baru**.
2. **Dari agregat ke segmen.** Rata-rata churn rate 26,5% menyembunyikan kenyataan bahwa ada segmen dengan churn rate > 50% dan segmen lain dengan churn rate < 5%. Keputusan yang baik **menargetkan segmen**, bukan rata-rata.
3. **Dari korelasi ke hipotesis yang dapat diuji.** Kita belum bisa mengatakan "diskon perpanjangan kontrak akan mengurangi churn." Tetapi kita bisa mengatakan "berdasarkan pola stratifikasi, pelanggan fiber optic baru dengan kontrak bulanan adalah target prioritas untuk intervensi retensi." Ini adalah **hipotesis yang dapat diuji**—dan mengujinya membutuhkan **prediksi** (Bab 9) dan **optimasi** (Bab 14).
4. **Dari diagnosis ke prediksi.** Diagnosis memberi kita **variabel mana yang penting**. Prediksi akan memberi kita **model yang dapat memprediksi churn untuk pelanggan baru**—berdasarkan pola yang sama, tetapi diterapkan secara individual. Inilah jembatan ke Bagian II.
:::
## Rangkuman
Dalam bab ini kita telah:
- **Membedakan pertanyaan deskriptif dari diagnostik**—dan memahami bahwa diagnosis mengejar mekanisme, bukan sekadar pola.
- **Menerapkan stratifikasi** untuk menguji apakah pola bertahan ketika data dipecah berdasarkan variabel ketiga.
- **Mengenali Simpson's Paradox** dan memahami mengapa agregasi bisa menyesatkan—serta bagaimana menghindarinya.
- **Menggunakan drill-down** untuk menelusuri pola ke tingkat yang lebih dalam, dengan kesadaran akan bahaya sampel kecil.
- **Melakukan analisis kohort** untuk memahami bagaimana perilaku berubah sepanjang siklus hidup pelanggan—dan menemukan bahwa churn paling akut di awal.
- **Menerapkan kerangka root cause analysis** (5 Whys, Ishikawa) untuk bergerak dari gejala ke akar masalah.
- **Menggunakan visual analytics**—heatmap stratifikasi, small multiples, scatter beranotasi—untuk mengungkap pola yang tidak terlihat di tabel.
- **Mengakui batas diagnosis**: semua teknik di bab ini menemukan asosiasi, bukan kausalitas, dan konfirmasi membutuhkan desain eksperimen.
## Jembatan ke Bab 6
Kita telah menyelesaikan sebagian besar Bagian I. Kita telah membersihkan data, mengukurnya, memvisualisasikannya, dan mendiagnosisnya. Sekarang saatnya **menuai hasil**—mengubah semua analisis ini menjadi **insight yang dapat dikomunikasikan** kepada pengambil keputusan.
Bab berikutnya—**Studi Kasus & Komunikasi Insight**—akan menjadi **bab penutup Bagian I**. Ia akan:
- Menggabungkan semua teknik dari Bab 1–5 dalam satu **studi kasus end-to-end** pada dataset Telco.
- Memperkenalkan **data storytelling**: bagaimana menyusun narasi dari data ke insight ke rekomendasi.
- Menunjukkan cara membangun **dashboard eksekutif** yang merangkum temuan Bagian I.
- Menjadi **jembatan formal** ke Bagian II—menunjukkan bahwa semua pertanyaan "mengapa" yang kita ajukan di sini membutuhkan model prediktif untuk dijawab secara individual.