---
jupyter: decanal
---
# Regresi: Fondasi Pemodelan Statistik {#sec-regresi}
::: {.callout-note appearance="simple"}
**Tujuan pembelajaran.** Setelah menyelesaikan bab ini, kita akan mampu:
1. Membangun regresi linear untuk target kontinu dan menginterpretasikan koefisiennya secara bisnis.
2. Memeriksa asumsi regresi linear melalui diagnostik residual.
3. Mengenali multikolinearitas dan mengatasinya dengan regularisasi (Ridge, Lasso).
4. Membangun regresi logistik untuk target biner dan menginterpretasikan **odds ratio**.
5. Membedakan interpretasi koefisien linear dari koefisien logistik—dan memahami kapan masing-masing lebih tepat.
6. Menjelaskan mengapa regresi tetap relevan bahkan ketika model canggih tersedia.
:::
## Mengapa Regresi?
Di Bab 7 kita membangun baseline klasifikasi dengan Logistic Regression. Tetapi kita belum membahas **apa yang sedang dilakukan model itu**. Bab ini mengisi kekosongan tersebut.
Regresi adalah **fondasi** yang sering diremehkan. Ada tiga alasan mengapa ia tetap relevan di era gradient boosting dan deep learning:
1. **Interpretabilitas.** Koefisien regresi memiliki makna langsung: "setiap kenaikan 1 bulan tenure menurunkan log-odds churn sebesar 0,05". Model canggih jarang memberikan interpretasi sejelas ini.
2. **Inferensi, bukan hanya prediksi.** Regresi memungkinkan kita menjawab "seberapa yakin kita bahwa hubungan ini nyata?" melalui standard error dan confidence interval—bukan hanya "apa prediksinya".
3. **Fondasi untuk semua model.** Gradient boosting dengan loss function MSE pada dasarnya adalah regresi yang lebih fleksibel. Memahami regresi membantu kita memahami apa yang terjadi di balik layar model yang lebih kompleks.
::: {.callout-tip}
**Dua wajah regresi.** Dalam buku ini, regresi akan muncul dalam **dua peran**:
- **Sebagai model prediktif** (fokus Bagian II): menghasilkan prediksi.
- **Sebagai alat inferensi** (fokus diagnostik): memahami hubungan antar variabel.
Bab ini akan bergantian antara keduanya—kadang kita peduli akurasi prediksi, kadang kita peduli makna koefisien.
:::
## Regresi Linear: Memodelkan Target Kontinu
### Bentuk Umum
Regresi linear mengasumsikan bahwa target $y$ adalah fungsi linear dari fitur $X$:
$$y = \beta_0 + \beta_1 x_1 + \beta_2 x_2 + \dots + \beta_p x_p + \epsilon$$
- $\beta_0$ adalah **intercept** (nilai $y$ ketika semua $x = 0$).
- $\beta_j$ adalah **koefisien** untuk fitur $x_j$ — perubahan $y$ untuk setiap kenaikan satu unit $x_j$, **dengan menganggap fitur lain konstan** (inilah arti "ceteris paribus").
- $\epsilon$ adalah **residual** — bagian dari $y$ yang tidak dijelaskan oleh model.
### Contoh: Memprediksi Tagihan Bulanan
Sebagai latihan, mari kita gunakan regresi linear untuk memprediksi `MonthlyCharges` dari fitur-fitur lain. Ini bukan target yang biasa diprediksi—tetapi ia berguna untuk memperkenalkan konsep tanpa kompleksitas target biner.
```{python}
#| label: setup
import sys
sys.path.insert(0, ".")
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns

from decanal.utils import load_churn_clean
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression, Ridge, Lasso, LogisticRegression
from sklearn.preprocessing import StandardScaler, OneHotEncoder
from sklearn.compose import ColumnTransformer
from sklearn.pipeline import Pipeline
from sklearn.impute import SimpleImputer
from sklearn.metrics import mean_squared_error, r2_score, mean_absolute_error

RANDOM_STATE = 42
df = load_churn_clean()

# Target kontinu
y_cont = df["MonthlyCharges"]
X_cont = df.drop(columns=["MonthlyCharges", "Churn"])
```
```{python}
#| label: split-cont
X_train_c, X_test_c, y_train_c, y_test_c = train_test_split(
    X_cont, y_cont, test_size=0.2, random_state=RANDOM_STATE
)

numeric_features = X_cont.select_dtypes(include=["int64", "float64"]).columns.tolist()
categorical_features = X_cont.select_dtypes(include=["object"]).columns.tolist()

preprocessor_lin = ColumnTransformer([
    ("num", Pipeline([
        ("imputer", SimpleImputer(strategy="median")),
        ("scaler", StandardScaler()),
    ]), numeric_features),
    ("cat", Pipeline([
        ("imputer", SimpleImputer(strategy="most_frequent")),
        ("onehot", OneHotEncoder(drop="first", handle_unknown="ignore")),
    ]), categorical_features),
])
```
### Melatih Model dan Mengukur Performa
```{python}
#| label: fit-linear
lin_pipe = Pipeline([
    ("prep", preprocessor_lin),
    ("reg", LinearRegression()),
])

lin_pipe.fit(X_train_c, y_train_c)
y_pred_train = lin_pipe.predict(X_train_c)
y_pred_test = lin_pipe.predict(X_test_c)

perf = pd.DataFrame({
    "Metrik": ["RMSE", "MAE", "R²"],
    "Train": [
        f"{np.sqrt(mean_squared_error(y_train_c, y_pred_train)):.2f}",
        f"{mean_absolute_error(y_train_c, y_pred_train):.2f}",
        f"{r2_score(y_train_c, y_pred_train):.3f}",
    ],
    "Test": [
        f"{np.sqrt(mean_squared_error(y_test_c, y_pred_test)):.2f}",
        f"{mean_absolute_error(y_test_c, y_pred_test):.2f}",
        f"{r2_score(y_test_c, y_pred_test):.3f}",
    ],
})
perf
```
**Cara membaca metrik:**
- **RMSE** (Root Mean Squared Error): rata-rata kesalahan prediksi dalam satuan target. RMSE = 5,0 berarti model salah sekitar Rp 5.000 per prediksi.
- **MAE** (Mean Absolute Error): rata-rata kesalahan absolut. Lebih tahan outlier dari RMSE.
- **R²**: proporsi varians target yang dijelaskan model. R² = 0,85 berarti 85% variasi `MonthlyCharges` dapat dijelaskan oleh fitur.
::: {.callout-note}
**R² tidak sama dengan "akurasi".** Nilai R² bisa negatif (model lebih buruk dari prediksi rata-rata). R² = 0,9 tidak berarti "90% benar"—ia berarti "model menjelaskan 90% varians". Pada dataset dengan noise tinggi, R² = 0,3 bisa sangat baik.
:::
## Interpretasi Koefisien: Membaca Model
Kekuatan regresi linear adalah **interpretabilitas**. Mari kita lihat koefisien untuk beberapa fitur:
```{python}
#| label: coef-linear
# Ambil nama fitur setelah one-hot encoding
feature_names = lin_pipe.named_steps["prep"].get_feature_names_out()
coefs = lin_pipe.named_steps["reg"].coef_

coef_df = pd.DataFrame({
    "fitur": feature_names,
    "koefisien": coefs,
}).sort_values("koefisien", key=abs, ascending=False)

coef_df.head(10).round(2)
```
**Cara membaca koefisien:**
- Nilai positif berarti: fitur ini **menaikkan** `MonthlyCharges`.
- Nilai negatif berarti: fitur ini **menurunkan** `MonthlyCharges`.
- Besar koefisien **dalam satuan target** (karena kita menstandarisasi fitur, koefisien mewakili perubahan tagihan untuk setiap **standar deviasi** kenaikan fitur).
Contoh interpretasi: Jika koefisien untuk `num__tenure` adalah 3,5, itu berarti: *setiap kenaikan 1 standar deviasi tenure (sekitar 20 bulan) meningkatkan `MonthlyCharges` sebesar Rp 3.500, dengan menganggap fitur lain konstan.*
::: {.callout-warning}
**Hati-hati dengan standardisasi.** Kita menstandardisasi fitur numerik di pipeline. Ini membuat koefisien **dapat dibandingkan antar fitur** tetapi **tidak langsung dalam satuan asli**. Jika kita ingin interpretasi "per 1 bulan tenure", hilangkan `StandardScaler` untuk fitur tersebut, atau kalikan koefisien dengan standar deviasi fitur.
:::
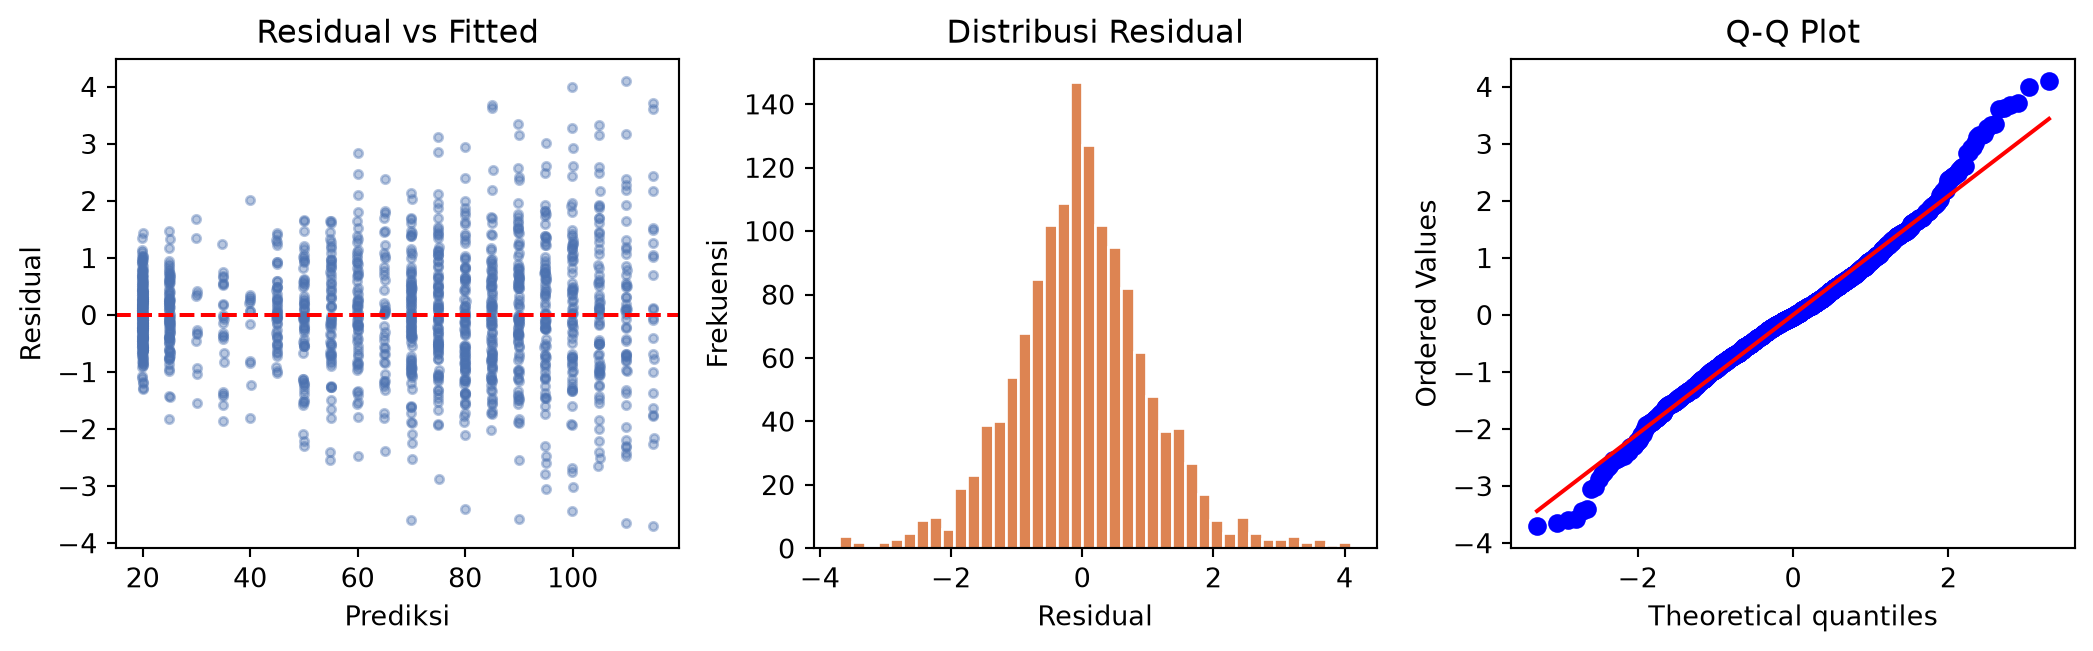
## Diagnostik Residual: Memeriksa Asumsi
Regresi linear memiliki **empat asumsi** yang perlu diperiksa:
| Asumsi | Arti | Cara memeriksa |
|---|---|---|
| **Linearitas** | Hubungan X–y adalah linear | Plot residual vs fitted |
| **Independensi** | Residual tidak saling bergantung | Durbin-Watson (untuk data waktu); desain sampel |
| **Homoskedastisitas** | Varians residual konstan | Plot residual vs fitted |
| **Normalitas residual** | Residual berdistribusi normal | Q-Q plot, histogram residual |
Jika asumsi ini dilanggar, **koefisien dan standard error** mungkin tidak dapat dipercaya—meskipun **prediksi** mungkin masih berguna.
### Plot Residual vs Fitted
```{python}
#| label: fig-residual
#| fig-cap: "Diagnostik residual. Idealnya titik-titik tersebar acak di sekitar garis nol, tanpa pola."
#| fig-width: 10
#| fig-height: 3.5
residuals = y_test_c - y_pred_test

fig, axes = plt.subplots(1, 3, figsize=(11, 3.5))

# Plot 1: Residual vs fitted
axes[0].scatter(y_pred_test, residuals, alpha=0.4, color="#4C72B0", s=10)
axes[0].axhline(0, color="red", linestyle="--")
axes[0].set_xlabel("Prediksi")
axes[0].set_ylabel("Residual")
axes[0].set_title("Residual vs Fitted")

# Plot 2: Histogram residual
axes[1].hist(residuals, bins=40, color="#DD8452", edgecolor="white")
axes[1].set_xlabel("Residual")
axes[1].set_ylabel("Frekuensi")
axes[1].set_title("Distribusi Residual")

# Plot 3: Q-Q plot
from scipy import stats
stats.probplot(residuals, dist="norm", plot=axes[2])
axes[2].set_title("Q-Q Plot")

plt.tight_layout()
plt.show()
```
**Cara membaca:**
- **Residual vs Fitted**: Jika ada pola (kurva, corong), asumsi linearitas atau homoskedastisitas dilanggar. Di sini titik-titik tersebar cukup acak—asumsi terpenuhi dengan baik.
- **Histogram residual**: Jika bentuknya sangat miring atau multimodal, normalitas dilanggar.
- **Q-Q plot**: Jika titik-titik mengikuti garis diagonal, residual mendekati normal. Penyimpangan di ekor menunjukkan ekor yang lebih berat/ringan dari normal.
::: {.callout-tip}
**Plot residual lebih informatif daripada uji formal.** Uji normalitas (Shapiro, Kolmogorov-Smirnov) hampir selalu menolak H₀ pada dataset besar—bahkan untuk penyimpangan kecil. **Plot residual** memberi kita gambaran visual tentang **jenis** pelanggaran (miring, ekor berat, kurva), yang lebih berguna untuk memutuskan tindakan.
:::
## Multikolinearitas: Ketika Fitur Saling Berkorelasi
Di Bab 3 kita menemukan korelasi tinggi antara `tenure` dan `TotalCharges`. **Multikolinearitas** adalah kondisi ketika dua atau lebih fitur sangat berkorelasi—yang membuat koefisien regresi **tidak stabil** dan **sulit diinterpretasikan**.
### Mendeteksi dengan VIF
**Variance Inflation Factor (VIF)** mengukur seberapa besar varians koefisien meningkat akibat multikolinearitas:
```{python}
#| label: vif
from statsmodels.stats.outliers_influence import variance_inflation_factor

# Ambil fitur numerik saja, tanpa one-hot (untuk kesederhanaan)
num_only = X_train_c[numeric_features].dropna()
vif_data = pd.DataFrame({
    "fitur": numeric_features,
    "VIF": [variance_inflation_factor(num_only.values, i)
            for i in range(num_only.shape[1])],
}).sort_values("VIF", ascending=False)

vif_data
```
**Interpretasi VIF:**
- **VIF < 5**: multikolinearitas rendah—aman.
- **VIF 5–10**: multikolinearitas sedang—waspada.
- **VIF > 10**: multikolinearitas tinggi—koefisien tidak stabil.
Jika `TotalCharges` memiliki VIF > 10, ini mengonfirmasi apa yang kita duga: ia sangat bergantung pada `tenure` dan `MonthlyCharges`. Ini bukan masalah untuk **prediksi** (model masih bisa prediksi), tetapi menjadi masalah untuk **interpretasi** (koefisien `tenure` vs `TotalCharges` tidak dapat dipisahkan dengan andal).
### Solusi: Regularisasi
**Regularisasi** menambahkan penalti pada besar koefisien, memaksa model untuk **memilih** fitur penting dan **mengecilkan** koefisien yang tidak perlu. Ini sangat berguna untuk multikolinearitas.
| Metode | Penalti | Efek |
|---|---|---|
| **Ridge** (L2) | $\lambda \sum \beta_j^2$ | Mengecilkan koefisien menuju nol, tetapi tidak pernah tepat nol |
| **Lasso** (L1) | $\lambda \sum \|\beta_j\|$ | Mengecilkan koefisien **dan** memilih fitur (menjadi nol) |
| **Elastic Net** | Kombinasi L1 + L2 | Kompromi antara keduanya |
```{python}
#| label: regularization
from sklearn.linear_model import RidgeCV, LassoCV

# Ridge dengan cross-validation otomatis
ridge_pipe = Pipeline([
    ("prep", preprocessor_lin),
    ("reg", RidgeCV(alphas=np.logspace(-3, 3, 50), cv=5)),
])
ridge_pipe.fit(X_train_c, y_train_c)
ridge_pred = ridge_pipe.predict(X_test_c)

# Lasso
lasso_pipe = Pipeline([
    ("prep", preprocessor_lin),
    ("reg", LassoCV(alphas=np.logspace(-3, 3, 50), cv=5, max_iter=5000)),
])
lasso_pipe.fit(X_train_c, y_train_c)
lasso_pred = lasso_pipe.predict(X_test_c)

# Bandingkan
pd.DataFrame({
    "Model": ["Linear (OLS)", "Ridge", "Lasso"],
    "Test RMSE": [
        f"{np.sqrt(mean_squared_error(y_test_c, y_pred_test)):.2f}",
        f"{np.sqrt(mean_squared_error(y_test_c, ridge_pred)):.2f}",
        f"{np.sqrt(mean_squared_error(y_test_c, lasso_pred)):.2f}",
    ],
    "Test R²": [
        f"{r2_score(y_test_c, y_pred_test):.3f}",
        f"{r2_score(y_test_c, ridge_pred):.3f}",
        f"{r2_score(y_test_c, lasso_pred):.3f}",
    ],
})
```
**Perhatikan**: Ridge dan Lasso memilih **alpha optimal** melalui cross-validation. Dalam banyak kasus, performanya mirip dengan OLS, tetapi **koefisiennya lebih stabil** dan **lebih mudah diinterpretasikan** ketika ada multikolinearitas.
Lasso juga **memilih fitur**: koefisien yang menjadi nol berarti fitur tersebut tidak dipakai oleh model. Ini sangat berguna untuk dataset dengan banyak fitur:
```{python}
#| label: lasso-selection
lasso_coefs = lasso_pipe.named_steps["reg"].coef_
n_zero = (np.abs(lasso_coefs) < 1e-6).sum()
n_total = len(lasso_coefs)
print(f"Lasso menihilkan {n_zero} dari {n_total} koefisien ({n_zero/n_total:.1%})")
```
::: {.callout-important}
**Regularisasi adalah trade-off.** Ia **mengorbankan** sedikit akurasi pada data latih untuk **mendapatkan** stabilitas dan generalisasi. Jika dataset kita bersih dan bebas multikolinearitas, regularisasi mungkin tidak banyak membantu. Jika dataset kita "kotor" dengan fitur berkorelasi, regularisasi bisa menyelamatkan model.
:::
## Regresi Logistik: Memodelkan Target Biner
Sekarang kita kembali ke inti Bagian II: **memprediksi churn**. Regresi logistik adalah jawaban klasik untuk target biner, dan masih menjadi baseline yang kuat sampai hari ini.
### Bentuk Umum
Regresi logistik memodelkan **log-odds** (logit) dari probabilitas kelas positif:
$$\log\left(\frac{p}{1-p}\right) = \beta_0 + \beta_1 x_1 + \dots + \beta_p x_p$$
Probabilitas $p$ kemudian diperoleh melalui fungsi sigmoid:
$$p = \frac{1}{1 + e^{-(\beta_0 + \beta_1 x_1 + \dots)}}$$
Ini berarti:
- Regresi linear memodelkan **nilai target** secara langsung.
- Regresi logistik memodelkan **log-odds** dari target biner.
- Koefisien $\beta_j$ menunjukkan perubahan **log-odds** untuk setiap kenaikan 1 unit $x_j$.
### Melatih Model pada Data Churn
```{python}
#| label: logreg-fit
# Konvensi: konversi target ke biner 0/1 sekali di sini
y_bin = (df["Churn"] == "Yes").astype(int)
X_churn = df.drop(columns=["Churn"])

X_tr, X_te, y_tr, y_te = train_test_split(
    X_churn, y_bin, test_size=0.2, random_state=RANDOM_STATE, stratify=y_bin
)

logreg_pipe = Pipeline([
    ("prep", preprocessor_lin),
    ("clf", LogisticRegression(max_iter=1000, random_state=RANDOM_STATE)),
])
logreg_pipe.fit(X_tr, y_tr)

from sklearn.metrics import roc_auc_score, accuracy_score, classification_report
y_prob = logreg_pipe.predict_proba(X_te)[:, 1]
y_pred = logreg_pipe.predict(X_te)

print(f"Test AUC     : {roc_auc_score(y_te, y_prob):.3f}")
print(f"Test accuracy: {accuracy_score(y_te, y_pred):.3f}")
print()
print(classification_report(y_te, y_pred, target_names=["No churn", "Churn"]))
```
### Interpretasi Koefisien sebagai Odds Ratio
Kekuatan regresi logistik adalah interpretabilitasnya. Jika kita eksponensialkan koefisien, kita mendapatkan **odds ratio** (OR):
```{python}
#| label: odds-ratio
feature_names = logreg_pipe.named_steps["prep"].get_feature_names_out()
coefs = logreg_pipe.named_steps["clf"].coef_[0]
odds_ratios = np.exp(coefs)

or_df = pd.DataFrame({
    "fitur": feature_names,
    "koefisien": coefs,
    "odds_ratio": odds_ratios,
}).sort_values("odds_ratio", ascending=False)

# Tampilkan 10 OR tertinggi dan 5 terendah
top = pd.concat([or_df.head(10), or_df.tail(5)])
top.round(3)
```
**Cara membaca odds ratio:**
- **OR > 1**: fitur **meningkatkan** odds churn. OR = 1,5 berarti: setiap kenaikan 1 unit fitur (atau perpindahan dari baseline untuk fitur kategorikal) meningkatkan odds churn sebesar 50%.
- **OR = 1**: fitur tidak berpengaruh.
- **OR < 1**: fitur **menurunkan** odds churn. OR = 0,5 berarti: odds churn turun 50%.
::: {.callout-warning}
**Odds ratio ≠ probabilitas.** Ini adalah kesalahpahaman paling umum. OR = 2 berarti **odds** berlipat dua—bukan probabilitas. Jika probabilitas awal 20% (odds = 0,25), maka OR = 2 menghasilkan odds 0,5, yang setara dengan probabilitas 33%. Perubahan probabilitas **bergantung pada baseline**—tidak linier.
:::
### Perhatikan Tanda Koefisien
```{python}
#| label: interpret-directions
# Contoh interpretasi untuk fitur kunci
key_features = [f for f in feature_names if any(k in f for k in ["Contract", "tenure", "InternetService_Fiber"])]

pd.DataFrame({
    "fitur": key_features,
    "odds_ratio": [np.exp(coefs[list(feature_names).index(f)]) for f in key_features],
}).round(3)
```
Cari fitur seperti:
- `cat__Contract_One year` → OR < 1 (kontrak tahunan **mengurangi** odds churn)
- `cat__Contract_Two year` → OR << 1 (kontrak dua tahun **sangat mengurangi** odds churn)
- `num__tenure` → OR < 1 (semakin lama berlangganan, semakin rendah odds churn)
- `cat__InternetService_Fiber optic` → OR > 1 (fiber optic **meningkatkan** odds churn)
Ini konsisten dengan diagnosis kita di Bagian I—dan sekarang kita memilikinya dalam bentuk **kuantitatif** yang dapat dipakai untuk simulasi dan keputusan.
::: {.callout-important}
**Perhatikan arah, bukan hanya besaran.** OR = 0,4 dan OR = 2,5 sama-sama "efek kuat"—satu menurunkan, satu meningkatkan. Dalam presentasi ke pemangku kepentingan, arah sering lebih penting daripada besaran: *"Kontrak dua tahun mengurangi odds churn sekitar 80%"* lebih mudah dicerna daripada *"koefisien -1,6"*.
:::
## Regresi Linear vs Logistik: Kapan Memakai Apa
| Aspek | Regresi Linear | Regresi Logistik |
|---|---|---|
| **Target** | Kontinu | Biner |
| **Fungsi** | $y = X\beta + \epsilon$ | $p = \sigma(X\beta)$ |
| **Koefisien** | Perubahan nilai target | Perubahan log-odds |
| **Interpretasi** | "1 unit X → β unit Y" | "1 unit X → e^β kali odds" |
| **Metrik evaluasi** | RMSE, MAE, R² | AUC, precision, recall, F1 |
| **Diagnostik** | Plot residual, VIF | Kurva ROC, kalibrasi |
| **Asumsi** | Linearitas, homoskedastisitas, normalitas | Tidak ada asumsi distribusi ketat |
**Aturan praktis:**
- Jika target kita adalah **jumlah, harga, waktu** → gunakan regresi linear.
- Jika target kita adalah **ya/tidak, sukses/gagal** → gunakan regresi logistik.
- Jika target kita adalah **hitungan** (0, 1, 2, ...) → gunakan regresi Poisson.
- Jika target kita adalah **waktu sampai kejadian** → gunakan survival analysis (Bab 10).
## Menghubungkan Kembali ke Keputusan
Model yang baru kita latih menjawab pertanyaan yang berbeda dari baseline di Bab 7. Ia memberi kita **odds ratio yang dapat diinterpretasikan**:
```{python}
#| label: bridge-decision
# Contoh: seberapa besar penurunan odds churn jika pelanggan pindah dari bulanan ke tahunan?
coef_monthly = coefs[list(feature_names).index("cat__Contract_One year")]
or_annual = np.exp(-coef_monthly)  # karena baseline adalah Month-to-month

print(f"Pindah dari bulanan ke kontrak tahunan:")
print(f"  → Odds churn berubah dengan faktor {np.exp(coef_monthly):.3f}")
print(f"  → Atau setara dengan pengurangan odds sebesar {(1 - np.exp(coef_monthly))*100:.0f}%")
```
Jika hasilnya OR = 0,4, itu berarti: *"Pindah dari bulanan ke tahunan mengurangi odds churn sebesar 60%"*. Ini adalah **argumen bisnis** yang langsung dapat digunakan dalam rapat—dan akan menjadi input untuk model optimasi di Bagian III.
::: {.callout-tip}
**Bridge ke Bagian III.** Odds ratio ini bukan hanya insight—ia adalah **parameter** yang dapat dipakai dalam model optimasi. Jika kita tahu bahwa perpindahan ke kontrak tahunan mengurangi odds churn 60%, kita dapat menghitung **ekspektasi pengurangan revenue loss** dari program konversi kontrak, dan mengoptimalkan alokasi anggaran terhadap intervensi yang berbeda. Kita akan melakukan ini di Bab 14–15.
:::
## Latihan Terbimbing
**Latihan 8.1 — Interpretasi koefisien.**
Buka tabel `coef_df` dari model regresi linear. Pilih tiga fitur dengan koefisien absolut terbesar. Untuk masing-masing, tuliskan interpretasi dalam bahasa non-teknis (satu kalimat per fitur) yang dapat dipahami oleh manajer produk.
**Latihan 8.2 — Diagnostik residual.**
Buat plot residual untuk model regresi linear kita. Apakah ada pola yang mencurigakan? Jika ya, fitur mana yang mungkin menyebabkan pola tersebut? (Petunjuk: coba plot residual vs `tenure` atau vs `TotalCharges` secara terpisah.)
**Latihan 8.3 — Multikolinearitas.**
Identifikasi fitur dengan VIF > 10 di dataset. Jika ada, coba hapus salah satu fitur yang berkorelasi tinggi, latih ulang model, dan bandingkan R² dan RMSE. Apakah ada penurunan performa? Berapa besar?
**Latihan 8.4 — Lasso untuk feature selection.**
Jalankan Lasso dengan alpha yang lebih besar (misalnya 10× alpha optimal). Berapa banyak koefisien yang menjadi nol? Bandingkan AUC/R² dengan alpha optimal. Kapan kita memilih alpha besar (lebih banyak fitur dinihilkan) vs alpha optimal?
**Latihan 8.5 — Odds ratio interpretation.**
Ambil tiga fitur dari model regresi logistik dengan OR > 1 dan tiga dengan OR < 1. Untuk setiap fitur, tuliskan interpretasi odds ratio dalam bahasa bisnis. Mana yang lebih besar dampaknya terhadap keputusan retensi: fitur dengan OR = 0,3 atau OR = 3? Mengapa?
**Latihan 8.6 — Kalibrasi model.**
Regresi logistik menghasilkan probabilitas. Tetapi apakah probabilitas ini **terkalibrasi**? Artinya: dari semua pelanggan yang model prediksi memiliki probabilitas 0,7, apakah ~70% di antaranya benar-benar churn? Gunakan `sklearn.calibration.calibration_curve` untuk memeriksa. Jika tidak terkalibrasi, apa implikasinya untuk keputusan retensi?
::: {.callout-note collapse="true"}
**Petunjuk Latihan 8.6.** Kalibrasi penting karena kita akan menggunakan **probabilitas** untuk keputusan (mis. "hubungi pelanggan dengan probabilitas > 0,5"). Jika model tidak terkalibrasi, threshold 0,5 mungkin tidak berarti apa-apa—bisa jadi kita menghubungi terlalu banyak atau terlalu sedikit pelanggan. Ini akan dibahas lebih dalam di Bab 9 (Klasifikasi).
:::
## Kotak "Jembatan": Dari Model ke Keputusan
::: {.callout-important}
**Jembatan.** Bab ini memberi kita **dua model** yang menjawab dua pertanyaan berbeda:
1. **Regresi linear** (target kontinu): *"Jika pelanggan X memiliki tenure 24 bulan dan membayar Rp 80.000/bulan, berapa `MonthlyCharges` yang wajar untuknya?"* — Ini berguna untuk deteksi anomali (tagihan terlalu tinggi/rendah) dan untuk memahami **struktur** penetapan harga.
2. **Regresi logistik** (target biner): *"Jika pelanggan X memiliki tenure 24 bulan dan kontrak bulanan, berapa probabilitas ia akan churn?"* — Ini berguna untuk **prioritisasi retensi** dan akan menjadi input langsung untuk model optimasi di Bagian III.
Tetapi ada satu hal yang **belum** kita lakukan: membandingkan regresi logistik dengan model yang lebih canggih—random forest, gradient boosting, XGBoost. Apakah model yang lebih kompleks benar-benar lebih baik untuk dataset ini? Bab 9 akan menjawabnya secara empiris.
:::
## Rangkuman
Dalam bab ini kita telah:
- **Membedakan regresi linear (target kontinu) dari regresi logistik (target biner)**, dan memahami kapan masing-masing tepat digunakan.
- **Membangun regresi linear** untuk memprediksi `MonthlyCharges` dan menginterpretasikan koefisien dalam satuan target.
- **Memeriksa asumsi regresi** melalui plot residual, histogram residual, dan Q-Q plot.
- **Mendeteksi multikolinearitas** dengan VIF dan mengatasinya dengan **regularisasi** (Ridge, Lasso).
- **Memahami Lasso sebagai feature selection**—koefisien yang menjadi nol berarti fitur tidak dipakai model.
- **Membangun regresi logistik** untuk memprediksi churn dan menginterpretasikan koefisien sebagai **odds ratio**.
- **Membedakan odds ratio dari probabilitas**, dan memahami implikasinya untuk interpretasi.
- **Menghubungkan odds ratio ke keputusan bisnis**: "pindah ke kontrak tahunan mengurangi odds churn 60%" adalah argumen yang dapat digunakan langsung dalam rapat.
## Jembatan ke Bab 9
Regresi logistik adalah **model klasifikasi klasik**. Ia sederhana, interpretabel, dan cepat. Tetapi apakah ia model **terbaik** untuk churn prediction?
Bab 9—**Klasifikasi**—akan membandingkan regresi logistik dengan model yang lebih canggih:
- **K-Nearest Neighbors** (KNN): klasifikasi berdasarkan kemiripan.
- **Naive Bayes**: klasifikasi probabilistik dengan asumsi independensi.
- **Decision Tree**: klasifikasi berbasis aturan yang mudah dijelaskan.
- **Random Forest** dan **Gradient Boosting**: ensemble yang menggabungkan banyak pohon untuk performa yang lebih tinggi.
Kita akan membandingkan **AUC, precision, recall, dan F1**—dan menyadari bahwa "model terbaik" bergantung pada **metrik yang kita pedulikan**, yang pada gilirannya bergantung pada **konsekuensi bisnis dari kesalahan**. Ini adalah bab yang paling praktis di Bagian II.