Code
# Jika belum ada, unduh dari Kaggle:
# https://www.kaggle.com/datasets/anirudhchauhan/retail-store-inventory-forecasting-datasetTujuan pembelajaran. Setelah menyelesaikan bab ini, kita akan mampu: 1. Membedakan data cross-sectional dari data time series, dan memahami mengapa keduanya membutuhkan pendekatan berbeda. 2. Mendekomposisi time series menjadi tren, musiman, dan residual. 3. Menerapkan metode forecasting klasik—exponential smoothing dan ARIMA—pada data nyata. 4. Memvalidasi model time series dengan rolling-origin cross-validation, bukan random split. 5. Mengevaluasi forecast dengan metrik yang tepat (MAE, RMSE, MAPE). 6. Menerapkan analisis survival untuk menjawab “kapan” pelanggan churn, bukan hanya “apakah”. 7. Memahami mengapa forecasting adalah fondasi untuk simulasi keputusan di Bagian III.
Sampai Bab 9, semua analisis kita menggunakan Telco Customer Churn—dataset cross-sectional dengan satu baris per pelanggan dan tanpa dimensi waktu eksplisit. Dataset ini sangat cocok untuk klasifikasi: kita memprediksi apakah seorang pelanggan akan churn berdasarkan profilnya saat ini.
Tetapi tidak semua pertanyaan analytics dapat dijawab dengan struktur data seperti itu. Pertanyaan-pertanyaan berikut membutuhkan dimensi waktu:
Untuk menjawabnya, kita membutuhkan data time series: urutan observasi yang diambil pada interval waktu teratur.
Dataset pendamping lapis kedua. Di awal buku, kita menyepakati strategi dua lapis data: - Lapis 1 — Telco Churn: dataset utama untuk Bab 1–9, 11, 13–15, 18. - Lapis 2 — Retail Store Inventory Forecasting: dataset pendamping untuk modul yang membutuhkan struktur waktu dan aliran—yaitu Bab 10, 12, 16, 17.
Bab ini adalah perkenalan pertama dengan dataset retail. Kita akan kembali ke Telco di akhir bab untuk analisis survival, tetapi fokus utama bab ini adalah retail.
Dataset Retail Store Inventory Forecasting berisi data harian penjualan dan inventori dari 5 toko dan 20 produk selama dua tahun (1 Januari 2022 – 1 Januari 2024). Total sekitar 73.100 baris.
Jika belum diunduh, ikuti instruksi di README.md atau unduh dari Kaggle:
# Jika belum ada, unduh dari Kaggle:
# https://www.kaggle.com/datasets/anirudhchauhan/retail-store-inventory-forecasting-datasetimport sys
sys.path.insert(0, ".")
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
import warnings
warnings.filterwarnings("ignore")
from decanal.utils import load_retail
df_retail = load_retail()
print(f"Bentuk: {df_retail.shape[0]:,} baris × {df_retail.shape[1]} kolom")
print(f"\nKolom: {df_retail.columns.tolist()}")
print(f"\nRentang tanggal: {df_retail['Date'].min()} → {df_retail['Date'].max()}")
print(f"Jumlah toko : {df_retail['Store ID'].nunique()}")
print(f"Jumlah produk : {df_retail['Product ID'].nunique()}")Bentuk: 73,100 baris × 15 kolom
Kolom: ['Date', 'Store ID', 'Product ID', 'Category', 'Region', 'Inventory Level', 'Units Sold', 'Units Ordered', 'Demand Forecast', 'Price', 'Discount', 'Weather Condition', 'Holiday/Promotion', 'Competitor Pricing', 'Seasonality']
Rentang tanggal: 2022-01-01 → 2024-01-01
Jumlah toko : 5
Jumlah produk : 20df_retail["Date"] = pd.to_datetime(df_retail["Date"])
# Beberapa baris pertama
df_retail[["Date", "Store ID", "Product ID", "Category", "Region",
"Inventory Level", "Units Sold", "Units Ordered",
"Price", "Discount", "Weather Condition", "Holiday/Promotion"]].head()| Date | Store ID | Product ID | Category | Region | Inventory Level | Units Sold | Units Ordered | Price | Discount | Weather Condition | Holiday/Promotion | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 2022-01-01 | S001 | P0001 | Groceries | North | 231 | 127 | 55 | 33.50 | 20 | Rainy | 0 |
| 1 | 2022-01-01 | S001 | P0002 | Toys | South | 204 | 150 | 66 | 63.01 | 20 | Sunny | 0 |
| 2 | 2022-01-01 | S001 | P0003 | Toys | West | 102 | 65 | 51 | 27.99 | 10 | Sunny | 1 |
| 3 | 2022-01-01 | S001 | P0004 | Toys | North | 469 | 61 | 164 | 32.72 | 10 | Cloudy | 1 |
| 4 | 2022-01-01 | S001 | P0005 | Electronics | East | 166 | 14 | 135 | 73.64 | 0 | Sunny | 0 |
# Ringkasan numerik
df_retail[["Inventory Level", "Units Sold", "Units Ordered",
"Price", "Discount", "Competitor Pricing"]].describe().round(2)| Inventory Level | Units Sold | Units Ordered | Price | Discount | Competitor Pricing | |
|---|---|---|---|---|---|---|
| count | 73100.00 | 73100.00 | 73100.00 | 73100.00 | 73100.00 | 73100.00 |
| mean | 274.47 | 136.46 | 110.00 | 55.14 | 10.01 | 55.15 |
| std | 129.95 | 108.92 | 52.28 | 26.02 | 7.08 | 26.19 |
| min | 50.00 | 0.00 | 20.00 | 10.00 | 0.00 | 5.03 |
| 25% | 162.00 | 49.00 | 65.00 | 32.65 | 5.00 | 32.68 |
| 50% | 273.00 | 107.00 | 110.00 | 55.05 | 10.00 | 55.01 |
| 75% | 387.00 | 203.00 | 155.00 | 77.86 | 15.00 | 77.82 |
| max | 500.00 | 499.00 | 200.00 | 100.00 | 20.00 | 104.94 |
Perhatikan struktur data. Berbeda dari Telco: - Satu baris = kombinasi (tanggal, toko, produk), bukan satu pelanggan. - Target potensial = Units Sold (kontinu), bukan churn (biner). - Dimensi waktu = Date—inilah yang memungkinkan analisis time series.
Dengan struktur ini, kita bisa menjawab pertanyaan seperti: “Berapa unit produk X yang akan terjual di toko Y bulan depan?”
Sebelum masuk ke teknik, penting memahami mengapa time series memerlukan pendekatan berbeda.
| Aspek | Cross-sectional (Telco) | Time series (Retail) |
|---|---|---|
| Unit observasi | Pelanggan (independen) | Titik waktu (berurutan) |
| Asumsi independensi | Observasi saling independen | Observasi saling bergantung (autokorelasi) |
| Split data | Random train/test split | Chronological split (train = masa lalu, test = masa depan) |
| Validasi | Cross-validation biasa | Rolling-origin cross-validation |
| Metrik | AUC, precision, recall | MAE, RMSE, MAPE |
| Pertanyaan | “Apakah pelanggan ini akan churn?” | “Berapa permintaan minggu depan?” |
Kesalahan paling umum di time series. Menggunakan train_test_split acak untuk data time series. Ini data leakage—kita melatih model pada data dari masa depan untuk memprediksi masa lalu. Model akan tampak sangat baik selama pengujian, tetapi gagal total di dunia nyata karena di produksi kita hanya punya data masa lalu.
Aturan emas: selalu split berdasarkan waktu. Train = periode lebih awal, test = periode lebih akhir.
Dataset retail berisi data granular per (tanggal, toko, produk). Untuk forecasting permintaan total, kita perlu mengagregasi ke level yang tepat. Mari kita lihat total unit terjual per hari di semua toko:
daily = (df_retail
         .groupby("Date", as_index=False)
         .agg(total_sold=("Units Sold", "sum"),
              total_ordered=("Units Ordered", "sum"),
              n_transactions=("Units Sold", "size")))

print(f"Jumlah hari: {len(daily)}")
print(f"Rentang    : {daily['Date'].min().date()} → {daily['Date'].max().date()}")
daily.head()
Jumlah hari: 731
Rentang : 2022-01-01 → 2024-01-01| Date | total_sold | total_ordered | n_transactions | |
|---|---|---|---|---|
| 0 | 2022-01-01 | 14484 | 10921 | 100 |
| 1 | 2022-01-02 | 13415 | 10770 | 100 |
| 2 | 2022-01-03 | 13681 | 11096 | 100 |
| 3 | 2022-01-04 | 14084 | 11572 | 100 |
| 4 | 2022-01-05 | 12572 | 10919 | 100 |
fig, ax = plt.subplots(figsize=(11, 4))
ax.plot(daily["Date"], daily["total_sold"], color="#4C72B0", linewidth=1, alpha=0.7)
ax.set_xlabel("Tanggal")
ax.set_ylabel("Total unit terjual")
ax.set_title("Penjualan Harian — Semua Toko (2022–2024)")
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()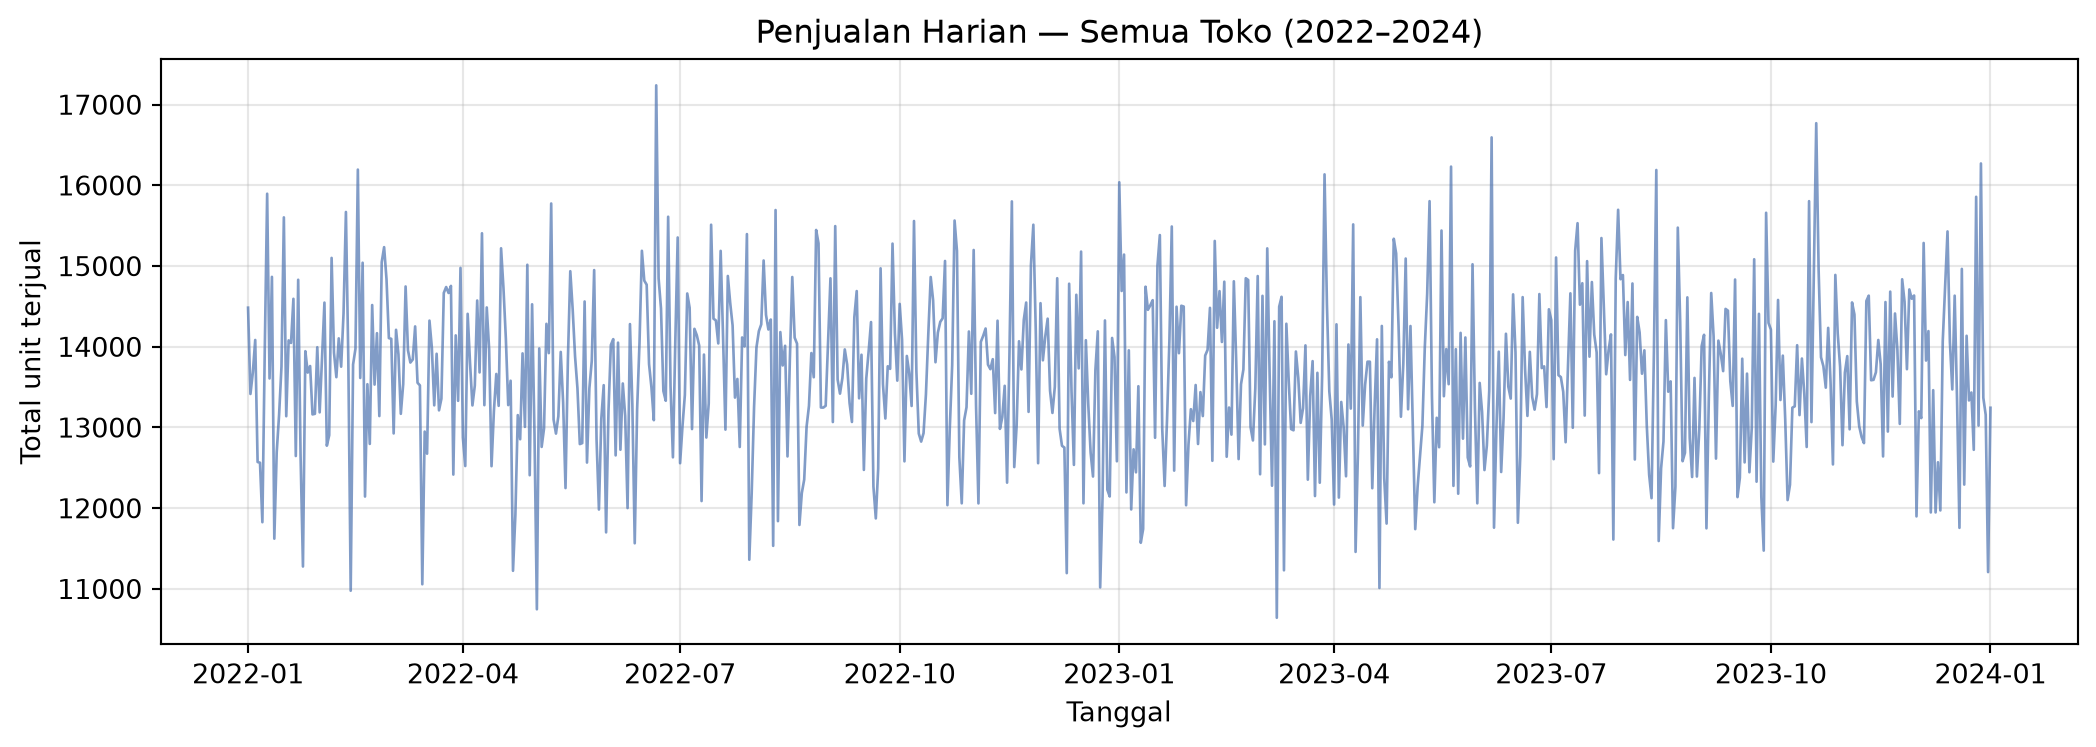
Amati grafik ini. Tiga pola yang perlu kita kenali:
Dekomposisi adalah proses memisahkan time series menjadi tiga komponen:
\[y_t = T_t + S_t + R_t \quad \text{(aditif)}\] \[y_t = T_t \times S_t \times R_t \quad \text{(multiplikatif)}\]
| Model | Kapan dipakai |
|---|---|
| Aditif | Amplitudo musiman konstan sepanjang waktu |
| Multiplikatif | Amplitudo musiman proporsional terhadap level tren |
Untuk data penjualan yang tumbuh, model multiplikatif sering lebih tepat karena fluktuasi musiman juga membesar seiring pertumbuhan.
from statsmodels.tsa.seasonal import seasonal_decompose

# Set index ke Date untuk time series analysis
ts = daily.set_index("Date")["total_sold"].asfreq("D")

# Dekomposisi aditif dengan periode 7 (mingguan)
decomp_add = seasonal_decompose(ts, model="additive", period=7)
decomp_mult = seasonal_decompose(ts, model="multiplicative", period=7)fig, axes = plt.subplots(4, 1, figsize=(10, 8), sharex=True)
decomp_add.observed.plot(ax=axes[0], color="#4C72B0")
axes[0].set_ylabel("Observasi")
axes[0].set_title("Dekomposisi Aditif — Penjualan Harian")
decomp_add.trend.plot(ax=axes[1], color="#DD8452")
axes[1].set_ylabel("Tren")
decomp_add.seasonal.plot(ax=axes[2], color="#55A868")
axes[2].set_ylabel("Musiman")
decomp_add.resid.plot(ax=axes[3], color="#8172B3")
axes[3].set_ylabel("Residual")
axes[3].set_xlabel("Tanggal")
plt.tight_layout()
plt.show()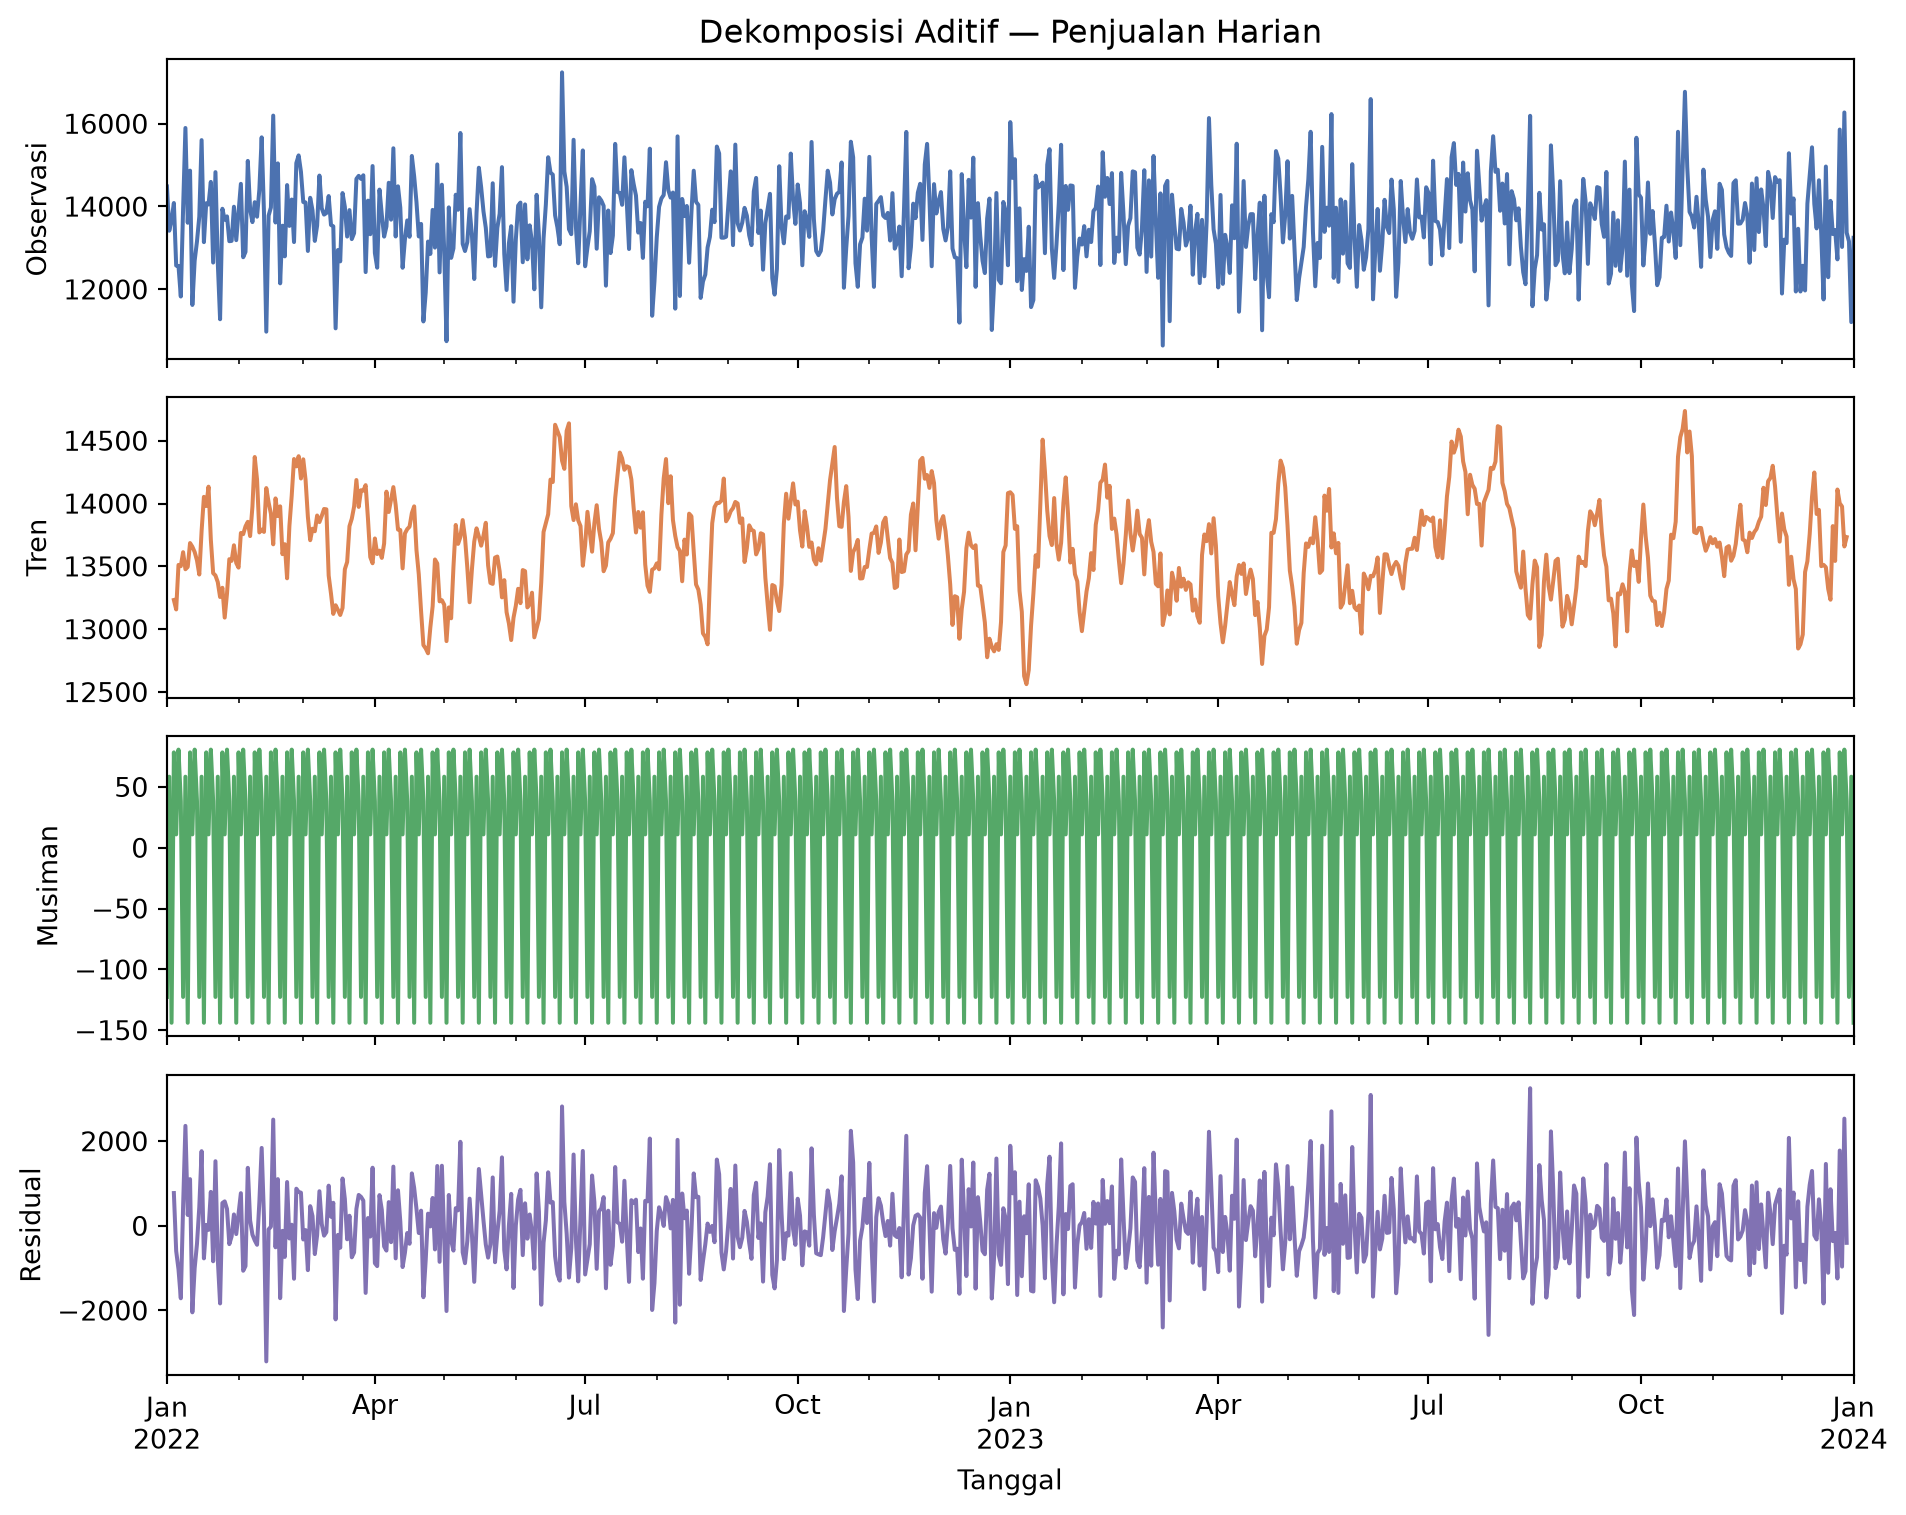
Cara membaca dekomposisi:
Mengapa dekomposisi berguna? Ia memisahkan sinyal dari noise. Tren memberi tahu kita arah bisnis; musiman memberi tahu kita pola operasional; residual memberi tahu kita seberapa banyak variasi yang tidak dapat dijelaskan model. Ketiga komponen ini akan menjadi input untuk forecasting dan—lebih penting—untuk simulasi ketidakpastian di Bab 12.
Sebelum menerapkan model seperti ARIMA, kita perlu memeriksa apakah time series stasioner—artinya, properti statistiknya (mean, variance) tidak berubah sepanjang waktu. Banyak model time series klasik mengasumsikan stasioneritas.
Augmented Dickey-Fuller (ADF) test adalah uji yang paling umum:
from statsmodels.tsa.stattools import adfuller

result = adfuller(ts.dropna(), autolag="AIC")
print(f"ADF Statistic : {result[0]:.4f}")
print(f"p-value       : {result[1]:.4f}")
print(f"Kesimpulan    : ", end="")
if result[1] < 0.05:
    print("Tolak H₀ — series STASIONER")
else:
    print("Gagal tolak H₀ — series TIDAK STASIONER (perlu differencing)")
ADF Statistic : -26.3795
p-value : 0.0000
Kesimpulan : Tolak H₀ — series STASIONERJika series tidak stasioner, kita bisa melakukan differencing—menghitung selisih antar observasi berturut-turut:
ts_diff = ts.diff().dropna()

result_diff = adfuller(ts_diff, autolag="AIC")
print(f"Setelah differencing:")
print(f"ADF Statistic : {result_diff[0]:.4f}")
print(f"p-value       : {result_diff[1]:.4f}")
Setelah differencing:
ADF Statistic : -10.7756
p-value : 0.0000fig, axes = plt.subplots(2, 1, figsize=(10, 5), sharex=True)
axes[0].plot(ts.index, ts.values, color="#4C72B0")
axes[0].set_ylabel("Total terjual")
axes[0].set_title("Series Asli")
axes[1].plot(ts_diff.index, ts_diff.values, color="#DD8452")
axes[1].set_ylabel("Δ Total terjual")
axes[1].set_title("Setelah Differencing (order 1)")
axes[1].set_xlabel("Tanggal")
plt.tight_layout()
plt.show()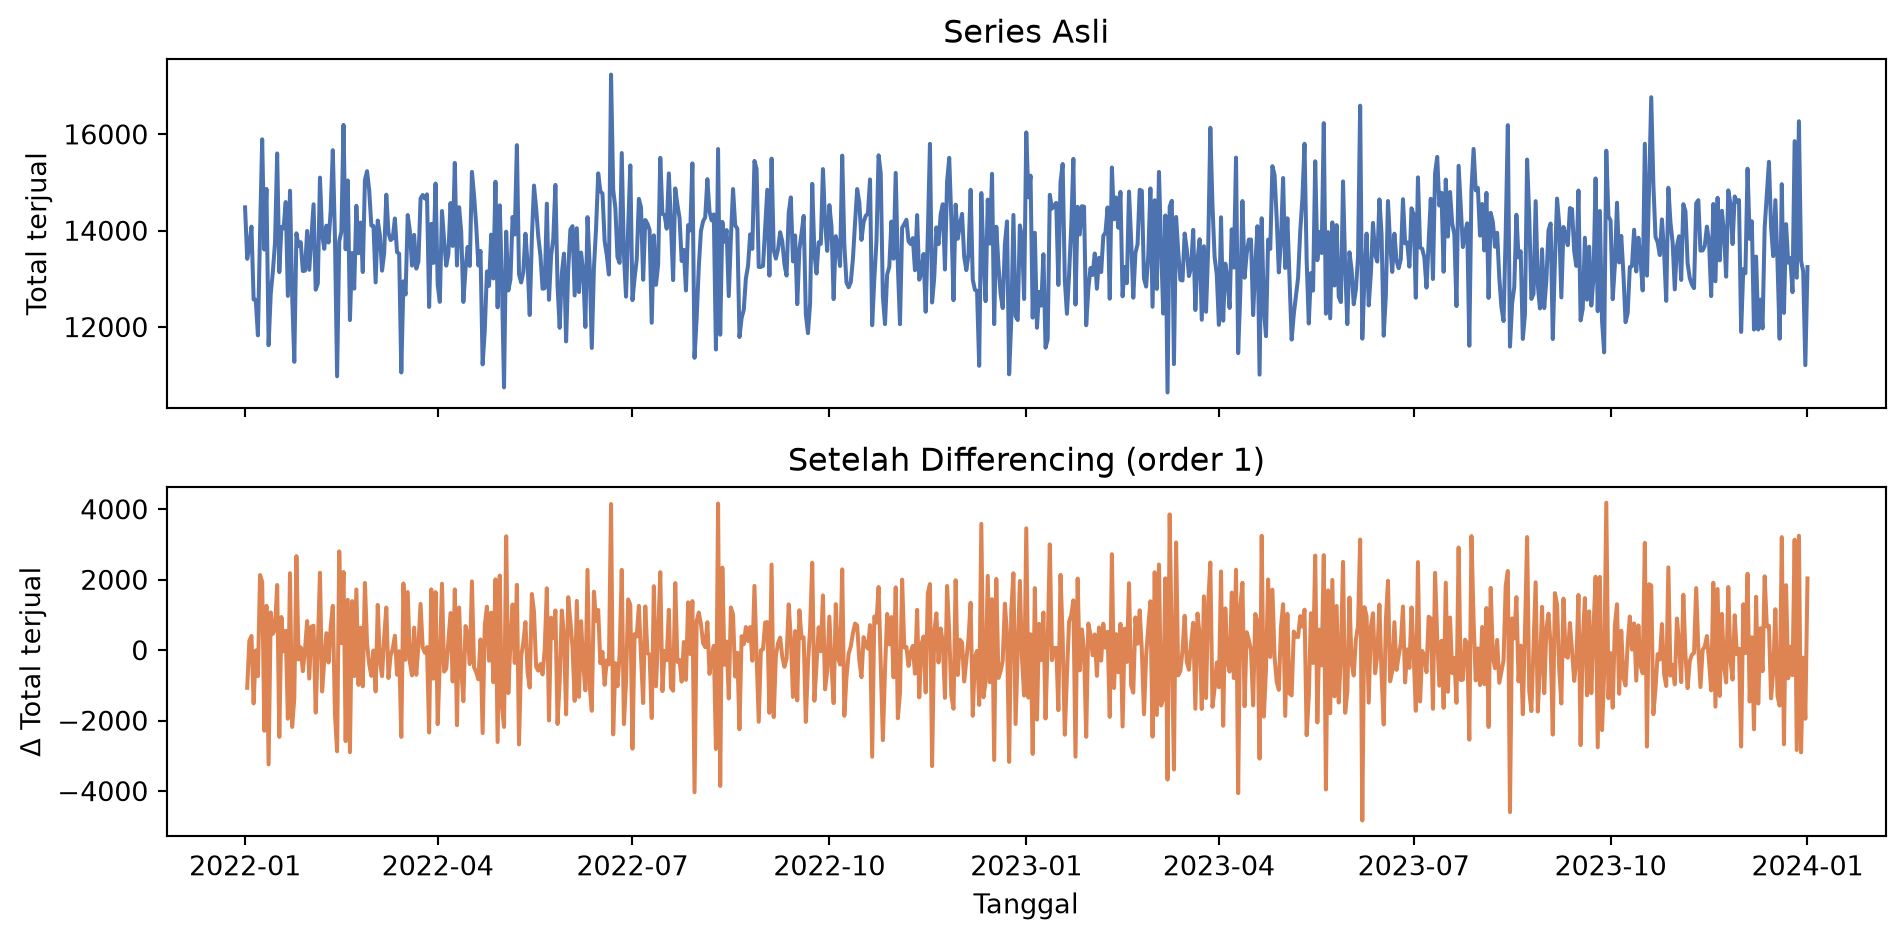
Sekarang kita masuk ke inti bab: forecasting. Kita akan membandingkan tiga metode dengan kompleksitas yang berbeda.
Naive forecast memprediksi nilai besok = nilai hari ini. Sederhana, tetapi sering menjadi baseline yang sulit dikalahkan.
# Split berdasarkan waktu: 80% train, 20% test
n = len(ts)
split_idx = int(n * 0.8)
train, test = ts.iloc[:split_idx], ts.iloc[split_idx:]

print(f"Train: {train.index.min().date()} → {train.index.max().date()} ({len(train)} hari)")
print(f"Test : {test.index.min().date()} → {test.index.max().date()} ({len(test)} hari)")

# Naive: prediksi = nilai terakhir train, konstan sepanjang horizon test
naive_pred = pd.Series([train.iloc[-1]] * len(test), index=test.index)
Train: 2022-01-01 → 2023-08-07 (584 hari)
Test : 2023-08-08 → 2024-01-01 (147 hari)Holt-Winters memperluas exponential smoothing dengan komponen tren dan musiman. Ia cocok untuk data dengan pola musiman berulang.
from statsmodels.tsa.holtwinters import ExponentialSmoothing

hw_model = ExponentialSmoothing(
    train,
    trend="add",
    seasonal="add",
    seasonal_periods=7,  # mingguan
).fit()

hw_pred = hw_model.forecast(len(test))ARIMA (AutoRegressive Integrated Moving Average) adalah model klasik yang menggabungkan: - AR (AutoRegressive): regresi terhadap nilai masa lalu. - I (Integrated): differencing untuk stasioneritas. - MA (Moving Average): regresi terhadap error masa lalu.
from statsmodels.tsa.arima.model import ARIMA

arima_model = ARIMA(train, order=(1, 1, 1)).fit()
arima_pred = arima_model.forecast(len(test))fig, ax = plt.subplots(figsize=(11, 5))
ax.plot(train.index[-60:], train.values[-60:], color="#4C72B0", label="Train (60 hari terakhir)", linewidth=1.5)
ax.plot(test.index, test.values, color="black", label="Aktual (test)", linewidth=1.5)
ax.plot(test.index, naive_pred, color="#C44E52", linestyle="--", label="Naive", linewidth=1.5)
ax.plot(test.index, hw_pred, color="#DD8452", label="Holt-Winters", linewidth=2)
ax.plot(test.index, arima_pred, color="#55A868", linestyle=":", label="ARIMA(1,1,1)", linewidth=2)
ax.set_xlabel("Tanggal")
ax.set_ylabel("Total unit terjual")
ax.set_title("Perbandingan Metode Forecasting")
ax.legend(loc="upper left")
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()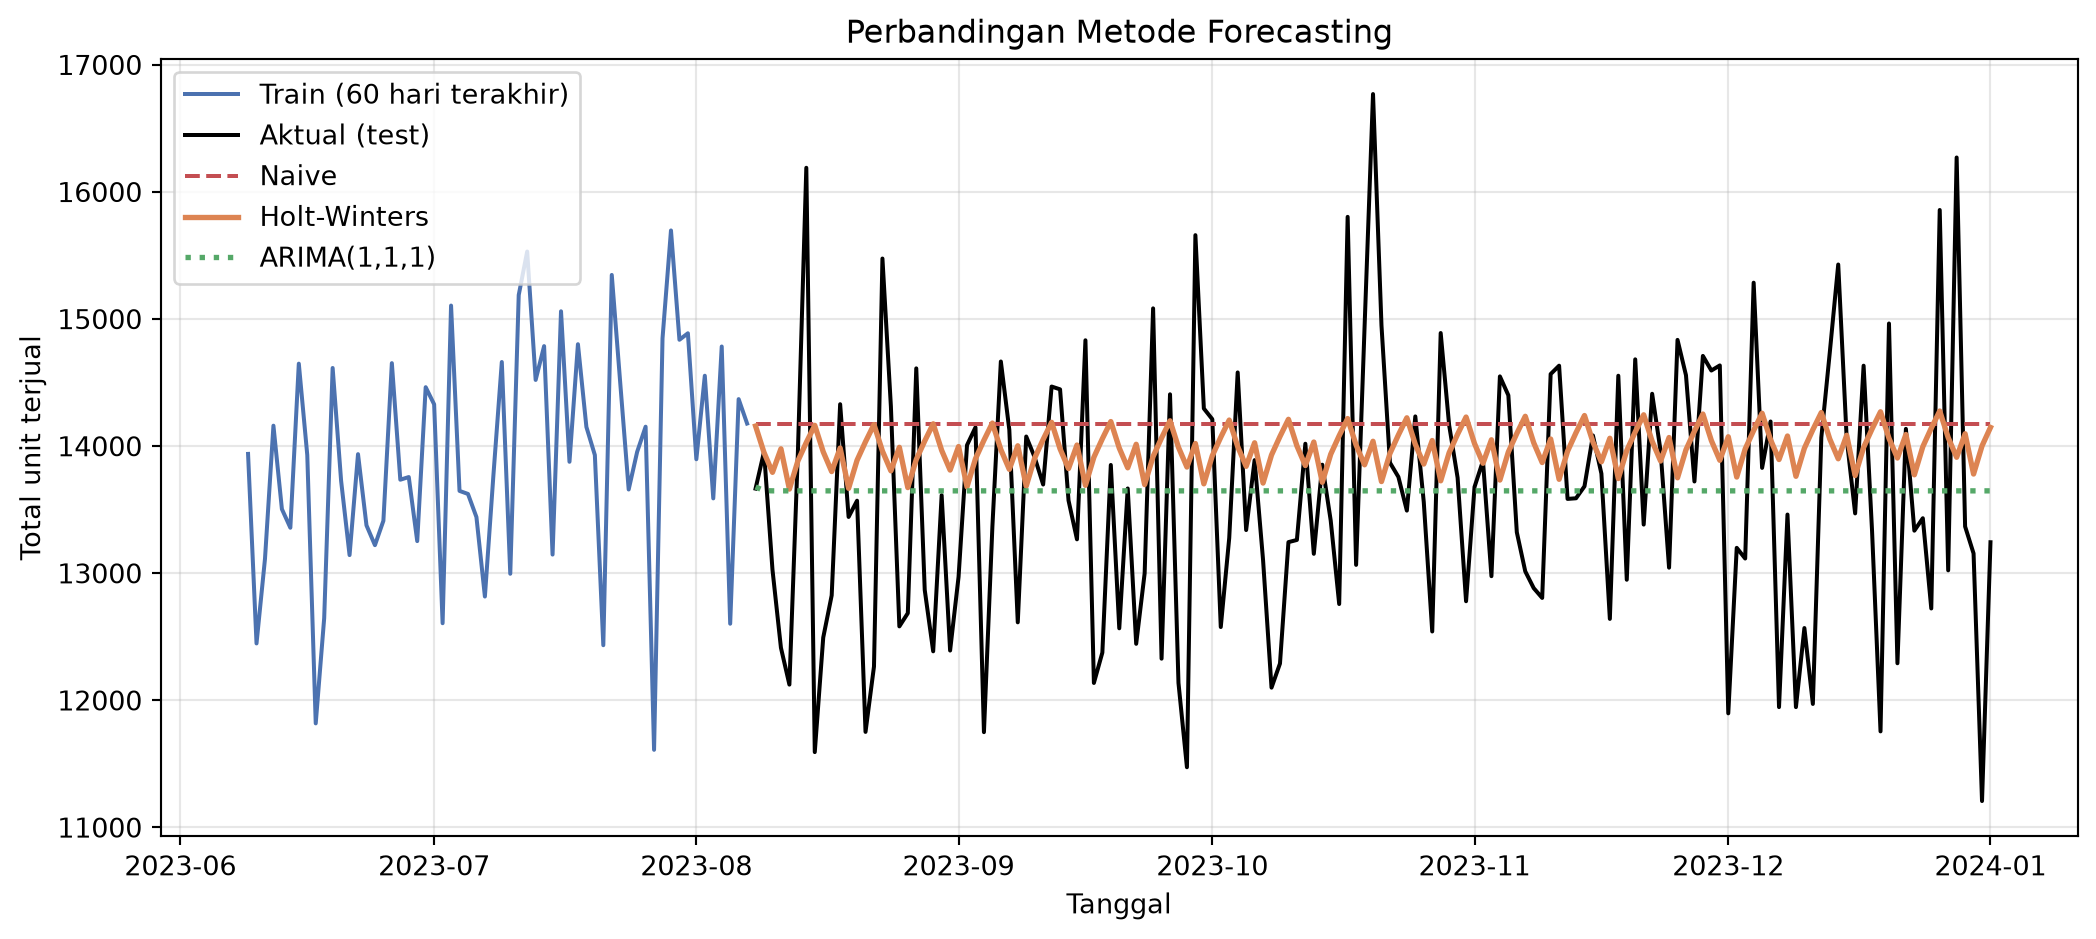
Tiga metrik paling umum untuk time series:
| Metrik | Formula | Interpretasi | Kapan dipakai |
|---|---|---|---|
| MAE | \(\frac{1}{n}\sum \|y - \hat{y}\|\) | Rata-rata kesalahan absolut (satuan target) | Ketika outlier tidak terlalu penting |
| RMSE | \(\sqrt{\frac{1}{n}\sum (y - \hat{y})^2}\) | Akar rata-rata kuadrat kesalahan | Ketika kesalahan besar sangat mahal |
| MAPE | \(\frac{1}{n}\sum \left\|\frac{y - \hat{y}}{y}\right\| \times 100\) | Rata-rata persentase kesalahan | Ketika skala target bervariasi |
from sklearn.metrics import mean_absolute_error, mean_squared_error

def mape(y_true, y_pred):
    return np.mean(np.abs((y_true - y_pred) / y_true)) * 100

metrics = pd.DataFrame({
    "Metode": ["Naive", "Holt-Winters", "ARIMA(1,1,1)"],
    "MAE": [
        mean_absolute_error(test, naive_pred),
        mean_absolute_error(test, hw_pred),
        mean_absolute_error(test, arima_pred),
    ],
    "RMSE": [
        np.sqrt(mean_squared_error(test, naive_pred)),
        np.sqrt(mean_squared_error(test, hw_pred)),
        np.sqrt(mean_squared_error(test, arima_pred)),
    ],
    "MAPE (%)": [
        mape(test.values, naive_pred.values),
        mape(test.values, hw_pred.values),
        mape(test.values, arima_pred.values),
    ],
}).round(2)

metrics.set_index("Metode")| MAE | RMSE | MAPE (%) | |
|---|---|---|---|
| Metode | |||
| Naive | 974.97 | 1202.78 | 7.47 |
| Holt-Winters | 926.15 | 1138.11 | 7.03 |
| ARIMA(1,1,1) | 842.13 | 1050.34 | 6.26 |
Cara membaca:
MAPE bukan selalu tepat. Jika data kita memiliki nilai nol atau sangat kecil, MAPE bisa meledak menjadi tak hingga. Untuk data penjualan dengan hari-hari sepi (nilai mendekati 0), MAE atau RMSE lebih aman. Gunakan MAPE hanya jika semua nilai target jauh dari nol.
Pembagian train/test tunggal bisa menyesatkan—terutama jika test set jatuh pada periode yang tidak biasa (mis. libur panjang). Rolling-origin cross-validation mengatasi ini dengan menggeser jendela pelatihan dan pengujian ke depan secara berurutan.
fig, ax = plt.subplots(figsize=(9, 3.5))

n_windows = 4
window_size = 10
horizon = 3

for i in range(n_windows):
    start = i * window_size
    train_end = start + window_size
    test_end = train_end + horizon
    ax.barh(i, window_size, left=start, color="#4C72B0", edgecolor="white")
    ax.barh(i, horizon, left=train_end, color="#DD8452", edgecolor="white")
    ax.text(train_end + horizon + 0.3, i, f"iterasi {i+1}", va="center", fontsize=8)

ax.set_yticks(range(n_windows))
ax.set_yticklabels([f"Fold {i+1}" for i in range(n_windows)])
ax.set_xlabel("Waktu (indeks hari)")
ax.set_title("Rolling-Origin Cross-Validation")
ax.invert_yaxis()

# Legend manual
from matplotlib.patches import Patch
ax.legend(handles=[Patch(color="#4C72B0", label="Train"),
                    Patch(color="#DD8452", label="Test (horizon)")],
          loc="upper right")
plt.tight_layout()
plt.show()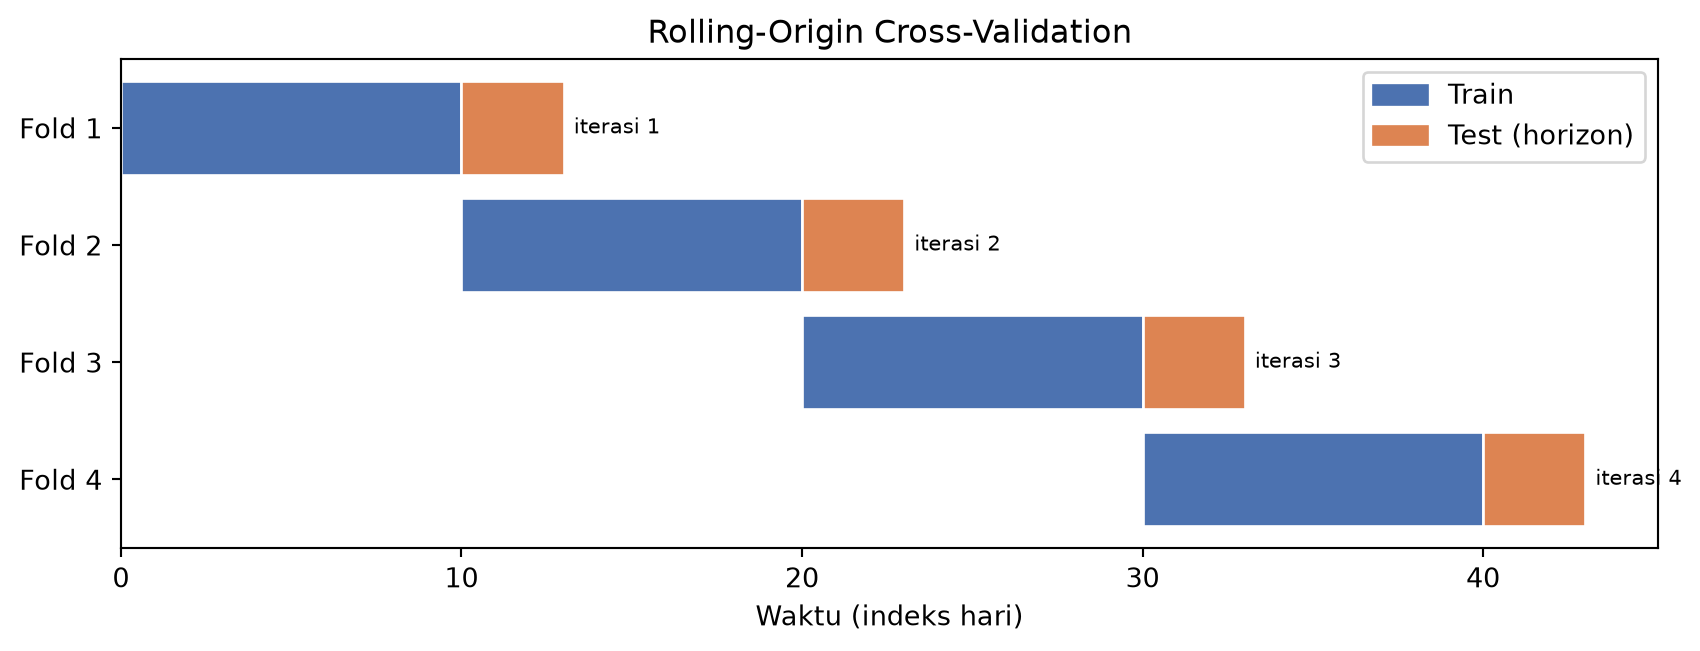
from statsmodels.tsa.holtwinters import ExponentialSmoothing

def rolling_origin_cv(series, n_splits=5, horizon=7, seasonal_periods=7):
    """Rolling-origin cross-validation untuk Holt-Winters."""
    n = len(series)
    fold_size = (n - horizon) // n_splits
    maes = []

    for i in range(n_splits):
        train_end = (i + 1) * fold_size
        train_fold = series.iloc[:train_end]
        test_fold = series.iloc[train_end:train_end + horizon]

        if len(test_fold) < horizon:
            break

        try:
            model = ExponentialSmoothing(
                train_fold, trend="add", seasonal="add",
                seasonal_periods=seasonal_periods
            ).fit()
            pred = model.forecast(horizon)
            maes.append(mean_absolute_error(test_fold, pred))
        except Exception as e:
            print(f"Fold {i+1} gagal: {e}")

    return np.array(maes)

maes = rolling_origin_cv(ts, n_splits=5, horizon=7)
print(f"MAE per fold: {[f'{m:.2f}' for m in maes]}")
print(f"Rata-rata   : {maes.mean():.2f} ± {maes.std():.2f}")
MAE per fold: ['1095.49', '879.34', '837.36', '705.59', '1119.10']
Rata-rata : 927.38 ± 157.88Mengapa rolling-origin lebih baik dari single split? Ia menguji model pada beberapa periode berbeda, sehingga estimasi performa lebih stabil dan lebih representatif. Model yang baik harus konsisten di seluruh fold—jika MAE sangat bervariasi antar fold, model mungkin tidak stabil.
Sekarang kita kembali ke dataset Telco. Di Bab 9, model klasifikasi menjawab “apakah pelanggan ini akan churn?” — tetapi tidak menjawab “kapan?”.
Analisis survival menjawab pertanyaan kedua—dan memberi kita pemahaman yang lebih kaya tentang churn.
Analisis survival memodelkan waktu sampai kejadian (dalam kasus kita: bulan sampai churn). Ada tiga konsep inti:
from decanal.utils import load_churn_clean

df_telco = load_churn_clean()

# Konvensi: event=1 jika churn, 0 jika disensor (belum churn)
# Duration = tenure (bulan)
df_surv = pd.DataFrame({
    "duration": df_telco["tenure"],
    "event": (df_telco["Churn"] == "Yes").astype(int),
    "contract": df_telco["Contract"],
})

print(f"Total pelanggan   : {len(df_surv):,}")
print(f"Churn (event=1)   : {df_surv['event'].sum():,} ({df_surv['event'].mean():.1%})")
print(f"Disensor (event=0): {(1 - df_surv['event']).sum():,}")
print(f"Median tenure     : {df_surv['duration'].median():.0f} bulan")
Total pelanggan : 7,043
Churn (event=1) : 1,869 (26.5%)
Disensor (event=0): 5,174
Median tenure : 29 bulanfrom lifelines import KaplanMeierFitter
fig, ax = plt.subplots(figsize=(9, 5))
for contract, color in [("Month-to-month", "#DD8452"),
("One year", "#55A868"),
("Two year", "#4C72B0")]:
subset = df_surv[df_surv["contract"] == contract]
kmf = KaplanMeierFitter()
kmf.fit(subset["duration"], subset["event"], label=contract)
kmf.plot_survival_function(ax=ax, color=color, ci_show=True, alpha=0.7)
ax.set_xlabel("Tenure (bulan)")
ax.set_ylabel("Probabilitas bertahan")
ax.set_title("Kurva Survival Kaplan-Meier per Tipe Kontrak")
ax.grid(True, alpha=0.3)
ax.legend(title="Kontrak")
plt.tight_layout()
plt.show()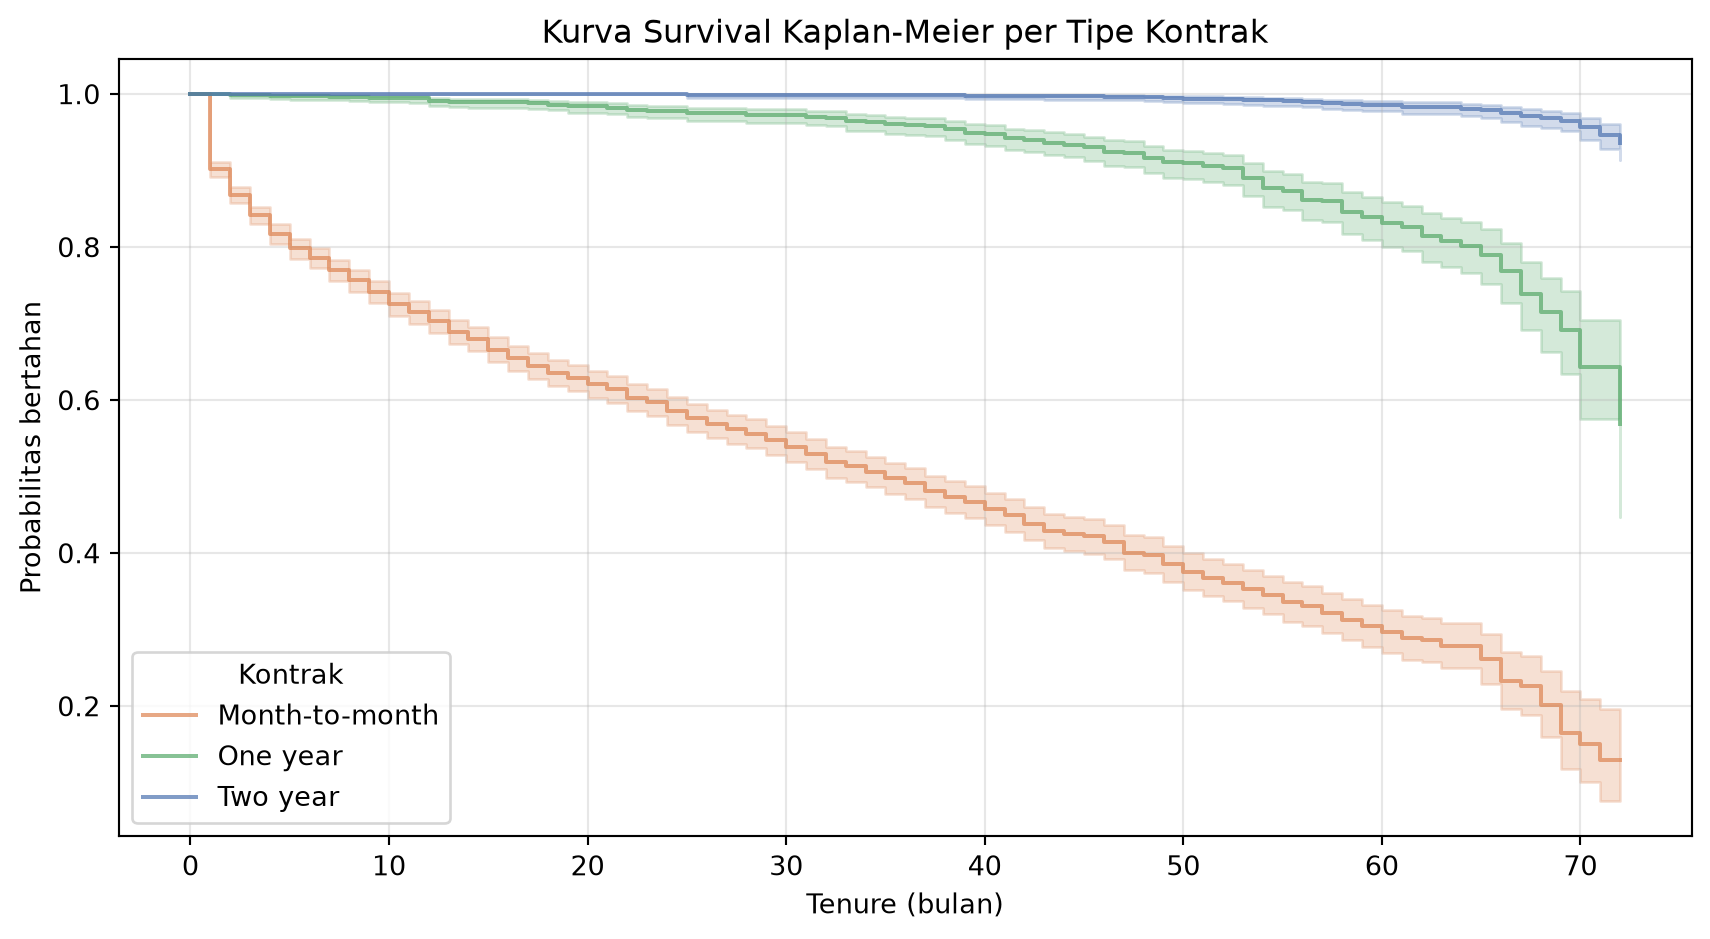
Cara membaca kurva survival:
Perhatikan: kurva kontrak bulanan turun jauh lebih cepat daripada kontrak tahunan dan dua tahun. Ini mengkonfirmasi temuan Bagian I dengan cara yang lebih kaya—kita tidak hanya tahu apakah kontrak memengaruhi churn, tetapi juga kapan efeknya paling kuat.
Censoring adalah kunci. Pelanggan yang belum churn sampai akhir pengamatan bukan “tidak churn”—mereka hanya belum churn sampai sekarang. Analisis survival menangani mereka dengan benar, sedangkan analisis proporsi sederhana (churn rate) mengabaikan dimensi waktu. Inilah mengapa analisis survival lebih informatif.
from lifelines.statistics import logrank_test

# Bandingkan kontrak bulanan vs dua tahun
monthly = df_surv[df_surv["contract"] == "Month-to-month"]
two_year = df_surv[df_surv["contract"] == "Two year"]

result = logrank_test(
    monthly["duration"], two_year["duration"],
    event_observed_A=monthly["event"],
    event_observed_B=two_year["event"],
)

print(f"Uji log-rank — bulanan vs dua tahun:")
print(f"  Statistic: {result.test_statistic:.2f}")
print(f"  p-value  : {result.p_value:.2e}")
if result.p_value < 0.05:
    print("  → Kurva survival BERBEDA secara signifikan")
else:
    print("  → Tidak cukup bukti bahwa kurva berbeda")
Uji log-rank — bulanan vs dua tahun:
Statistic: 1550.51
p-value : 0.00e+00
→ Kurva survival BERBEDA secara signifikanAnalisis survival memberi kita parameter yang lebih kaya daripada model klasifikasi saja:
Analisis survival formal dengan model Cox Proportional Hazards—yang menguji efek multivariabel terhadap hazard—akan sangat berguna untuk keputusan retensi. Namun, ia membutuhkan asumsi proportional hazards yang tidak selalu terpenuhi. Untuk buku ini, kita cukup menggunakan Kaplan-Meier dan log-rank test sebagai pengantar. Pembaca yang tertarik dapat mengeksplorasi lifelines.CoxPHFitter secara mandiri.
Sekarang kita memiliki dua kerangka time series: - Forecasting (retail): memprediksi nilai kontinu di masa depan. - Survival analysis (Telco): memodelkan waktu sampai kejadian.
Keduanya akan menjadi fondasi untuk simulasi Monte Carlo di Bab 12—di mana kita akan menggunakan distribusi probabilitas dari data historis untuk mensimulasikan skenario masa depan.
Latihan 10.1 — Dekomposisi multiplikatif. Gunakan seasonal_decompose dengan model="multiplicative" pada daily["total_sold"]. Bandingkan plot residual aditif dan multiplikatif. Mana yang residualnya lebih “seperti noise”? Mengapa?
Latihan 10.2 — Agregasi mingguan. Alih-alih harian, agregasi data retail ke mingguan (resample("W").sum()). Lakukan dekomposisi dengan period=52. Apakah pola musiman tahunan terlihat? Bandingkan dengan dekomposisi harian.
Latihan 10.3 — ARIMA tuning. Coba beberapa kombinasi (p, d, q) untuk ARIMA—misalnya (1,1,1), (2,1,1), (1,1,2), (2,1,2). Bandingkan MAE pada test set. Model mana yang terbaik? Berapa lama waktu fitting untuk masing-masing?
Latihan 10.4 — Rolling-origin untuk ARIMA. Modifikasi fungsi rolling_origin_cv agar menggunakan ARIMA, bukan Holt-Winters. Bandingkan MAE rata-rata antara ARIMA dan Holt-Winters pada 5 fold. Metode mana yang lebih stabil?
Latihan 10.5 — Survival per segmen. Buat kurva Kaplan-Meier yang dipisah berdasarkan InternetService (bukan Contract). Apakah ada perbedaan survival antara pelanggan fiber optic, DSL, dan tanpa internet? Gunakan log-rank test untuk menguji signifikansi.
Latihan 10.6 — Hazard function. Plot hazard function (bukan survival function) dari KaplanMeierFitter menggunakan .cumulative_density_. Pada bulan berapa hazard paling tinggi? Apa implikasinya untuk strategi retensi?
Petunjuk Latihan 10.3. ARIMA dengan order lebih tinggi tidak selalu lebih baik. Model dengan terlalu banyak parameter bisa overfitting—sama seperti di Bab 7. Perhatikan juga waktu fitting: ARIMA(2,1,2) jauh lebih lambat dari ARIMA(1,1,1). Gunakan AIC (dari model.aic) sebagai panduan awal, tetapi validasi dengan test MAE.
Jembatan. Bab ini memberi kita dua kemampuan baru:
Forecasting—memprediksi nilai kontinu di masa depan (retail). Ini akan menjadi input untuk inventory optimization di Bab 16 dan simulasi keputusan di Bab 17.
Survival analysis—memodelkan kapan kejadian terjadi (Telco). Ini memberi kita distribusi waktu churn, yang dapat digunakan untuk:
Tetapi forecasting memberi kita satu titik prediksi—bukan distribusi. Padahal, keputusan nyata selalu menghadapi ketidakpastian: - Permintaan bisa lebih tinggi atau lebih rendah dari forecast. - Churn bisa terjadi lebih cepat atau lebih lambat.
Simulasi Monte Carlo—topik Bab 12—akan menjembatani gap ini: ia menggunakan distribusi dari data historis untuk menghasilkan ribuan skenario masa depan, sehingga kita dapat mengevaluasi keputusan berdasarkan distribusi hasil, bukan hanya satu titik prediksi.
Bab 11 akan terlebih dahulu memperkenalkan unsupervised learning—clustering dan PCA—untuk menemukan segmen tersembunyi dalam data. Ini adalah jembatan terakhir sebelum Bagian III: setelah kita dapat memprediksi dan mengelompokkan, kita akan mensimulasikan dan mengoptimalkan.
Dalam bab ini kita telah:
Sampai di sini, kita telah memprediksi nilai (Bab 8), kelas (Bab 9), dan waktu (Bab 10). Tetapi kita belum mengeksplorasi struktur data itu sendiri—apakah ada kelompok alami di dalamnya yang tidak kita ketahui?
Unsupervised learning—topik Bab 11—akan mengajarkan kita untuk menemukan segmen tersembunyi dalam data tanpa label:
Bab 11 akan menjadi jembatan terakhir sebelum Bagian III. Setelah kita dapat memprediksi dan mengelompokkan, kita akan mensimulasikan dan mengoptimalkan—itulah inti dari prescriptive analytics.