---
jupyter: decanal
---
# Simulation for Decision Making {#sec-simulasi-keputusan}
::: {.callout-note appearance="simple"}
**Tujuan pembelajaran.** Setelah menyelesaikan bab ini, kita akan mampu:
1. Menjelaskan mengapa **optimasi deterministik** (Bab 14–16) tidak cukup di dunia nyata.
2. Menerapkan **simulation-optimization** untuk mengevaluasi keputusan di bawah ketidakpastian.
3. Membedakan **expected value optimization**, **robust optimization**, dan **stochastic programming**.
4. Membangun **scenario-based optimization** menggunakan skenario dari simulasi Monte Carlo.
5. Mengevaluasi keputusan berdasarkan **distribusi hasil**—bukan hanya ekspektasi.
6. Menerapkan simulation-optimization pada dua kasus: **alokasi retensi** dan **inventori retail**.
7. Memahami trade-off antara **expected performance** dan **robustness**.
:::
## Mengapa Optimasi Determinstik Tidak Cukup
Di Bab 14–16, kita membangun model optimasi yang mengasumsikan **parameter diketahui dengan pasti**:
- Probabilitas churn pelanggan = 0,72.
- Permintaan toko = 600 unit.
- Efektivitas intervensi = 30%.
Tetapi di dunia nyata, **parameter ini tidak pasti**. Probabilitas churn adalah **estimasi** dari model prediktif (Bab 9)—dengan **standard error** dan **ketidakpastian model**. Permintaan adalah **forecast** (Bab 10)—dengan **rentang kepercayaan**. Efektivitas intervensi adalah **asumsi**—yang mungkin berbeda di lapangan.
**Optimasi deterministik** mengabaikan ketidakpastian ini. Solusi yang dihasilkan **optimal untuk satu skenario**—tetapi bisa **sangat buruk** jika skenario aktual berbeda.
::: {.callout-important}
**Contoh konkret.** Misalkan LP merekomendasikan mengintervensi 200 pelanggan berdasarkan asumsi probabilitas churn 0,72. Jika probabilitas sebenarnya hanya 0,50:
- **Jika optimasi deterministik**: kita tetap mengintervensi 200 pelanggan— tetapi sebagian besar tidak akan churn, sehingga **banyak biaya terbuang**.
- **Jika keputusan robust**: kita mengintervensi lebih sedikit, atau mengalokasikan anggaran ke **diversifikasi**—sehingga keputusan tetap baik di berbagai skenario.
**Simulation-optimization** menjembatani gap ini: ia menggunakan **simulasi** untuk menghasilkan berbagai skenario, dan **optimasi** untuk menemukan keputusan yang **baik di semua skenario**—bukan hanya optimal di satu skenario.
:::
## Tiga Pendekatan untuk Keputusan di Bawah Ketidakpastian
Ada tiga pendekatan utama, dengan tingkat kompleksitas dan asumsi yang berbeda:
| Pendekatan | Prinsip | Kapan dipakai |
|---|---|---|
| **Expected Value Optimization** | Optimalkan **rata-rata** dari distribusi hasil | Ketika kita netral risiko dan keputusan berulang |
| **Robust Optimization** | Optimalkan **skenario terburuk** (worst-case) | Ketika kita menghindari risiko ekstrem |
| **Stochastic Programming** | Optimalkan **ekspektasi** dengan **recourse** (tindakan korektif) | Ketika ada keputusan bertahap |
### 1. Expected Value Optimization
**Prinsip:** ganti setiap parameter tidak pasti dengan **nilai ekspektasinya**, lalu selesaikan model optimasi deterministik.
**Kelebihan:** sederhana—cukup gunakan rata-rata dari simulasi.
**Kekurangan:** mengabaikan **distribusi**—solusi bisa sangat buruk di skenario ekstrem.
### 2. Robust Optimization
**Prinsip:** temukan keputusan yang **meminimalkan kerugian maksimum** di seluruh skenario—atau **memaksimalkan hasil minimum**.
**Kelebihan:** tahan terhadap skenario terburuk.
**Kekurangan:** bisa **terlalu konservatif**—mengorbankan banyak expected value untuk menghindari risiko yang jarang terjadi.
### 3. Stochastic Programming
**Prinsip:** model keputusan **dua tahap**:
- **Tahap 1**: keputusan **sekarang**, sebelum ketidakpastian terungkap.
- **Tahap 2**: keputusan **korektif**, setelah ketidakpastian terungkap.
**Kelebihan:** paling realistis—mencerminkan keputusan nyata yang bertahap.
**Kekurangan:** paling kompleks—membutuhkan formulasi matematis yang lebih canggih.
::: {.callout-tip}
**Pendekatan mana yang tepat?** Tergantung pada **konteks keputusan**:
| Konteks | Pendekatan yang disarankan |
|---|---|
| Keputusan berulang (mis. retensi harian) | **Expected value**—rata-rata jangka panjang mendekati ekspektasi |
| Keputusan sekali seumur hidup (mis. merger) | **Robust**—hindari hasil terburuk |
| Keputusan bertahap (mis. inventori bulanan) | **Stochastic programming**—manfaatkan informasi baru |
Untuk buku ini, kita akan fokus pada **expected value** dan **robust optimization**—karena keduanya paling mudah dipahami dan diimplementasikan dengan alat yang sudah kita miliki. **Stochastic programming** akan disinggung sebagai konsep, tetapi tidak didemonstrasikan secara mendalam.
:::
## Simulation-Optimization: Kerangka Kerja
**Simulation-optimization** adalah proses **berulang** yang menggabungkan simulasi dan optimasi:
```{mermaid}
flowchart LR
    A[Model<br/>probabilistik] --> B[Bangkitkan<br/>skenario]
    B --> C[Optimasi<br/>per skenario]
    C --> D[Evaluasi<br/>out-of-sample]
    D --> E[Pilih keputusan<br/>terbaik]
    E -.->|Iterasi| B
```
**Langkah-langkah:**
1. **Definisikan model probabilistik** untuk parameter tidak pasti (dari Bab 12).
2. **Bangkitkan N skenario**—setiap skenario adalah satu set parameter yang mungkin.
3. **Optimasi untuk setiap skenario**—atau optimasi untuk **aggregate** (expected value).
4. **Evaluasi keputusan** pada skenario **baru** (out-of-sample) untuk mengukur robustness.
5. **Pilih keputusan** berdasarkan kriteria—expected value, worst-case, atau kombinasi.
::: {.callout-note}
**Mengapa perlu evaluasi out-of-sample?** Karena keputusan yang optimal untuk skenario yang **digunakan dalam optimasi** belum tentu optimal untuk skenario **baru**—sama seperti overfitting di Bab 7. Kita perlu menguji keputusan pada skenario yang **tidak** dipakai dalam pelatihan.
:::
## Aplikasi 1: Alokasi Retensi di Bawah Ketidakpastian
Kita kembali ke masalah alokasi retensi dari Bab 14—tetapi kali ini dengan **ketidakpastian** dalam parameter:
- Probabilitas churn per segmen **tidak pasti**—estimasi dari model dengan standard error.
- Efektivitas intervensi **tidak pasti**—bisa lebih tinggi atau lebih rendah dari asumsi.
- LTV pelanggan **tidak pasti**—bergantung pada perilaku masa depan.
### Menyiapkan Model Probabilistik
```{python}
#| label: setup
import sys
sys.path.insert(0, ".")
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import warnings
warnings.filterwarnings("ignore")

from pulp import (
    LpProblem, LpVariable, LpMaximize, LpMinimize, LpStatus,
    lpSum, value, PULP_CBC_CMD, LpBinary, LpInteger, LpContinuous,
)

np.random.seed(42)
```
```{python}
#| label: uncertain-params
# Parameter dasar (estimasi titik)
segments = pd.DataFrame({
    "segmen": ["Premium Baru", "Loyal Hemat", "Mainstream"],
    "n_pelanggan": [800, 2400, 3800],
    "p_churn": [0.55, 0.12, 0.28],
    "ltv": [1_200_000, 600_000, 900_000],
    "biaya_intervensi": [200_000, 80_000, 120_000],
    "efektivitas": [0.40, 0.25, 0.30],
})

# Ketidakpastian: standard error relatif
# (dalam praktik, ini berasal dari model Bab 9 atau data historis)
p_churn_se = [0.05, 0.02, 0.03]       # standard error probabilitas churn
efektivitas_se = [0.10, 0.05, 0.08]   # standard error efektivitas
ltv_se_pct = [0.20, 0.15, 0.18]       # standard error relatif LTV

BUDGET = 50_000_000
CAPACITY = 300
```
### Membangkitkan Skenario
```{python}
#| label: generate-scenarios
N_SCENARIOS = 500

def generate_scenario():
    """Bangkitkan satu skenario parameter dari distribusi."""
    p = np.clip(
        np.random.normal(segments["p_churn"], p_churn_se), 0.01, 0.99
    )
    eff = np.clip(
        np.random.normal(segments["efektivitas"], efektivitas_se), 0.01, 0.90
    )
    ltv = segments["ltv"] * (1 + np.random.normal(0, ltv_se_pct))
    return p, eff, ltv

scenarios = [generate_scenario() for _ in range(N_SCENARIOS)]

# Ringkasan skenario
p_all = np.array([s[0] for s in scenarios])
eff_all = np.array([s[1] for s in scenarios])
ltv_all = np.array([s[2] for s in scenarios])

print(f"Skenario yang dibangkitkan: {N_SCENARIOS}")
print(f"\nProbabilitas churn — rata-rata ± std per segmen:")
for i, seg in enumerate(segments["segmen"]):
    print(f"  {seg:15s}: {p_all[:,i].mean():.3f} ± {p_all[:,i].std():.3f}")
print(f"\nEfektivitas — rata-rata ± std per segmen:")
for i, seg in enumerate(segments["segmen"]):
    print(f"  {seg:15s}: {eff_all[:,i].mean():.3f} ± {eff_all[:,i].std():.3f}")
```
### Strategi 1: Expected Value Optimization
Ini adalah pendekatan paling sederhana: ganti parameter dengan **rata-rata** dari simulasi, lalu selesaikan LP.
```{python}
#| label: strategy-ev
def solve_allocation(p_churn, efektivitas, ltv, budget=BUDGET, capacity=CAPACITY):
    """Selesaikan alokasi retensi untuk parameter tertentu."""
    model = LpProblem("alokasi", LpMaximize)
    x = LpVariable.dicts("x", segments["segmen"].tolist(), lowBound=0, cat=LpContinuous)

    # Net benefit per pelanggan (parameter skenario)
    net_benefit = [
        p_churn[i] * efektivitas[i] * ltv[i] - segments.loc[i, "biaya_intervensi"]
        for i in range(len(segments))
    ]

    model += lpSum(net_benefit[i] * x[seg] for i, seg in enumerate(segments["segmen"])), "Obj"
    model += lpSum(segments.loc[i, "biaya_intervensi"] * x[seg]
                   for i, seg in enumerate(segments["segmen"])) <= budget, "Budget"
    model += lpSum(x[seg] for seg in segments["segmen"]) <= capacity, "Capacity"
    for i, seg in enumerate(segments["segmen"]):
        model += x[seg] <= segments.loc[i, "n_pelanggan"], f"Bound_{i}"

    model.solve(PULP_CBC_CMD(msg=False))
    return {seg: value(x[seg]) for seg in segments["segmen"]}

# Expected value optimization
p_mean = p_all.mean(axis=0)
eff_mean = eff_all.mean(axis=0)
ltv_mean = ltv_all.mean(axis=0)

allocation_ev = solve_allocation(p_mean, eff_mean, ltv_mean)
print("Strategi Expected Value — alokasi:")
for seg, n in allocation_ev.items():
    print(f"  {seg:15s}: {n:6.1f} pelanggan")
```
### Strategi 2: Robust Optimization
**Robust optimization** mencari keputusan yang **meminimalkan kerugian maksimum** di seluruh skenario. Implementasinya dengan **skenario terburuk** (worst-case) atau **probabilitas rendah** (mis. persentil 5%).
```{python}
#| label: strategy-robust
# Robust: optimasi untuk skenario "buruk" — p_churn rendah, efektivitas rendah, LTV rendah
# (konservatif: kita asumsikan skenario yang merugikan)

# Ambil persentil 10% untuk setiap parameter (skenario buruk)
p_bad = np.percentile(p_all, 10, axis=0)
eff_bad = np.percentile(eff_all, 10, axis=0)
ltv_bad = np.percentile(ltv_all, 10, axis=0)

allocation_robust = solve_allocation(p_bad, eff_bad, ltv_bad)
print("Strategi Robust (skenario buruk) — alokasi:")
for seg, n in allocation_robust.items():
    print(f"  {seg:15s}: {n:6.1f} pelanggan")
```
::: {.callout-warning}
**Robust optimization dengan skenario terburuk bisa terlalu konservatif.** Jika kita mengoptimalkan untuk skenario persentil 10%, kita mengabaikan 90% kemungkinan—dan mungkin mengorbankan banyak expected value.
Alternatif yang lebih seimbang: **minimax regret**—meminimalkan **penyesalan maksimum** (selisih antara hasil aktual dan hasil terbaik yang mungkin di skenario itu). Kita akan membahas ini di latihan.
:::
### Evaluasi Out-of-Sample: Membandingkan Strategi
Sekarang kita uji kedua strategi pada **skenario baru** yang tidak dipakai dalam optimasi:
```{python}
#| label: out-of-sample-eval
# Bangkitkan skenario uji baru
np.random.seed(123)
N_TEST = 200
test_scenarios = [generate_scenario() for _ in range(N_TEST)]

def evaluate_allocation(allocation, scenarios):
    """Evaluasi alokasi pada sekumpulan skenario."""
    results = []
    for p, eff, ltv in scenarios:
        total_benefit = 0
        total_cost = 0
        for i, seg in enumerate(segments["segmen"]):
            n = allocation[seg]
            net_benefit_i = p[i] * eff[i] * ltv[i] - segments.loc[i, "biaya_intervensi"]
            total_benefit += n * net_benefit_i
            total_cost += n * segments.loc[i, "biaya_intervensi"]
        results.append(total_benefit)
    return np.array(results)

results_ev = evaluate_allocation(allocation_ev, test_scenarios)
results_robust = evaluate_allocation(allocation_robust, test_scenarios)

# Bandingkan distribusi hasil
comparison = pd.DataFrame({
    "Strategi": ["Expected Value", "Robust (P10)"],
    "Mean": [results_ev.mean(), results_robust.mean()],
    "Std": [results_ev.std(), results_robust.std()],
    "P5 (worst)": [np.percentile(results_ev, 5), np.percentile(results_robust, 5)],
    "P95 (best)": [np.percentile(results_ev, 95), np.percentile(results_robust, 95)],
    "Prob(rugi)": [(results_ev < 0).mean(), (results_robust < 0).mean()],
}).round(2)
comparison
```
```{python}
#| label: fig-strategy-comparison
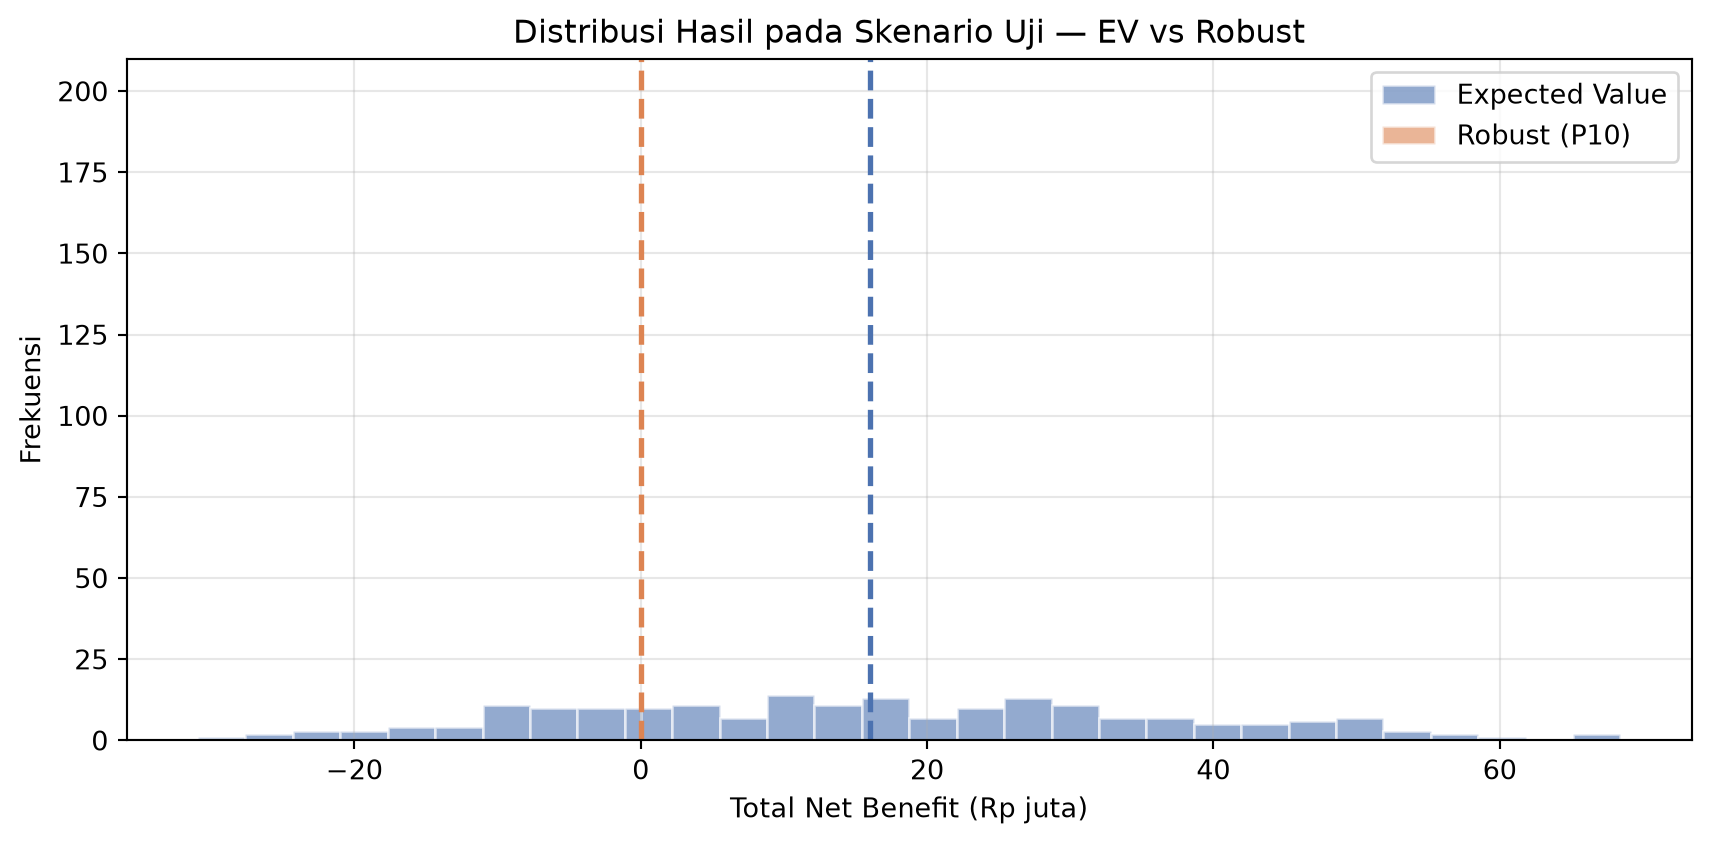
#| fig-cap: "Distribusi hasil untuk dua strategi pada skenario uji. Expected value optimization memiliki mean lebih tinggi tetapi variansi lebih besar; robust memiliki distribusi lebih sempit."
#| fig-width: 9
#| fig-height: 4.5
fig, ax = plt.subplots(figsize=(9, 4.5))
ax.hist(results_ev / 1e6, bins=30, alpha=0.6, label="Expected Value",
        color="#4C72B0", edgecolor="white")
ax.hist(results_robust / 1e6, bins=30, alpha=0.6, label="Robust (P10)",
        color="#DD8452", edgecolor="white")
ax.axvline(results_ev.mean() / 1e6, color="#4C72B0", linestyle="--", linewidth=2)
ax.axvline(results_robust.mean() / 1e6, color="#DD8452", linestyle="--", linewidth=2)
ax.set_xlabel("Total Net Benefit (Rp juta)")
ax.set_ylabel("Frekuensi")
ax.set_title("Distribusi Hasil pada Skenario Uji — EV vs Robust")
ax.legend()
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
```
::: {.callout-important}
**Trade-off klasik: expected value vs robustness.**
| Aspek | Expected Value | Robust |
|---|---|---|
| **Mean** | Lebih tinggi | Lebih rendah (mengorbankan EV) |
| **Std** | Lebih besar | Lebih kecil |
| **Worst-case** | Bisa sangat buruk | Lebih baik |
| **Prob(rugi)** | Lebih tinggi | Lebih rendah |
**Tidak ada strategi yang "benar" secara universal.** Pilihan tergantung pada **preferensi risiko** manajemen:
- Jika perusahaan **netral risiko** (dapat menanggung fluktuasi), pilih **expected value**.
- Jika perusahaan **menghindari risiko** (tidak bisa menanggung kerugian besar), pilih **robust**.
**Dalam praktik**, banyak organisasi menggunakan **kombinasi**: optimalkan expected value dengan **kendala** pada worst-case (mis. "expected benefit harus ≥ X, dan worst-case ≥ Y").
:::
## Aplikasi 2: Inventori Retail di Bawah Ketidakpastian
Kita kembali ke masalah inventori dari Bab 12—tetapi kali ini dengan **optimasi**. Kita ingin mencari **level stok optimal** yang mempertimbangkan ketidakpastian permintaan.
### Model
- **Keputusan**: level stok untuk setiap produk.
- **Ketidakpastian**: permintaan harian.
- **Tujuan**: maksimalkan expected profit (revenue − stockout cost − holding cost).
### Pendekatan: Optimasi untuk Setiap Skenario
```{python}
#| label: retail-inventory-sim
from decanal.utils import load_retail

df_retail = load_retail()
df_retail["Date"] = pd.to_datetime(df_retail["Date"])

# Fokus pada produk dengan volume tertinggi
produk_id = df_retail.groupby("Product ID")["Units Sold"].mean().idxmax()
subset = df_retail[df_retail["Product ID"] == produk_id]

# Parameter biaya (asumsi)
harga_jual = subset["Price"].mean()
biaya_stockout = harga_jual * 0.5  # margin yang hilang
biaya_holding = harga_jual * 0.02  # biaya penyimpanan per hari

demand_data = subset["Units Sold"].values

print(f"Produk: {produk_id}")
print(f"Rata-rata permintaan harian: {demand_data.mean():.1f} unit")
print(f"Std permintaan             : {demand_data.std():.1f} unit")
print(f"Harga jual                 : Rp {harga_jual:,.0f}")
print(f"Biaya stockout per unit    : Rp {biaya_stockout:,.0f}")
print(f"Biaya holding per unit/hari: Rp {biaya_holding:,.0f}")
```
```{python}
#| label: inventory-opt-sim
def simulate_inventory(stock_level, demand_samples):
    """Simulasi total profit untuk level stok tertentu."""
    stockouts = np.maximum(0, demand_samples - stock_level)
    holdings = np.maximum(0, stock_level - demand_samples)
    sales = np.minimum(demand_samples, stock_level)

    revenue = sales * harga_jual
    stockout_cost = stockouts * biaya_stockout
    holding_cost = holdings * biaya_holding

    return revenue - stockout_cost - holding_cost

# Bangkitkan skenario permintaan (bootstrap dari data historis)
np.random.seed(42)
N_SCEN = 1000
N_DAYS = 30
demand_scenarios = np.random.choice(demand_data, size=(N_SCEN, N_DAYS), replace=True)

# Uji berbagai level stok
stock_levels = np.arange(10, 60, 2)
results = []

for level in stock_levels:
    profits = [simulate_inventory(level, ds).sum() for ds in demand_scenarios]
    profits = np.array(profits)
    results.append({
        "stock_level": level,
        "mean_profit": profits.mean(),
        "std_profit": profits.std(),
        "p5_profit": np.percentile(profits, 5),
        "p95_profit": np.percentile(profits, 95),
    })

results_df = pd.DataFrame(results)
results_df["mean_profit_juta"] = results_df["mean_profit"] / 1e6
results_df["p5_profit_juta"] = results_df["p5_profit"] / 1e6

# Level optimal berdasarkan mean
optimal_mean = results_df.loc[results_df["mean_profit"].idxmax()]
# Level optimal berdasarkan P5 (robust)
optimal_p5 = results_df.loc[results_df["p5_profit"].idxmax()]

print(f"Level stok optimal (mean)  : {optimal_mean['stock_level']:.0f} unit")
print(f"  → Mean profit: Rp {optimal_mean['mean_profit_juta']:.2f} juta")
print(f"  → P5 profit  : Rp {optimal_mean['p5_profit_juta']:.2f} juta")
print()
print(f"Level stok optimal (P5)    : {optimal_p5['stock_level']:.0f} unit")
print(f"  → Mean profit: Rp {optimal_p5['mean_profit_juta']:.2f} juta")
print(f"  → P5 profit  : Rp {optimal_p5['p5_profit_juta']:.2f} juta")
```
```{python}
#| label: fig-inventory-opt-sim
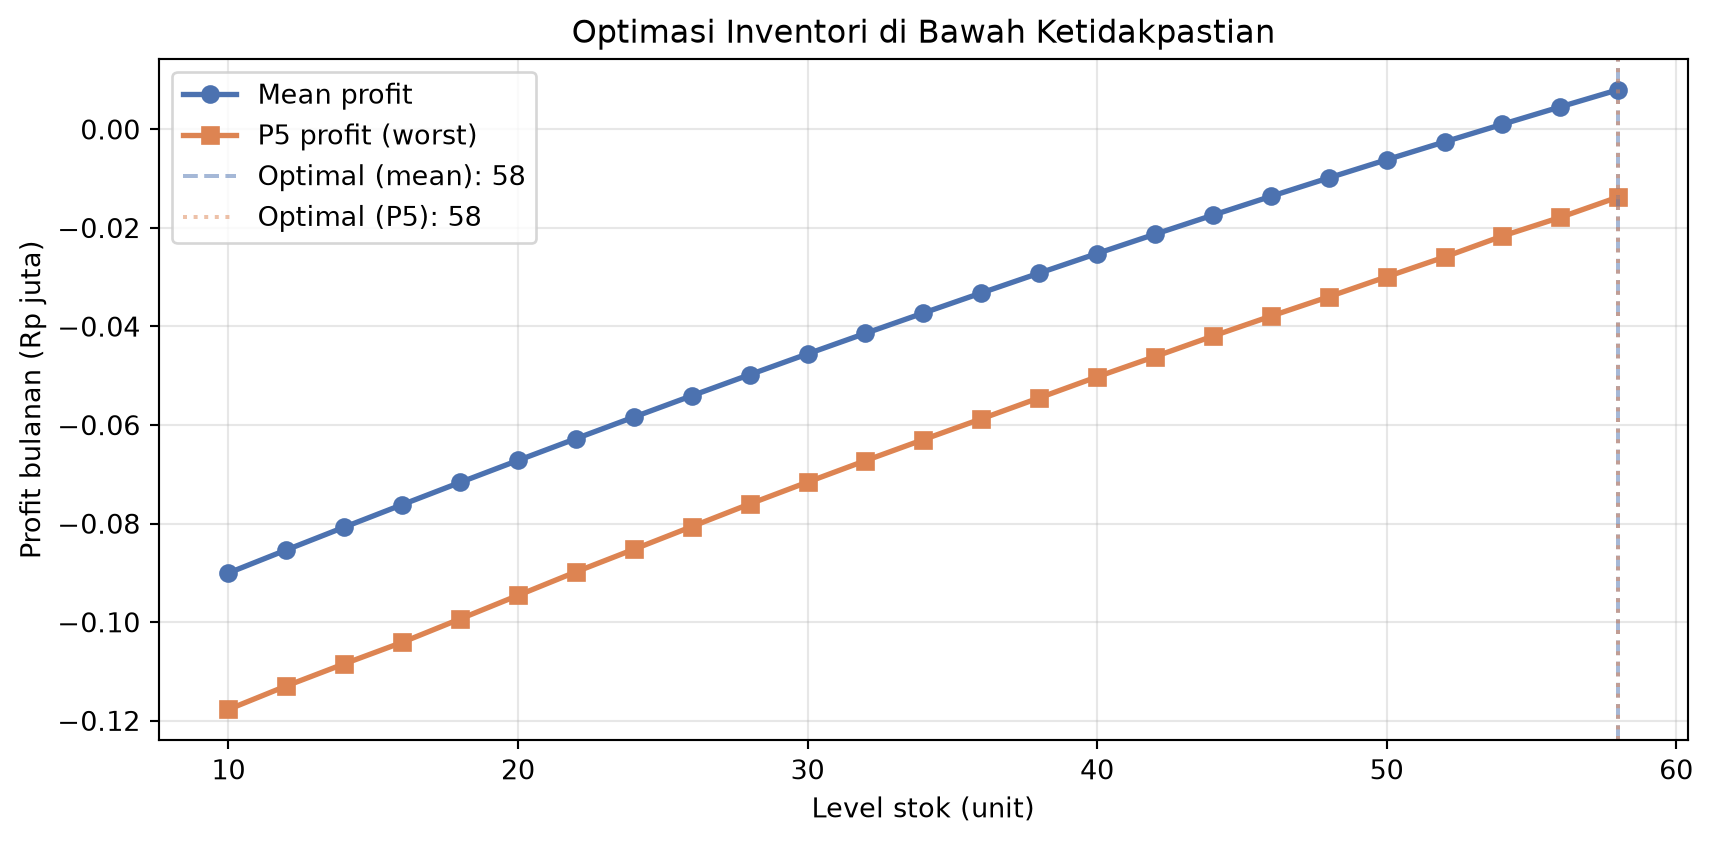
#| fig-cap: "Mean profit dan P5 profit sebagai fungsi level stok. Level optimal berdasarkan mean berbeda dari level optimal berdasarkan P5—mencerminkan trade-off risiko."
#| fig-width: 9
#| fig-height: 4.5
fig, ax = plt.subplots(figsize=(9, 4.5))
ax.plot(results_df["stock_level"], results_df["mean_profit_juta"],
        marker="o", linewidth=2, color="#4C72B0", label="Mean profit")
ax.plot(results_df["stock_level"], results_df["p5_profit_juta"],
        marker="s", linewidth=2, color="#DD8452", label="P5 profit (worst)")

ax.axvline(optimal_mean["stock_level"], color="#4C72B0", linestyle="--",
           alpha=0.5, label=f"Optimal (mean): {optimal_mean['stock_level']:.0f}")
ax.axvline(optimal_p5["stock_level"], color="#DD8452", linestyle=":",
           alpha=0.5, label=f"Optimal (P5): {optimal_p5['stock_level']:.0f}")

ax.set_xlabel("Level stok (unit)")
ax.set_ylabel("Profit bulanan (Rp juta)")
ax.set_title("Optimasi Inventori di Bawah Ketidakpastian")
ax.legend()
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
```
**Temuan:** Level stok optimal berdasarkan **mean** berbeda dari level stok optimal berdasarkan **P5** (worst-case). Level stok yang lebih tinggi:
- **Meningkatkan** P5 profit (mengurangi risiko stockout).
- **Menurunkan** mean profit (karena holding cost lebih tinggi).
**Trade-off ini adalah inti dari keputusan di bawah ketidakpastian:** berapa banyak **expected value** yang bersedia kita korbankan untuk **mengurangi risiko**?
---
### Value-at-Risk untuk Keputusan Inventori
Selain mean dan P5, kita bisa mengevaluasi keputusan dengan **Value-at-Risk (VaR)**—seberapa besar kerugian yang mungkin terjadi pada tingkat kepercayaan tertentu.
```{python}
#| label: inventory-var
def compute_var(profits, confidence=0.95):
    """VaR 95%: kerugian yang tidak akan terlampaui dengan probabilitas 95%."""
    return np.percentile(profits, (1 - confidence) * 100)

# Bandingkan VaR untuk tiga level stok
levels_to_compare = [20, 30, 40]

comparison_var = []
for level in levels_to_compare:
    profits = np.array([simulate_inventory(level, ds).sum() for ds in demand_scenarios])
    comparison_var.append({
        "stock_level": level,
        "mean_profit (Rp juta)": profits.mean() / 1e6,
        "std (Rp juta)": profits.std() / 1e6,
        "VaR 95% (Rp juta)": compute_var(profits) / 1e6,
        "prob_rugi (%)": (profits < 0).mean() * 100,
    })

pd.DataFrame(comparison_var).round(2)
```
::: {.callout-tip}
**Cara membaca VaR untuk inventori:**
- **VaR 95% = −Rp 2 juta** berarti: "Ada 5% kemungkinan profit bulanan kurang dari −Rp 2 juta (rugi lebih dari Rp 2 juta)."
- **Prob(rugi) = 8%** berarti: "Dalam 8% skenario, kita mengalami kerugian."
Kedua metrik ini memberi **gambaran risiko** yang lebih lengkap daripada mean saja. Keputusan akhir harus mempertimbangkan **keduanya**—bukan hanya expected profit.
:::
## Scenario-Based Optimization: Pendekatan Lebih Kaya
**Expected value optimization** menggunakan **satu set parameter rata-rata**—yang menyembunyikan distribusi. **Scenario-based optimization** menggunakan **banyak skenario** secara langsung, dan mencari keputusan yang memaksimalkan **rata-rata hasil di seluruh skenario**.
### Formulasi
Alih-alih satu set parameter, kita memiliki **N skenario**—masing-masing dengan parameter berbeda. Kita ingin memilih alokasi $x$ yang memaksimalkan:
$$\max \, \frac{1}{N} \sum_{s=1}^{N} \text{benefit}(x, \text{skenario}_s)$$
Ini adalah **expected value** atas **distribusi skenario**—bukan hanya rata-rata parameter. Untuk fungsi linear, kedua pendekatan ini **ekuivalen**—tetapi untuk fungsi non-linear, mereka bisa berbeda.
::: {.callout-note}
**Untuk model alokasi retensi kita, kedua pendekatan ekuivalen** karena fungsi tujuan linear terhadap parameter. Tetapi untuk model yang lebih kompleks—misalnya dengan **kendala probabilistik** (mis. "probabilitas stockout ≤ 5%")—scenario-based optimization menjadi **jauh lebih kuat**.
Contoh kendala probabilistik: "Kita ingin probabilitas kehabisan stok ≤ 5%." Ini tidak dapat diekspresikan dalam model deterministik—tetapi dapat diekspresikan dalam scenario-based optimization: "Dalam setidaknya 95% skenario, stok harus cukup."
:::
## Latihan Terbimbing
**Latihan 17.1 — Expected value vs robust.**
Untuk model alokasi retensi, bandingkan **tiga strategi**: (a) expected value, (b) robust P10, (c) robust P25. Evaluasi pada 200 skenario uji. Strategi mana yang memiliki **mean tertinggi**? Mana yang memiliki **P5 tertinggi**? Mana yang kita rekomendasikan untuk perusahaan yang **baru saja mengalami kerugian besar**?
**Latihan 17.2 — Minimax regret.**
Implementasikan **minimax regret** untuk model alokasi retensi: untuk setiap skenario, hitung regret (selisih antara hasil strategi dan hasil terbaik yang mungkin di skenario itu), lalu pilih strategi yang **meminimalkan regret maksimum**. Bandingkan hasilnya dengan expected value dan robust.
**Latihan 17.3 — Inventori multi-produk.**
Kembangkan model inventori untuk **dua produk** dengan permintaan yang **berkorelasi** (korelasi 0,3). Bangkitkan skenario permintaan bersama, dan optimalkan level stok untuk **kedua produk secara bersamaan** dengan kendala **total kapasitas gudang** (mis. 80 unit). Bagaimana korelasi mempengaruhi level stok optimal?
**Latihan 17.4 — Value of information.**
Dalam model alokasi retensi, hitung **Expected Value of Perfect Information (EVPI)** dengan simulasi: berapa selisih antara expected benefit jika kita **tahu parameter sebenarnya** (perfect information) versus **tidak tahu** (expected value optimization)? Bandingkan dengan EVPI dari Bab 13.
**Latihan 17.5 — Kendala probabilistik.**
Modifikasi model inventori dengan menambahkan **kendala probabilistik**: "Probabilitas stockout ≤ 5%." Implementasikan dengan scenario-based optimization: cari level stok minimum yang memenuhi kendala ini di 95% skenario. Bandingkan dengan level stok optimal berdasarkan mean.
::: {.callout-note collapse="true"}
**Petunjuk Latihan 17.2.** Minimax regret membutuhkan **matriks regret**—baris = strategi, kolom = skenario. Untuk setiap skenario, regret = hasil terbaik di skenario itu − hasil strategi. Kemudian untuk setiap strategi, ambil **regret maksimum** di seluruh skenario, dan pilih strategi dengan regret maksimum **terkecil**.
:::
## Kotak "Jembatan": Dari Simulasi ke Integrasi
::: {.callout-important}
**Jembatan.** Bab ini melengkapi **alat keputusan** Bagian III:
| Bab | Alat | Kapan dipakai |
|---|---|---|
| 13 | Decision framework | Keputusan satu pelanggan |
| 14 | Linear programming | Alokasi sumber daya, hubungan linear |
| 15 | Integer/binary/nonlinear | Keputusan diskrit, logika |
| 16 | Network & multi-objective | Aliran jaringan, trade-off tujuan |
| **17** | **Simulation-optimization** | **Ketidakpastian parameter** |
Kita sekarang dapat **mengoptimalkan di dunia yang tidak pasti**—bukan hanya di dunia yang pasti. Kita dapat:
- Mengevaluasi keputusan berdasarkan **distribusi hasil**, bukan hanya ekspektasi.
- Memilih strategi yang **tahan** terhadap berbagai skenario.
- Mengukur **risiko** dengan VaR, P5, dan probabilitas kerugian.
**Tetapi semua ini masih merupakan bagian-bagian terpisah.** Bab 18 akan **mengintegrasikan semuanya** dalam satu proyek end-to-end:
- Dari **data mentah** hingga **rekomendasi kebijakan**.
- Menggabungkan **prediksi** (Bab 7–12) dengan **optimasi** (Bab 14–17).
- Menghasilkan **dashboard** dan **laporan eksekutif** untuk keputusan nyata.
**Bab 18 adalah puncak buku ini**—di mana semua alat yang telah kita bangun bekerja bersama untuk menyelesaikan masalah bisnis yang sesungguhnya.
:::
## Rangkuman
Dalam bab ini kita telah:
- **Memahami mengapa optimasi deterministik tidak cukup** di dunia nyata—parameter tidak pasti, dan solusi optimal untuk satu skenario bisa buruk di skenario lain.
- **Membedakan tiga pendekatan** untuk keputusan di bawah ketidakpastian: expected value, robust, dan stochastic programming.
- **Membangun simulation-optimization** dengan membangkitkan skenario dari distribusi parameter, optimasi per skenario, dan evaluasi out-of-sample.
- **Menerapkan expected value optimization** pada alokasi retensi—mengganti parameter dengan rata-rata dari simulasi.
- **Menerapkan robust optimization** dengan skenario buruk (P10)—menghasilkan keputusan yang lebih tahan terhadap risiko.
- **Membandingkan strategi** pada skenario uji baru—menemukan trade-off klasik antara mean dan worst-case.
- **Menerapkan simulation-optimization** pada inventori retail—menemukan level stok optimal yang mempertimbangkan ketidakpastian permintaan.
- **Mengukur risiko** dengan VaR, P5, dan probabilitas kerugian—melengkapi gambaran expected value dengan dimensi risiko.
- **Memahami keterbatasan expected value optimization**: ia mengabaikan distribusi, dan bisa menghasilkan keputusan yang rapuh.
## Jembatan ke Bab 18
Kita telah menyelesaikan **seluruh alat** untuk decision analytics:
**Bagian I** mengajarkan kita **melihat** dan **memahami** data.
**Bagian II** mengajarkan kita **memprediksi**.
**Bagian III** mengajarkan kita **mengoptimalkan** dan **memutuskan**.
Sekarang saatnya **menggabungkan semuanya** dalam satu proyek end-to-end. Bab 18—**Integrasi & Proyek Akhir**—akan:
- Mengambil **satu masalah bisnis** dari awal hingga akhir.
- Menggunakan **model prediktif** dari Bagian II untuk menghasilkan probabilitas.
- Menggunakan **optimasi** dari Bagian III untuk memilih tindakan.
- Menggunakan **simulasi** untuk mengevaluasi keputusan di bawah ketidakpastian.
- Menghasilkan **rekomendasi kebijakan** yang dapat dieksekusi.
- Menyajikan hasil dalam **dashboard eksekutif** dan **laporan**.
Ini adalah **puncak buku**—dan kesempatan untuk melihat bagaimana semua bagian bekerja bersama.