---
jupyter: decanal
---
# Klasifikasi: Membandingkan Model dan Memilih yang Tepat {#sec-klasifikasi}
::: {.callout-note appearance="simple"}
**Tujuan pembelajaran.** Setelah menyelesaikan bab ini, kita akan mampu:
1. Membangun enam model klasifikasi—dari Logistic Regression hingga Gradient Boosting—pada dataset yang sama.
2. Membaca **confusion matrix** dan memahami implikasi bisnis dari setiap sel.
3. Memilih metrik evaluasi yang tepat berdasarkan **konsekuensi kesalahan**, bukan berdasarkan default.
4. Menangani **kelas tidak seimbang** dengan `class_weight`, threshold adjustment, dan memahami kapan resampling diperlukan.
5. Membedakan **ranking** (AUC) dari **kalibrasi** (probabilitas yang dapat dipercaya).
6. Menginterpretasikan **feature importance** dan menghubungkannya kembali ke diagnosis Bagian I.
7. Memilih model akhir berdasarkan trade-off antara performa, interpretabilitas, dan biaya komputasi.
:::
## Dari Satu Model ke Enam
Di Bab 8 kita membangun **satu** model klasifikasi: Logistic Regression. Ia mencapai AUC sekitar 0,85 dan memberikan odds ratio yang dapat diinterpretasikan. Tetapi apakah ia model **terbaik**?
Bab ini akan menjawabnya secara empiris. Kita akan membangun **enam model** pada dataset yang sama, mengevaluasi mereka dengan **metrik yang berbeda**, dan memilih yang paling sesuai dengan **konteks bisnis**.
::: {.callout-important}
**Tidak ada "model terbaik" secara universal.** Model terbaik adalah model yang **paling sesuai dengan pertanyaan, data, dan konsekuensi kesalahan** dari konteks spesifik. Bab ini mengajarkan kita **kerangka untuk memilih**—bukan satu jawaban yang benar.
:::
## Menyiapkan Data
Kita menggunakan pembagian data yang sama sepanjang bab ini agar perbandingan adil:
```{python}
#| label: setup
import sys
sys.path.insert(0, ".")
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
import warnings
warnings.filterwarnings("ignore")

from decanal.utils import load_churn_clean
from sklearn.model_selection import train_test_split, StratifiedKFold, cross_val_score
from sklearn.preprocessing import StandardScaler, OneHotEncoder
from sklearn.compose import ColumnTransformer
from sklearn.pipeline import Pipeline
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LogisticRegression
from sklearn.neighbors import KNeighborsClassifier
from sklearn.naive_bayes import GaussianNB
from sklearn.tree import DecisionTreeClassifier
from sklearn.ensemble import RandomForestClassifier, GradientBoostingClassifier
from sklearn.metrics import (
    confusion_matrix, classification_report, roc_auc_score,
    roc_curve, precision_recall_curve, average_precision_score,
    accuracy_score, precision_score, recall_score, f1_score,
    brier_score_loss,
)
from sklearn.calibration import calibration_curve

RANDOM_STATE = 42
df = load_churn_clean()

# Konvensi: target biner 0/1
y = (df["Churn"] == "Yes").astype(int)
X = df.drop(columns=["Churn"])

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=RANDOM_STATE, stratify=y
)

print(f"Train: {len(X_train):,} (churn: {y_train.mean():.1%})")
print(f"Test : {len(X_test):,} (churn: {y_test.mean():.1%})")
```
Preprocessing yang sama untuk semua model (kecuali Naive Bayes, yang akan kita tangani terpisah):
```{python}
#| label: preprocessor
numeric_features = X.select_dtypes(include=["int64", "float64"]).columns.tolist()
categorical_features = X.select_dtypes(include=["object"]).columns.tolist()

preprocessor = ColumnTransformer([
    ("num", Pipeline([
        ("imputer", SimpleImputer(strategy="median")),
        ("scaler", StandardScaler()),
    ]), numeric_features),
    ("cat", Pipeline([
        ("imputer", SimpleImputer(strategy="most_frequent")),
        ("onehot", OneHotEncoder(handle_unknown="ignore")),
    ]), categorical_features),
])

# Untuk Naive Bayes: hanya numerik, imputasi + scaling
preprocessor_nb = ColumnTransformer([
    ("num", Pipeline([
        ("imputer", SimpleImputer(strategy="median")),
        ("scaler", StandardScaler()),
    ]), numeric_features),
], remainder="drop")
```
## Enam Model Klasifikasi
Kita akan melatih enam model. Untuk masing-masing, perhatikan **asumsi** dan **karakteristiknya**—bukan hanya kodenya.
### 1. Logistic Regression — Baseline yang Kuat
```{python}
#| label: model-logreg
logreg = Pipeline([
    ("prep", preprocessor),
    ("clf", LogisticRegression(max_iter=1000, random_state=RANDOM_STATE)),
])
logreg.fit(X_train, y_train)
```
**Asumsi**: hubungan linear antara fitur dan log-odds.
**Kelebihan**: interpretabel (odds ratio), cepat, stabil.
**Kekurangan**: tidak menangkap interaksi non-linear secara otomatis.
### 2. K-Nearest Neighbors — Berdasarkan Kemiripan
```{python}
#| label: model-knn
knn = Pipeline([
    ("prep", preprocessor),
    ("clf", KNeighborsClassifier(n_neighbors=15)),
])
knn.fit(X_train, y_train)
```
**Asumsi**: pelanggan dengan profil serupa memiliki perilaku serupa.
**Kelebihan**: sederhana, tidak ada asumsi distribusi, menangkap pola lokal.
**Kekurangan**: **sangat** sensitif terhadap skala (karena itu `StandardScaler` wajib), lambat untuk prediksi pada data besar, tidak interpretabel.
::: {.callout-warning}
**KNN dan standardisasi.** Tanpa `StandardScaler`, fitur dengan skala besar (misalnya `TotalCharges` dalam ribuan) akan mendominasi perhitungan jarak, membuat fitur dengan skala kecil (misalnya `SeniorCitizen` 0/1) tidak berpengaruh. Ini adalah alasan `StandardScaler` **wajib** untuk KNN—bukan opsional.
:::
### 3. Naive Bayes — Probabilitas Sederhana
```{python}
#| label: model-nb
nb = Pipeline([
    ("prep", preprocessor_nb),
    ("clf", GaussianNB()),
])
nb.fit(X_train, y_train)
```
**Asumsi**: fitur **independen** satu sama lain (kondisional terhadap kelas).
**Kelebihan**: sangat cepat, bekerja baik pada data kecil, tidak memerlukan scaling.
**Kekurangan**: asumsi independensi hampir selalu dilanggar di dunia nyata; performa sering kalah dari model lain.
::: {.callout-note}
**Mengapa Naive Bayes tetap layak dipelajari?** Meskipun asumsi independensinya sering dilanggar, Naive Bayes **sering bekerja mengejutkan baik**—terutama untuk klasifikasi teks. Ia juga menjadi **baseline yang sangat cepat**, dan memberikan intuisi tentang bagaimana probabilitas kondisional bekerja. Di bab ini, kita memakainya sebagai pembanding, bukan sebagai kandidat utama.
:::
### 4. Decision Tree — Aturan yang Dapat Dibaca
```{python}
#| label: model-tree
tree = Pipeline([
    ("prep", preprocessor),
    ("clf", DecisionTreeClassifier(max_depth=5, random_state=RANDOM_STATE)),
])
tree.fit(X_train, y_train)
```
**Asumsi**: keputusan dapat direpresentasikan sebagai serangkaian aturan if-then.
**Kelebihan**: **sangat interpretabel** (dapat digambar sebagai pohon), menangkap interaksi non-linear, tidak memerlukan scaling.
**Kekurangan**: cenderung **overfitting** (karena itu `max_depth=5`), tidak stabil (perubahan kecil di data bisa mengubah struktur pohon secara drastis).
### 5. Random Forest — Kekuatan Ensemble
```{python}
#| label: model-rf
rf = Pipeline([
    ("prep", preprocessor),
    ("clf", RandomForestClassifier(
        n_estimators=200, max_depth=10, random_state=RANDOM_STATE, n_jobs=-1
    )),
])
rf.fit(X_train, y_train)
```
**Asumsi**: tidak ada asumsi kuat—ensemble dari banyak pohon yang dilatih pada subset data dan fitur.
**Kelebihan**: performa tinggi, tahan terhadap overfitting, memberikan **feature importance**, menangani interaksi secara otomatis.
**Kekurangan**: kurang interpretabel dari decision tree tunggal, lebih lambat, lebih sulit di-deploy.
### 6. Gradient Boosting — Model Terkuat di Kelas Tabular
```{python}
#| label: model-gb
gb = Pipeline([
    ("prep", preprocessor),
    ("clf", GradientBoostingClassifier(
        n_estimators=200, max_depth=3, learning_rate=0.05,
        random_state=RANDOM_STATE,
    )),
])
gb.fit(X_train, y_train)
```
**Asumsi**: mirip random forest, tetapi pohon dibangun **secara berurutan**—setiap pohon memperbaiki kesalahan pohon sebelumnya.
**Kelebihan**: sering menjadi model **terbaik** untuk data tabular, sangat fleksibel.
**Kekurangan**: lebih mudah overfitting jika hyperparameter tidak di-tuning, lebih lambat dilatih, kurang interpretabel.
::: {.callout-tip}
**Random Forest vs Gradient Boosting.** Random forest membangun pohon **secara paralel** dan merata-ratakan hasilnya—ini mengurangi variance. Gradient boosting membangun pohon **secara berurutan**, masing-masing memperbaiki residual pohon sebelumnya—ini mengurangi bias. Dalam praktik, gradient boosting sering menang tipis pada data tabular, tetapi membutuhkan tuning yang lebih hati-hati.
:::
## Evaluasi: Metrik yang Berbeda Menjawab Pertanyaan yang Berbeda
Sekarang kita memiliki enam model. Bagaimana membandingkannya? Jawabannya bergantung pada **apa yang kita pedulikan**—dan ini adalah pelajaran paling penting di bab ini.
### Confusion Matrix: Fondasi Semua Metrik
```{python}
#| label: confusion-matrices
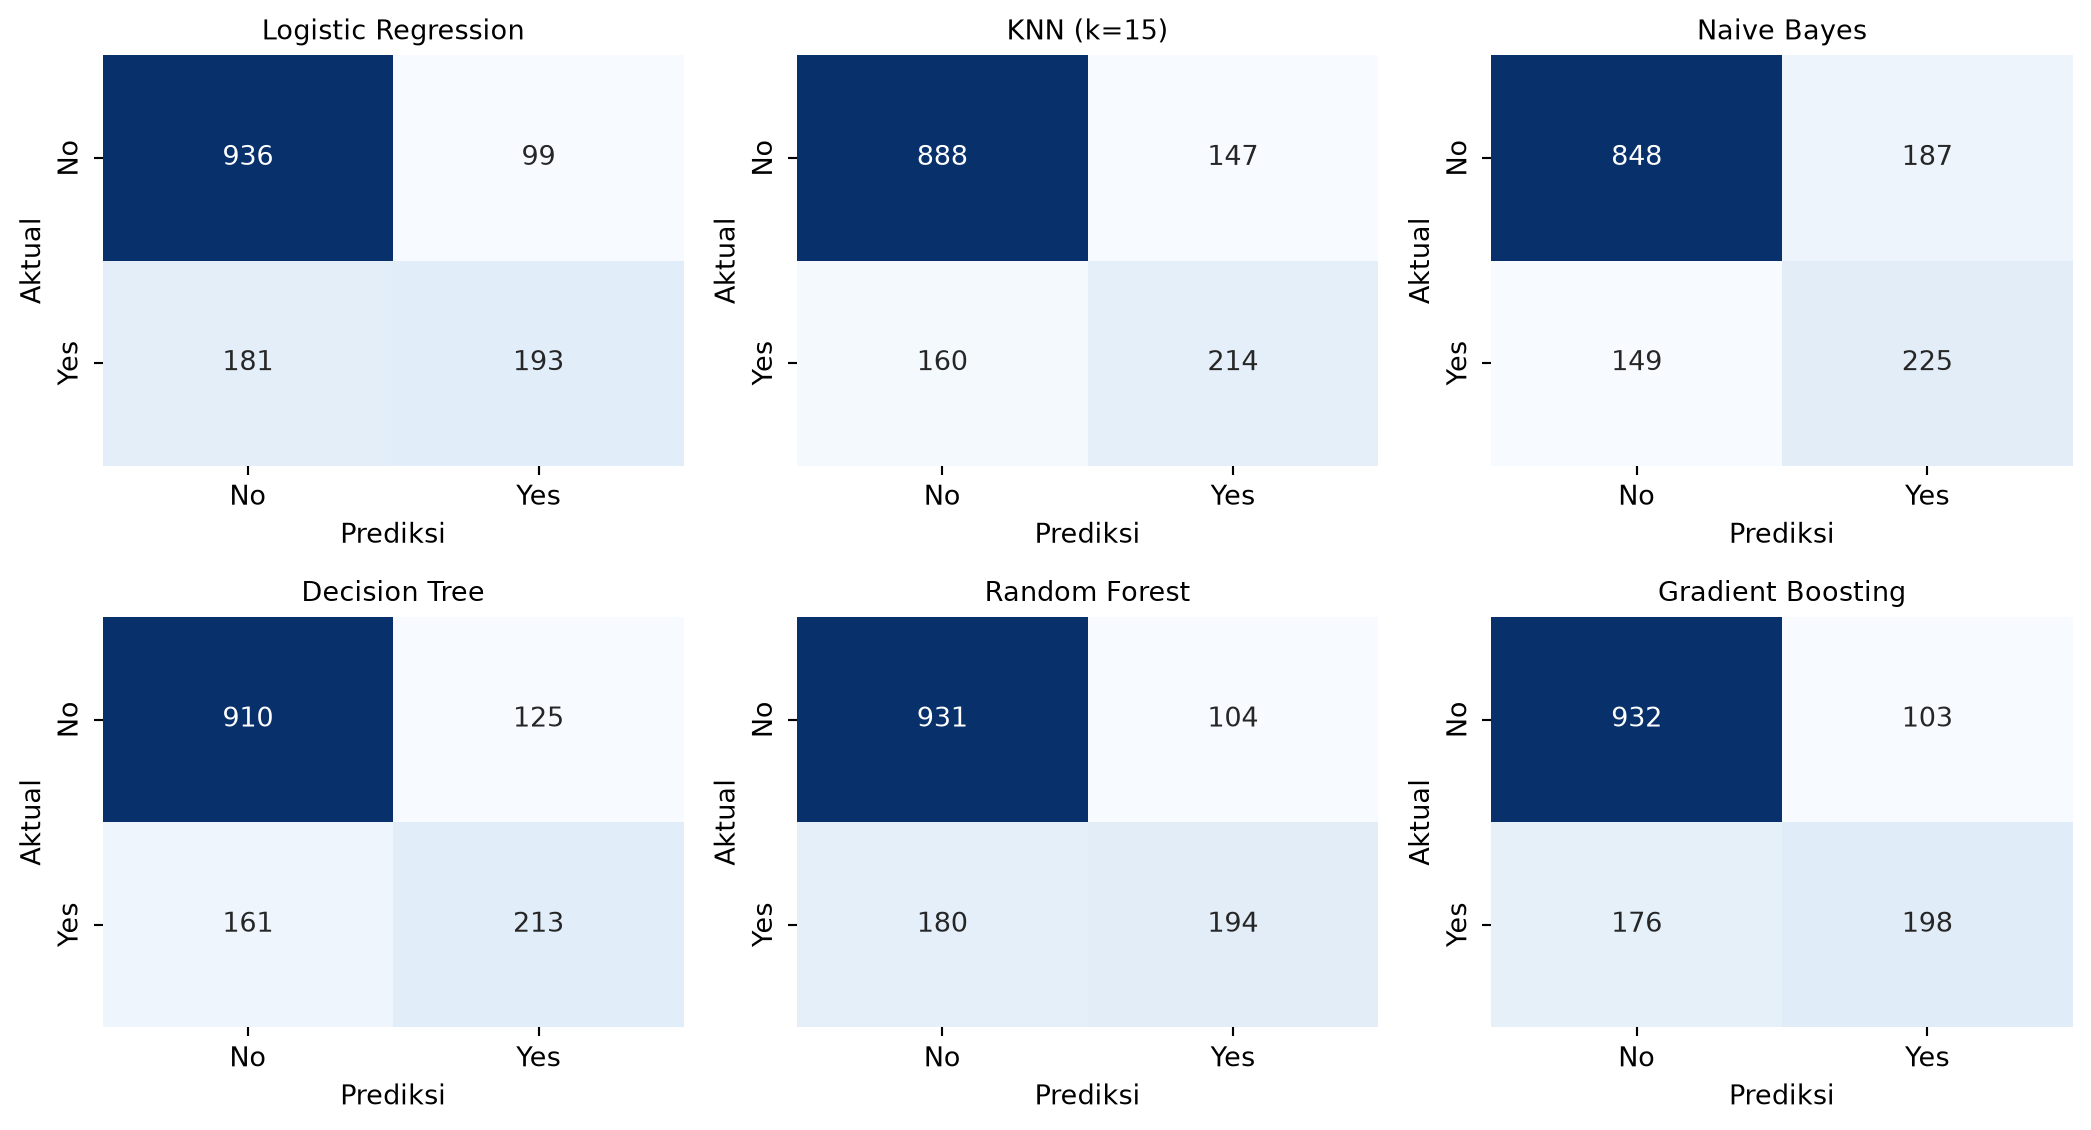
#| fig-cap: "Confusion matrix untuk enam model pada test set. Setiap sel menunjukkan jumlah pelanggan."
#| fig-width: 11
#| fig-height: 6
models = {
    "Logistic Regression": logreg,
    "KNN (k=15)": knn,
    "Naive Bayes": nb,
    "Decision Tree": tree,
    "Random Forest": rf,
    "Gradient Boosting": gb,
}

fig, axes = plt.subplots(2, 3, figsize=(11, 6))
for ax, (name, model) in zip(axes.flat, models.items()):
    y_pred = model.predict(X_test)
    cm = confusion_matrix(y_test, y_pred)
    sns.heatmap(cm, annot=True, fmt="d", cmap="Blues", cbar=False,
                xticklabels=["No", "Yes"], yticklabels=["No", "Yes"], ax=ax)
    ax.set_title(name, fontsize=10)
    ax.set_xlabel("Prediksi")
    ax.set_ylabel("Aktual")
plt.tight_layout()
plt.show()
```
**Cara membaca confusion matrix:**
| | Prediksi: No | Prediksi: Yes |
|---|---|---|
| **Aktual: No** | True Negative (TN) ✅ | False Positive (FP) ❌ |
| **Aktual: Yes** | False Negative (FN) ❌ | True Positive (TP) ✅ |
- **TN**: pelanggan yang tidak churn, diprediksi tidak churn. Benar.
- **FP**: pelanggan yang tidak churn, diprediksi churn. **Kita menghubungi mereka tanpa perlu.**
- **FN**: pelanggan yang churn, diprediksi tidak churn. **Kita melewatkan mereka.**
- **TP**: pelanggan yang churn, diprediksi churn. **Kita berhasil menangkap mereka.**
::: {.callout-important}
**Dalam konteks retensi churn, FN hampir selalu lebih mahal dari FP.** Melewatkan pelanggan yang akan churn berarti kehilangan revenue dan pelanggan. Menghubungi pelanggan yang tidak akan churn hanya menghabiskan waktu tim retensi—mengganggu, tetapi tidak fatal. **Ini akan memengaruhi metrik yang kita pilih.**
:::
### Precision, Recall, F1
Tiga metrik yang diturunkan dari confusion matrix:
| Metrik | Formula | Arti | Kapan dipakai |
|---|---|---|---|
| **Precision** | TP / (TP + FP) | Dari yang diprediksi churn, berapa yang benar-benar churn? | Ketika FP mahal (mis. kampanye mahal per pelanggan) |
| **Recall** | TP / (TP + FN) | Dari yang benar-benar churn, berapa yang berhasil ditangkap? | Ketika FN mahal (mis. retensi murah per pelanggan) |
| **F1** | 2 × (P × R) / (P + R) | Rata-rata harmonik precision dan recall | Ketika kita peduli keduanya |
```{python}
#| label: metrics-table
hasil = []
for name, model in models.items():
    y_pred = model.predict(X_test)
    y_prob = model.predict_proba(X_test)[:, 1]
    hasil.append({
        "Model": name,
        "Accuracy": accuracy_score(y_test, y_pred),
        "Precision": precision_score(y_test, y_pred),
        "Recall": recall_score(y_test, y_pred),
        "F1": f1_score(y_test, y_pred),
        "AUC": roc_auc_score(y_test, y_prob),
        "PR-AUC": average_precision_score(y_test, y_prob),
        "Brier": brier_score_loss(y_test, y_prob),
    })

hasil_df = pd.DataFrame(hasil).set_index("Model").round(3)
hasil_df.style.highlight_max(axis=0, color="lightgreen")
```
**Cara membaca tabel ini:**
- **Accuracy** paling tinggi untuk model yang cenderung memprediksi "No" (karena kelas mayoritas). Ini sebabnya **accuracy menyesatkan** untuk kelas tidak seimbang.
- **Recall** mengukur seberapa banyak churner yang berhasil kita tangkap. Model dengan recall tinggi **cocok untuk sistem retensi** karena kita ingin menangkap sebanyak mungkin pelanggan berisiko.
- **Precision** mengukur seberapa akurat prediksi "churn" kita. Jika kita membatasi anggaran retensi, precision penting—kita tidak ingin menghubungi terlalu banyak pelanggan yang tidak akan churn.
- **AUC** mengukur **ranking**: seberapa baik model mengurutkan pelanggan berisiko tinggi di atas yang berisiko rendah. Ini **tidak bergantung pada threshold**.
- **Brier score** mengukur **kalibrasi**: seberapa dekat probabilitas yang diprediksi dengan frekuensi aktual. Semakin kecil, semakin baik.
### ROC Curve: Trade-off Recall dan False Positive Rate
```{python}
#| label: fig-roc
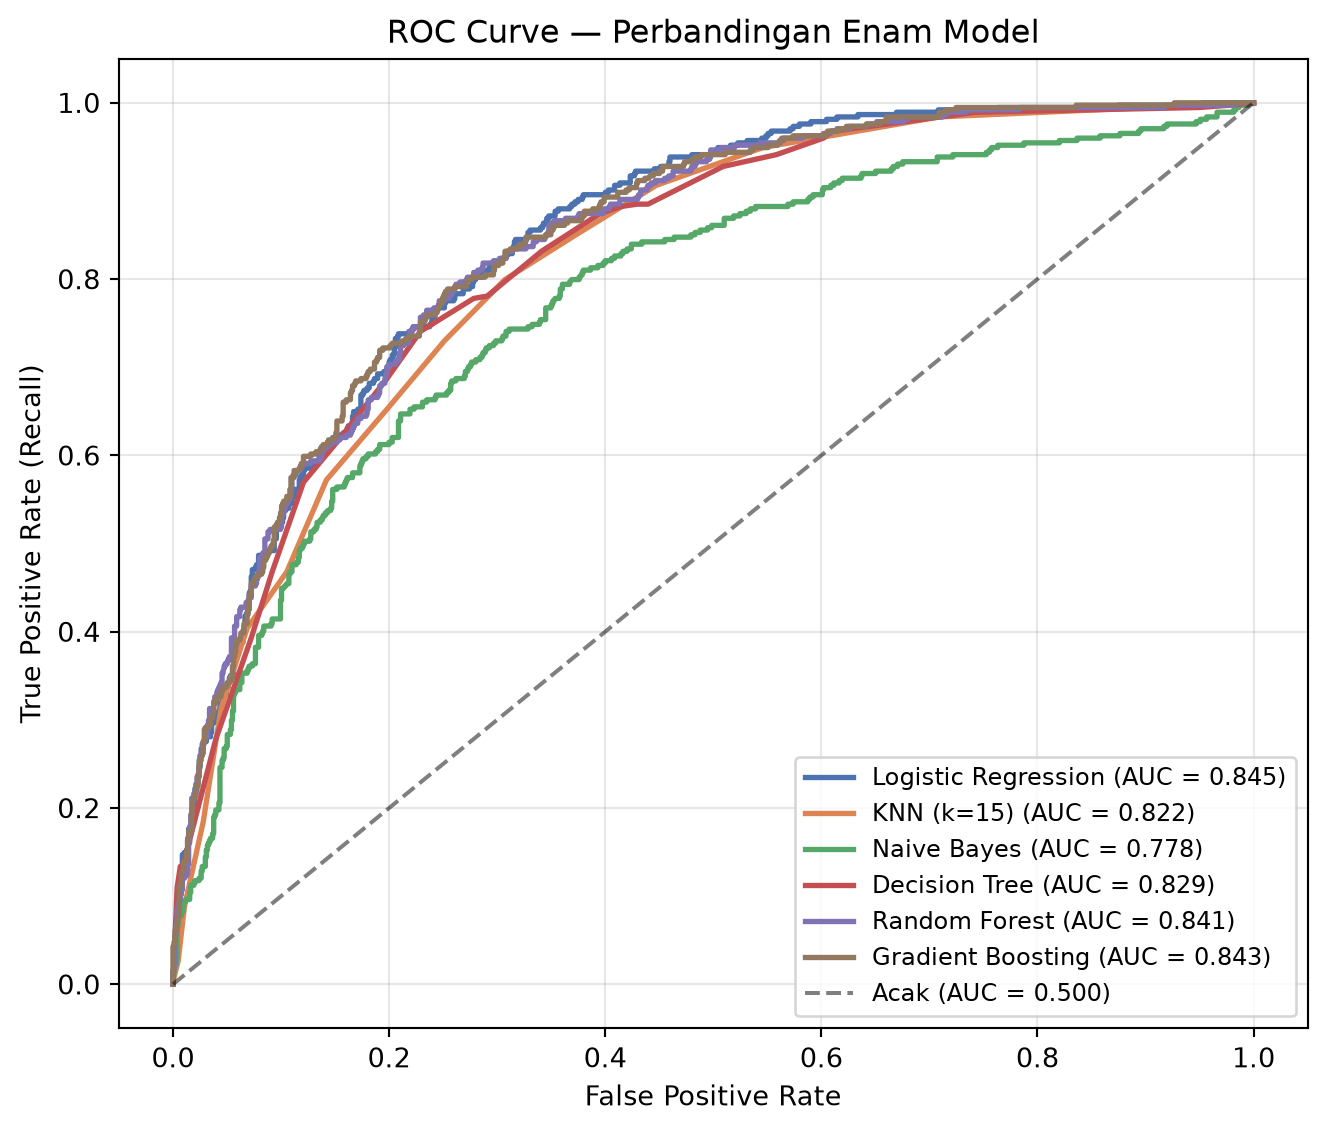
#| fig-cap: "ROC curve untuk enam model. Kurva lebih dekat ke sudut kiri atas = performa lebih baik."
#| fig-width: 7
#| fig-height: 6
fig, ax = plt.subplots(figsize=(7, 6))
colors = ["#4C72B0", "#DD8452", "#55A868", "#C44E52", "#8172B3", "#937860"]

for (name, model), color in zip(models.items(), colors):
    y_prob = model.predict_proba(X_test)[:, 1]
    fpr, tpr, _ = roc_curve(y_test, y_prob)
    auc = roc_auc_score(y_test, y_prob)
    ax.plot(fpr, tpr, label=f"{name} (AUC = {auc:.3f})", color=color, linewidth=2)

ax.plot([0, 1], [0, 1], "k--", label="Acak (AUC = 0.500)", alpha=0.5)
ax.set_xlabel("False Positive Rate")
ax.set_ylabel("True Positive Rate (Recall)")
ax.set_title("ROC Curve — Perbandingan Enam Model")
ax.legend(loc="lower right", fontsize=9)
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
```
**Cara membaca ROC curve:**
- **Sumbu X**: False Positive Rate = FP / (FP + TN) — proporsi pelanggan tidak churn yang salah kita prediksi churn.
- **Sumbu Y**: True Positive Rate = TP / (TP + FN) — proporsi churner yang berhasil kita tangkap (recall).
- Kurva **semakin dekat ke kiri atas** = semakin baik—kita menangkap banyak churner dengan sedikit false positive.
- **AUC** (Area Under Curve) merangkum seluruh kurva dalam satu angka. AUC = 0,5 berarti acak; AUC = 1,0 berarti sempurna.
### Precision-Recall Curve: Lebih Informatif untuk Kelas Tidak Seimbang
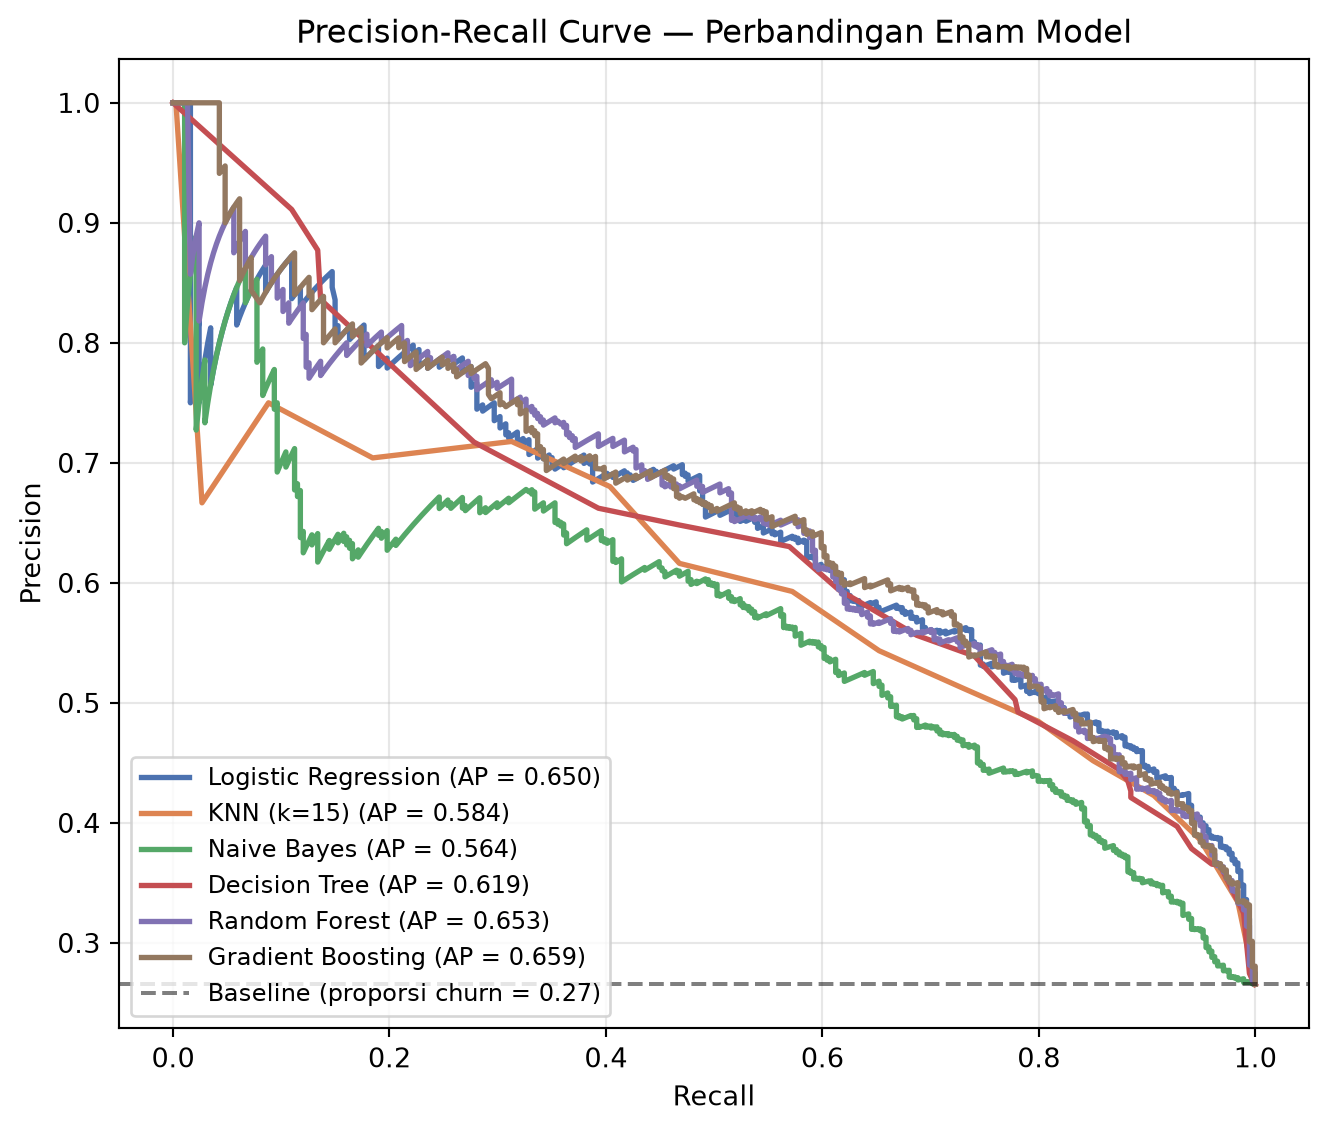
ROC curve memiliki kelemahan pada kelas tidak seimbang: FPR bisa tetap rendah bahkan ketika model buruk, karena TN sangat banyak. **Precision-Recall curve** lebih sensitif terhadap performa pada kelas minoritas.
```{python}
#| label: fig-pr
#| fig-cap: "Precision-Recall curve. Semakin dekat ke kanan atas = semakin baik. Baseline (garis putus-putus) adalah proporsi kelas positif (~26,5%)."
#| fig-width: 7
#| fig-height: 6
fig, ax = plt.subplots(figsize=(7, 6))
baseline = y_test.mean()

for (name, model), color in zip(models.items(), colors):
    y_prob = model.predict_proba(X_test)[:, 1]
    precision, recall, _ = precision_recall_curve(y_test, y_prob)
    ap = average_precision_score(y_test, y_prob)
    ax.plot(recall, precision, label=f"{name} (AP = {ap:.3f})", color=color, linewidth=2)

ax.axhline(baseline, color="black", linestyle="--", alpha=0.5,
           label=f"Baseline (proporsi churn = {baseline:.2f})")
ax.set_xlabel("Recall")
ax.set_ylabel("Precision")
ax.set_title("Precision-Recall Curve — Perbandingan Enam Model")
ax.legend(loc="lower left", fontsize=9)
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
```
**Average Precision (AP)** adalah area di bawah kurva PR—semakin tinggi, semakin baik. AP lebih informatif daripada AUC ketika kelas tidak seimbang, karena ia memberi bobot lebih pada performa di kelas minoritas (churn).
::: {.callout-tip}
**Kapan memakai ROC vs PR?**
- **ROC-AUC** cocok ketika kelas relatif seimbang, atau ketika kita peduli **kedua kelas** secara setara.
- **PR-AUC** cocok ketika kelas **sangat tidak seimbang** (mis. 1:100), atau ketika kita terutama peduli pada **kelas positif** (churner, fraud, penyakit).
Untuk dataset Telco (26,5% churn), keduanya memberi gambaran yang mirip—tetapi PR-AUC lebih jujur tentang tantangan menangkap churner.
:::
## Memilih Metrik Berdasarkan Konsekuensi Bisnis
Sekarang kita sampai pada inti bab ini: **metrik mana yang harus kita optimalkan?**
Jawabannya bergantung pada **cost matrix**—seberapa mahal setiap jenis kesalahan.
### Skenario 1: Program Retensi Murah
Jika intervensi retensi **murah** (mis. email otomatis), kita bisa **menghubungi banyak pelanggan**—bahkan yang tidak akan churn. Dalam skenario ini:
- **FP murah**: menghubungi pelanggan yang tidak akan churn hanya menghabiskan biaya email.
- **FN mahal**: melewatkan churner berarti kehilangan pelanggan.
- **Metrik yang dioptimalkan: RECALL**.
### Skenario 2: Program Retensi Mahal
Jika intervensi retensi **mahal** (mis. kunjungan sales, diskon besar), kita harus **sangat selektif**. Dalam skenario ini:
- **FP mahal**: menghubungi pelanggan yang tidak akan churn membuang anggaran.
- **FN mahal**: tetap kehilangan pelanggan, tetapi trade-off-nya lebih seimbang.
- **Metrik yang dioptimalkan: PRECISION atau F1**.
### Skenario 3: Prioritisasi dengan Anggaran Terbatas
Dalam praktiknya, kita sering berada di antara keduanya—anggaran terbatas, tetapi kita ingin menangkap sebanyak mungkin churner. **Metrik yang dioptimalkan: PR-AUC** (yang memperhitungkan trade-off precision-recall di seluruh threshold).
::: {.callout-important}
**Pelajaran paling penting di bab ini.** Jangan memilih model berdasarkan **accuracy**. Accuracy menyesatkan untuk kelas tidak seimbang. Pilih model berdasarkan **metrik yang mencerminkan konsekuensi bisnis**. Model dengan accuracy 80% tetapi recall 30% mungkin **lebih buruk** dari model dengan accuracy 75% tetapi recall 70%—tergantung pada biaya FP vs FN.
:::
## Class Imbalance: Ketika Kelas Minoritas Terlupakan
Dataset Telco memiliki 26,5% churn—tidak terlalu ekstrem, tetapi cukup untuk membuat model "malas" memprediksi mayoritas. Ada tiga strategi utama:
### 1. `class_weight='balanced'`
Model akan memberi **bobot lebih besar** pada kelas minoritas selama pelatihan. Efeknya: model lebih agresif memprediksi churn.
```{python}
#| label: balanced-weight
logreg_balanced = Pipeline([
    ("prep", preprocessor),
    ("clf", LogisticRegression(max_iter=1000, class_weight="balanced",
                                random_state=RANDOM_STATE)),
])
logreg_balanced.fit(X_train, y_train)

y_pred_bal = logreg_balanced.predict(X_test)
y_prob_bal = logreg_balanced.predict_proba(X_test)[:, 1]

print("--- Logistic Regression (default) ---")
print(f"Precision: {precision_score(y_test, logreg.predict(X_test)):.3f}")
print(f"Recall   : {recall_score(y_test, logreg.predict(X_test)):.3f}")
print(f"AUC      : {roc_auc_score(y_test, logreg.predict_proba(X_test)[:,1]):.3f}")
print()
print("--- Logistic Regression (balanced) ---")
print(f"Precision: {precision_score(y_test, y_pred_bal):.3f}")
print(f"Recall   : {recall_score(y_test, y_pred_bal):.3f}")
print(f"AUC      : {roc_auc_score(y_test, y_prob_bal):.3f}")
```
**Perhatikan pola:** Dengan `balanced`, **recall naik** (lebih banyak churner tertangkap) tetapi **precision turun** (lebih banyak FP). AUC biasanya tetap sama—karena AUC mengukur **ranking**, bukan threshold. `class_weight` hanya **menggeser threshold efektif** dari 0,5 ke titik yang lebih menguntungkan kelas minoritas.
### 2. Threshold Adjustment
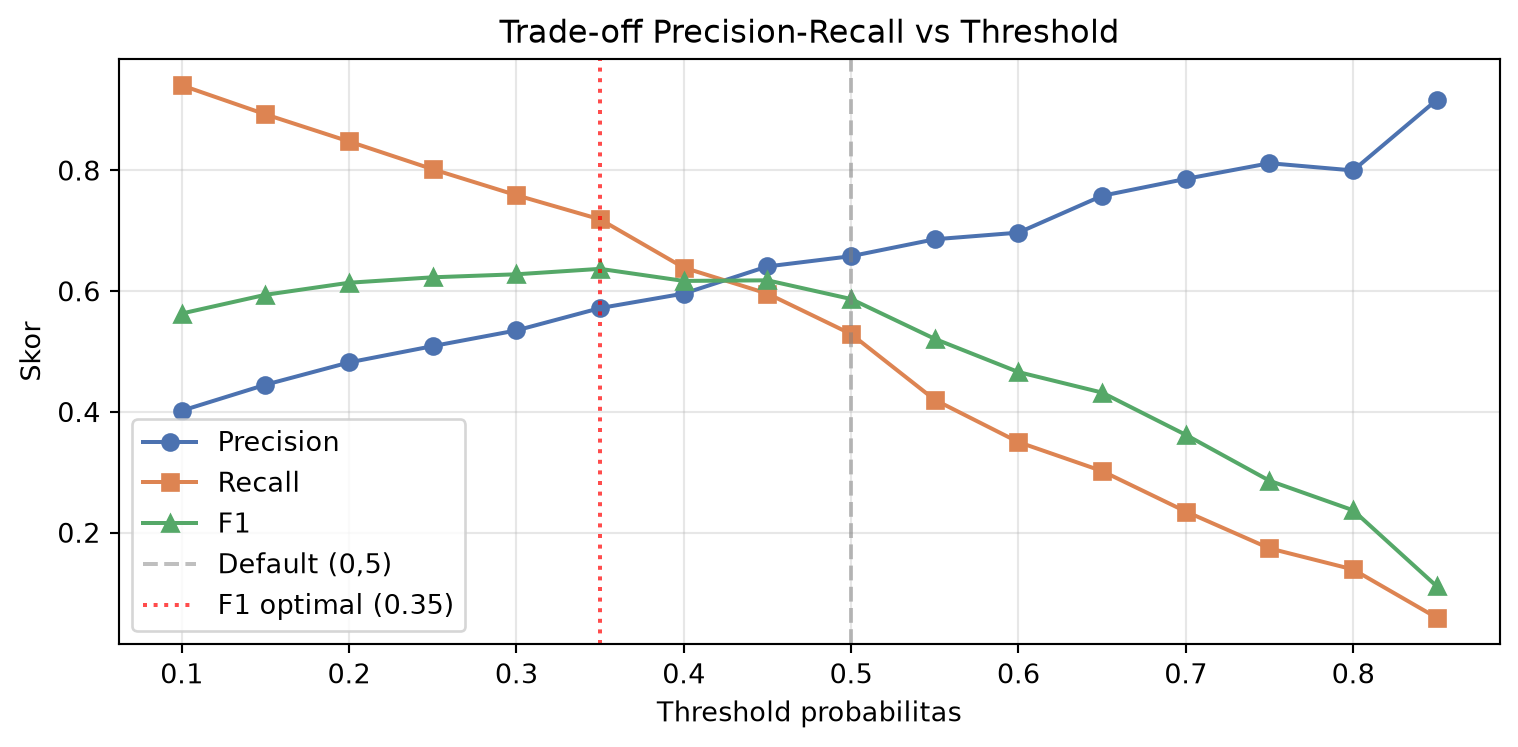
Alih-alih memakai threshold default 0,5, kita bisa memilih threshold yang mengoptimalkan metrik bisnis:
```{python}
#| label: threshold-tuning
thresholds = np.arange(0.1, 0.9, 0.05)
rows = []
for th in thresholds:
    y_pred_th = (y_prob >= th).astype(int)
    rows.append({
        "threshold": round(th, 2),
        "precision": precision_score(y_test, y_pred_th, zero_division=0),
        "recall": recall_score(y_test, y_pred_th),
        "f1": f1_score(y_test, y_pred_th),
    })

th_df = pd.DataFrame(rows).set_index("threshold").round(3)

# Cari threshold dengan F1 tertinggi
best_f1_th = th_df["f1"].idxmax()
print(f"Threshold optimal untuk F1: {best_f1_th}")
th_df.head(10)
```
```{python}
#| label: fig-threshold
#| fig-cap: "Precision, recall, dan F1 sebagai fungsi threshold. Threshold 0,5 bukan selalu optimal untuk bisnis."
#| fig-width: 8
#| fig-height: 4
fig, ax = plt.subplots(figsize=(8, 4))
ax.plot(th_df.index, th_df["precision"], marker="o", label="Precision", color="#4C72B0")
ax.plot(th_df.index, th_df["recall"], marker="s", label="Recall", color="#DD8452")
ax.plot(th_df.index, th_df["f1"], marker="^", label="F1", color="#55A868")
ax.axvline(0.5, color="gray", linestyle="--", alpha=0.5, label="Default (0,5)")
ax.axvline(best_f1_th, color="red", linestyle=":", alpha=0.7,
           label=f"F1 optimal ({best_f1_th})")
ax.set_xlabel("Threshold probabilitas")
ax.set_ylabel("Skor")
ax.set_title("Trade-off Precision-Recall vs Threshold")
ax.legend()
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
```
::: {.callout-tip}
**Threshold adalah keputusan bisnis, bukan keputusan statistik.** Tidak ada "threshold yang benar" secara universal. Threshold yang tepat bergantung pada:
- Berapa banyak pelanggan yang bisa tim retensi hubungi per minggu.
- Berapa biaya per intervensi.
- Berapa nilai revenue yang hilang jika melewatkan churner.
Threshold 0,3 mungkin lebih baik dari 0,5 jika kita ingin menangkap lebih banyak churner dan biaya FP rendah.
:::
### 3. Resampling (SMOTE, Oversampling, Undersampling)
Alternatif lain adalah **mengubah data latih**: menambah sampel kelas minoritas (oversampling/SMOTE) atau mengurangi kelas mayoritas (undersampling).
::: {.callout-note}
**Kapan resampling diperlukan?** Ketika kelas sangat tidak seimbang (mis. 1:100 atau lebih ekstrem). Untuk dataset Telco (1:2,8), `class_weight` dan threshold adjustment biasanya **cukup**—dan lebih sederhana. Resampling menambah kompleksitas dan risiko overfitting pada sampel sintetis.
:::
Kita **tidak** mendemonstrasikan SMOTE di bab ini karena ia membutuhkan library tambahan (`imbalanced-learn`) dan untuk dataset Telco, `class_weight` sudah memadai. Namun, jika kita bekerja dengan data yang sangat tidak seimbang, pertimbangkan:
```python
# pip install imbalanced-learn
from imblearn.over_sampling import SMOTE
from imblearn.pipeline import Pipeline as ImbPipeline
```
## Kalibrasi: Apakah Probabilitas Dapat Dipercaya?
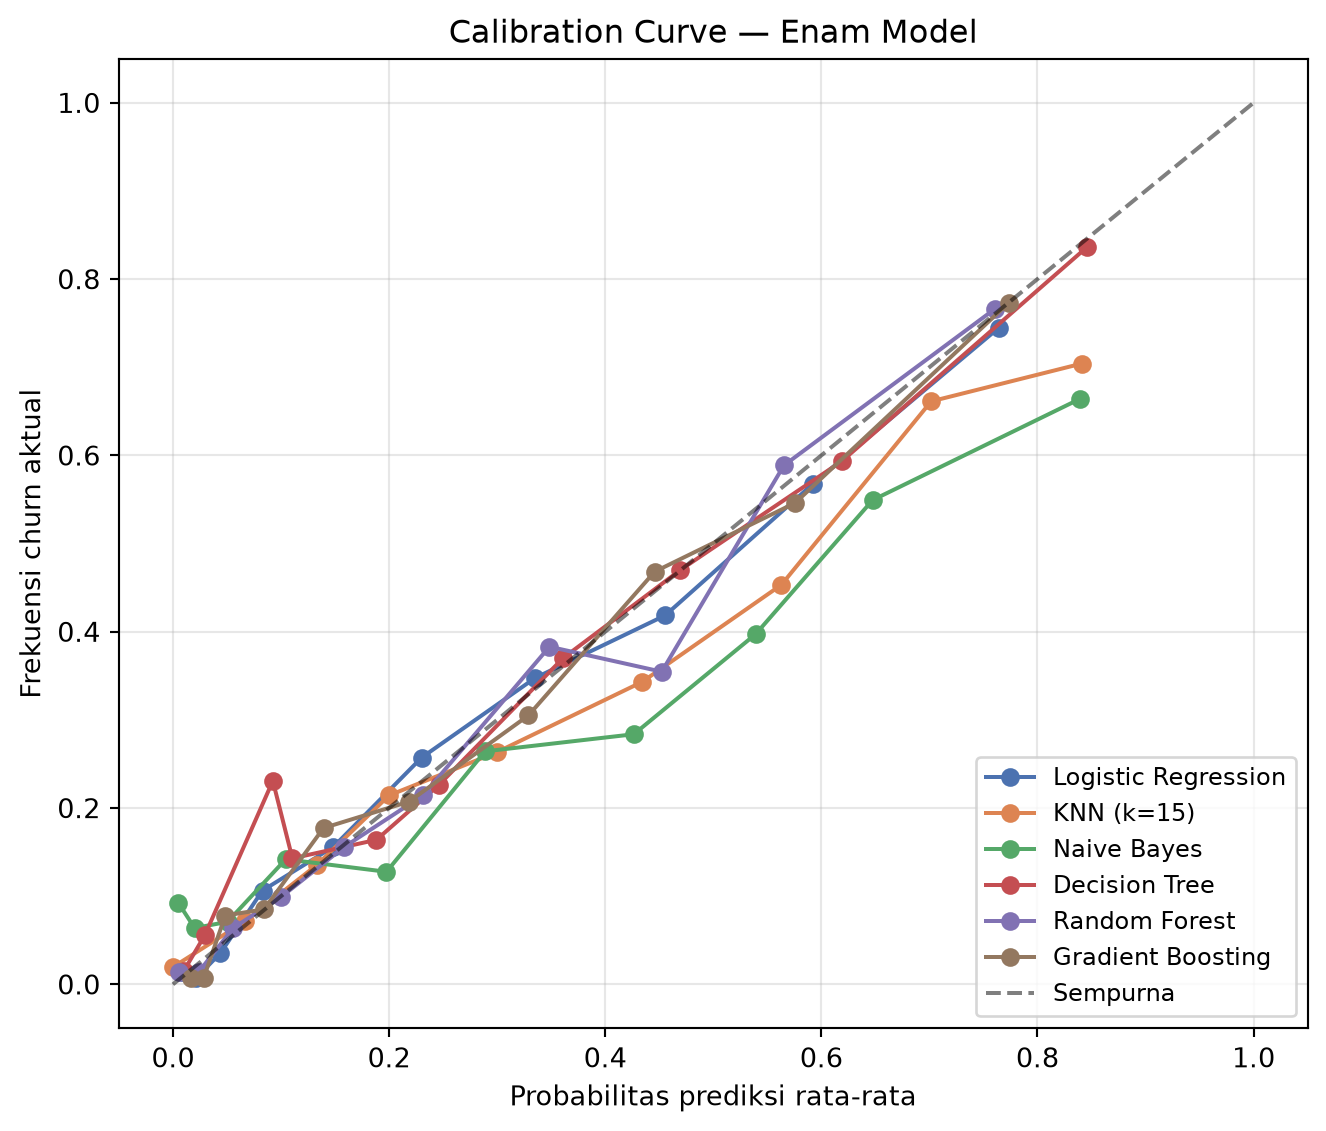
Model yang baik dalam **ranking** (AUC tinggi) belum tentu baik dalam **kalibrasi**—artinya, probabilitas yang dihasilkan mungkin tidak sesuai dengan frekuensi aktual.
Contoh: Jika model memprediksi probabilitas 0,8 untuk 100 pelanggan, apakah ~80 dari mereka benar-benar churn? Jika hanya 60 yang churn, model **tidak terkalibrasi**—probabilitasnya terlalu tinggi.
### Mengukur Kalibrasi
```{python}
#| label: fig-calibration
#| fig-cap: "Calibration curve. Sumbu X = probabilitas prediksi; sumbu Y = frekuensi aktual. Idealnya titik-titik berada di diagonal."
#| fig-width: 7
#| fig-height: 6
fig, ax = plt.subplots(figsize=(7, 6))

for (name, model), color in zip(models.items(), colors):
    y_prob = model.predict_proba(X_test)[:, 1]
    prob_true, prob_pred = calibration_curve(y_test, y_prob, n_bins=10, strategy="quantile")
    ax.plot(prob_pred, prob_true, marker="o", label=name, color=color, linewidth=1.5)

ax.plot([0, 1], [0, 1], "k--", label="Sempurna", alpha=0.5)
ax.set_xlabel("Probabilitas prediksi rata-rata")
ax.set_ylabel("Frekuensi churn aktual")
ax.set_title("Calibration Curve — Enam Model")
ax.legend(loc="lower right", fontsize=9)
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
```
```{python}
#| label: brier-comparison
# Brier score: semakin kecil semakin baik (0 = sempurna, 0.25 = tidak informatif)
brier = pd.DataFrame({
    "Model": list(models.keys()),
    "Brier score": [brier_score_loss(y_test, m.predict_proba(X_test)[:, 1])
                    for m in models.values()],
}).set_index("Model").round(3).sort_values("Brier score")
brier
```
**Cara membaca:**
- **Calibration curve**: Jika model terkalibrasi dengan baik, titik-titik akan mengikuti garis diagonal (probabilitas prediksi = frekuensi aktual). Model yang **di atas diagonal** underestimasi; di **bawah** overestimasi.
- **Brier score**: Menggabungkan kalibrasi dan diskriminasi. Semakin kecil, semakin baik. Brier = 0,25 setara dengan selalu memprediksi 0,5.
::: {.callout-important}
**Mengapa kalibrasi penting untuk keputusan?** Jika kita memakai probabilitas untuk keputusan—misalnya "hubungi pelanggan dengan probabilitas > 0,6"—maka probabilitas itu **harus dapat dipercaya**. Model dengan AUC tinggi tetapi kalibrasi buruk bisa membuat kita menghubungi terlalu banyak atau terlalu sedikit pelanggan.
**Random Forest dan Gradient Boosting sering tidak terkalibrasi**—terutama ketika menggunakan `class_weight` atau data tidak seimbang. Jika probabilitas dibutuhkan untuk keputusan, pertimbangkan **calibration** (`sklearn.calibration.CalibratedClassifierCV`) atau pilih Logistic Regression yang secara alami terkalibrasi.
:::
## Feature Importance: Mengapa Model Memprediksi Apa yang Dia Prediksi
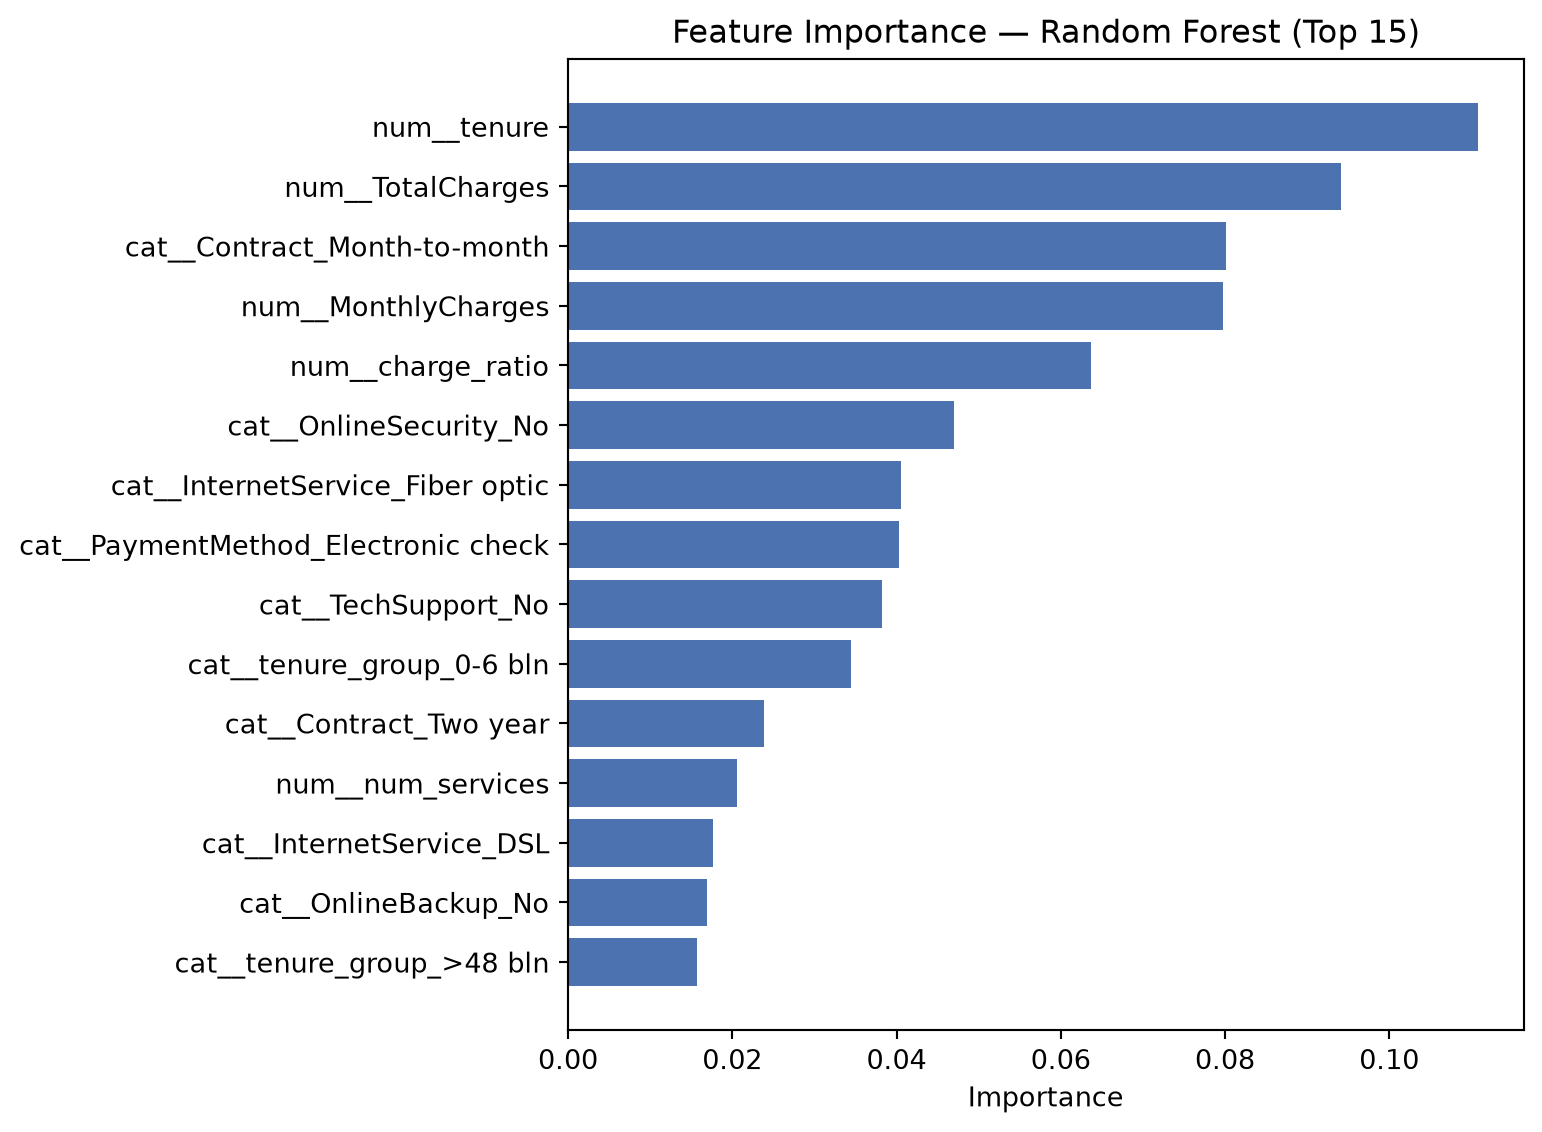
Salah satu keuntungan model tree-based adalah **feature importance**—ia memberi tahu kita fitur mana yang paling berpengaruh.
```{python}
#| label: fig-importance
#| fig-cap: "Feature importance dari Random Forest. Fitur paling penting terkonsentrasi pada tenure, kontrak, dan tagihan."
#| fig-width: 8
#| fig-height: 6
feature_names = rf.named_steps["prep"].get_feature_names_out()
importances = rf.named_steps["clf"].feature_importances_

imp_df = (pd.DataFrame({
    "fitur": feature_names,
    "importance": importances,
}).sort_values("importance", ascending=False).head(15))

fig, ax = plt.subplots(figsize=(8, 6))
ax.barh(imp_df["fitur"][::-1], imp_df["importance"][::-1], color="#4C72B0")
ax.set_xlabel("Importance")
ax.set_title("Feature Importance — Random Forest (Top 15)")
plt.tight_layout()
plt.show()
```
**Cara membaca feature importance:**
- Nilai importance menunjukkan **seberapa besar** fitur berkontribusi pada prediksi—bukan **arah** pengaruhnya.
- Fitur dengan importance tinggi adalah fitur yang sering dipakai untuk **split** di pohon, dan split-nya menghasilkan **pemisahan kelas yang lebih baik**.
- **Konsisten dengan diagnosis Bagian I**: `tenure`, `Contract`, dan `TotalCharges` kemungkinan besar menjadi fitur teratas—mengonfirmasi temuan kita di Bab 3–5.
::: {.callout-warning}
**Feature importance bukan kausalitas.** Fitur dengan importance tinggi **berkorelasi** dengan target, tetapi tidak berarti **menyebabkan** target. `TotalCharges` mungkin penting karena ia berkorelasi dengan `tenure`—bukan karena ia sendiri menyebabkan churn. Jangan menginterpretasikan feature importance sebagai bukti kausal.
:::
## Memilih Model Akhir
Sekarang kita memiliki enam model dengan profil yang berbeda. Bagaimana memilihnya?
### Kerangka Keputusan
| Kriteria | Model Terbaik | Catatan |
|---|---|---|
| **AUC tertinggi** | Gradient Boosting / Random Forest | Performa ranking terbaik |
| **Recall tertinggi** | Gradient Boosting (dengan threshold rendah) | Menangkap paling banyak churner |
| **Kalibrasi terbaik** | Logistic Regression | Probabilitas dapat dipercaya |
| **Interpretabilitas** | Logistic Regression / Decision Tree | Dapat dijelaskan ke stakeholder |
| **Kecepatan training** | Naive Bayes / Logistic Regression | Penting untuk iterasi cepat |
| **Feature importance** | Random Forest / Gradient Boosting | Memberi insight tambahan |
### Rekomendasi untuk Dataset Telco
```{python}
#| label: final-comparison
final = hasil_df[["AUC", "PR-AUC", "Recall", "Precision", "Brier"]].copy()
final["Rekomendasi"] = [
    "✅ Baseline interpretabel; kalibrasi terbaik",
    "Perlu scaling; tidak direkomendasikan",
    "Cepat tetapi lemah; gunakan sebagai baseline",
    "Interpretabel; cenderung overfitting",
    "✅ Keseimbangan performa & interpretabilitas",
    "✅ Performa terbaik; perlu tuning",
]
final
```
**Rekomendasi:**
1. **Untuk produksi retensi**: **Gradient Boosting** dengan threshold yang disesuaikan—memberikan recall tertinggi pada precision yang wajar.
2. **Untuk komunikasi ke stakeholder**: **Logistic Regression**—memberikan odds ratio yang dapat diinterpretasikan dan probabilitas yang terkalibrasi.
3. **Untuk eksplorasi awal**: **Random Forest**—memberikan feature importance dan performa yang baik dengan sedikit tuning.
::: {.callout-important}
**Pilihan model bukan keputusan final—ia adalah iterasi.** Model yang dipilih harus **dipantau** setelah deployment. Jika performa menurun (mis. karena perubahan perilaku pelanggan), model perlu dilatih ulang. Ini akan dibahas di Bab 18.
:::
## Latihan Terbimbing
**Latihan 9.1 — Cost-sensitive evaluation.**
Asumsikan biaya FP = Rp 50.000 (satu panggilan telepon) dan biaya FN = Rp 2.000.000 (kehilangan pelanggan). Hitung total biaya untuk setiap model pada threshold 0,5. Model mana yang memiliki biaya terendah? Apakah ini model yang sama dengan yang memiliki AUC tertinggi?
**Latihan 9.2 — Threshold optimization.**
Untuk model Gradient Boosting, cari threshold yang **meminimalkan total biaya** berdasarkan cost matrix di Latihan 9.1. Bandingkan threshold optimal dengan threshold default 0,5. Berapa penghematan biaya yang dihasilkan?
**Latihan 9.3 — KNN tuning.**
Variasi `n_neighbors` dari 3 hingga 50. Plot AUC vs `n_neighbors`. Pada nilai berapa AUC tertinggi? Mengapa KNN dengan `n_neighbors=1` cenderung overfitting?
**Latihan 9.4 — Decision tree interpretasi.**
Latih decision tree dengan `max_depth=3`. Gambarkan pohonnya menggunakan `sklearn.tree.plot_tree`. Apa aturan pertama yang dipelajari pohon? Apakah aturan itu masuk akal secara bisnis?
**Latihan 9.5 — Kalibrasi model.**
Ambil model Gradient Boosting dan kalibrasi dengan `CalibratedClassifierCV`. Bandingkan Brier score sebelum dan sesudah kalibrasi. Apakah kalibrasi mengubah ranking (AUC) atau hanya probabilitas?
**Latihan 9.6 — Feature importance vs odds ratio.**
Bandingkan feature importance dari Random Forest dengan odds ratio dari Logistic Regression. Apakah fitur teratas sama? Jika tidak, mengapa? Mana yang lebih dapat dipercaya untuk interpretasi?
::: {.callout-note collapse="true"}
**Petunjuk Latihan 9.1.** Total biaya = (FP × 50.000) + (FN × 2.000.000). Hitung dari confusion matrix setiap model. Model dengan **recall tinggi** akan menang karena FN jauh lebih mahal dari FP—tetapi mungkin ada model yang menyeimbangkan keduanya dengan lebih baik. Ini adalah latihan penting untuk memahami bahwa **metrik harus mencerminkan biaya bisnis**.
:::
## Kotak "Jembatan": Dari Prediksi ke Keputusan
::: {.callout-important}
**Jembatan.** Bab ini memberi kita **model yang dapat memprediksi probabilitas churn per pelanggan**. Ini adalah kemajuan besar dari Bagian I—kita sekarang dapat menjawab pertanyaan yang tidak bisa dijawab oleh statistik deskriptif:
> *"Pelanggan mana yang paling mungkin churn bulan ini?"*
Tetapi prediksi saja **belum cukup** untuk keputusan. Tiga pertanyaan baru muncul:
1. **Siapa yang harus diintervensi?** Tidak semua pelanggan berisiko tinggi layak diintervensi—beberapa mungkin tidak merespons, atau biaya intervensi melebihi nilai yang diselamatkan.
2. **Intervensi apa yang harus diberikan?** Model prediktif memberi tahu kita **siapa**, tetapi tidak **apa**. Kita perlu memahami **efek** dari berbagai intervensi terhadap probabilitas churn.
3. **Bagaimana mengalokasikan anggaran terbatas?** Bahkan dengan daftar pelanggan berisiko, kita tetap perlu memilih subset yang akan diintervensi berdasarkan **anggaran** dan **efektivitas**.
**Ketiga pertanyaan ini adalah domain prescriptive analytics**—dan inilah tujuan Bagian III. Model prediktif dari bab ini akan menjadi **input**: probabilitas churn per pelanggan akan menjadi parameter dalam model optimasi.
Dengan kata lain: **kita telah membangun mesin prediksi; sekarang kita akan membangun mesin keputusan.**
:::
## Rangkuman
Dalam bab ini kita telah:
- **Membangun enam model klasifikasi** dengan karakteristik berbeda: Logistic Regression (interpretabel), KNN (berbasis kemiripan), Naive Bayes (probabilistik), Decision Tree (berbasis aturan), Random Forest (ensemble paralel), dan Gradient Boosting (ensemble sekuensial).
- **Membaca confusion matrix** dan memahami bahwa setiap sel memiliki konsekuensi bisnis yang berbeda—terutama trade-off antara False Positive dan False Negative.
- **Menguasai metrik evaluasi**—accuracy, precision, recall, F1, ROC-AUC, PR-AUC, Brier score—dan memahami **kapan masing-masing tepat digunakan**.
- **Menyadari bahwa accuracy menyesatkan** untuk kelas tidak seimbang, dan bahwa pemilihan metrik harus **mencerminkan konsekuensi bisnis**.
- **Menangani kelas tidak seimbang** dengan `class_weight` dan threshold adjustment, memahami bahwa keduanya menggeser threshold efektif tanpa mengubah ranking (AUC).
- **Membedakan ranking (AUC) dari kalibrasi (Brier)**, dan memahami bahwa model dengan AUC tinggi belum tentu terkalibrasi.
- **Menginterpretasikan feature importance** dari Random Forest dan menghubungkannya kembali ke diagnosis Bagian I.
- **Memilih model akhir** berdasarkan kerangka keputusan yang mempertimbangkan performa, interpretabilitas, dan konteks bisnis.
## Jembatan ke Bab 10
Sampai di sini, semua model kita bekerja pada data **cross-sectional**—satu baris per pelanggan, tanpa dimensi waktu. Tetapi banyak keputusan analytics membutuhkan **waktu**:
- Berapa permintaan produk bulan depan?
- Kapan pelanggan akan churn?
- Bagaimana pola musiman penjualan?
Bab 10—**Time Series**—akan memperkenalkan teknik untuk data yang **berurutan dalam waktu**. Kita akan beralih ke **dataset pendamping retail** yang memiliki data harian selama dua tahun—dan mempelajari:
- Dekomposisi time series (tren, musiman, residual).
- Metode forecasting klasik (exponential smoothing, ARIMA).
- Validasi *rolling-origin* untuk data waktu.
- Analisis survival sebagai jembatan untuk memahami **kapan** pelanggan churn, bukan hanya **apakah**.
Bab 10 akan menjadi **jembatan** antara prediksi cross-sectional (Bab 7–9) dan simulasi keputusan (Bab 12).