---
jupyter: decanal
---
# Kerangka Predictive Analytics {#sec-kerangka-prediktif}
::: {.callout-note appearance="simple"}
**Tujuan pembelajaran.** Setelah menyelesaikan bab ini, kita akan mampu:
1. Membedakan pertanyaan prediktif dari pertanyaan deskriptif dan merumuskannya secara operasional.
2. Menjelaskan alur kerja pemodelan prediktif—dari formulasi masalah hingga evaluasi.
3. Membagi data menjadi *train*, *validation*, dan *test* dengan benar, serta memahami **mengapa** tiga pembagian diperlukan.
4. Menerapkan *cross-validation* untuk estimasi performa yang lebih stabil.
5. Menjelaskan **bias-variance tradeoff** dan mengenali tanda-tanda *overfitting* maupun *underfitting*.
6. Mengenali dan menghindari *data leakage*—kesalahan paling berbahaya dalam pemodelan prediktif.
7. Membangun *baseline model* sederhana yang menjadi pembanding untuk semua model di bab-bab selanjutnya.
:::
## Dari "Mengapa" ke "Siapa"
Di akhir Bagian I, kita berhenti pada sebuah batas yang jelas. Diagnosis kita mengatakan: *"Pelanggan bulanan baru berisiko tinggi."* Itu adalah kesimpulan tingkat **populasi**—benar untuk kelompok, tetapi tidak cukup untuk tindakan.
VP Customer Success tidak bisa menghubungi "segmen pelanggan bulanan baru". Ia harus menghubungi **individu**—dan ia tidak punya anggaran untuk menghubungi semuanya. Ia membutuhkan jawaban atas pertanyaan yang berbeda:
> *"Dari 1.800 pelanggan di segmen itu, mana 200 yang paling mungkin churn bulan ini?"*
Perhatikan pergeseran pertanyaannya:
| Bagian I | Bagian II |
|---|---|
| "Segmen mana yang berisiko?" | "Pelanggan mana yang akan churn?" |
| Tingkat populasi | Tingkat individu |
| Rata-rata kelompok | Probabilitas per pelanggan |
| Deskriptif/diagnostik | Prediktif |
Inilah wilayah **predictive analytics**: menggunakan pola yang telah kita identifikasi pada data historis untuk memperkirakan **hasil di masa depan** untuk **individu tertentu**.
::: {.callout-important}
**Prediksi bukan ramalan.** Model prediktif tidak "melihat masa depan". Ia menemukan pola dalam data historis dan mengasumsikan bahwa pola itu **bertahan**. Jika dunia berubah secara fundamental—kompetitor baru, resesi, perubahan regulasi—prediksi bisa gagal. Karena itu, model prediktif selalu merupakan **kondisional**: prediksi valid **jika** kondisi yang melatihnya masih berlaku.
:::
## Formulasi Masalah: Sebelum Menyentuh Kode
Kesalahan paling umum dalam pemodelan prediktif bukanlah algoritma yang salah, melainkan **masalah yang salah dirumuskan**. Sebelum membuka notebook, jawab lima pertanyaan berikut secara eksplisit.
### 1. Apa yang Diprediksi? (Target)
Untuk kasus kita, targetnya jelas: `Churn` (biner: `Yes`/`No`). Tetapi ini adalah pilihan yang perlu dijelaskan—mengapa biner, bukan kontinu?
| Jenis target | Contoh | Algoritma yang sesuai |
|---|---|---|
| **Biner** | Churn / tidak churn | Klasifikasi: logistic regression, random forest, gradient boosting |
| **Multikelas** | Jenis kontrak yang akan dipilih | Klasifikasi multikelas |
| **Kontinu** | Nilai tagihan bulanan berikutnya | Regresi: linear regression, gradient boosting regressor |
| **Hitungan** | Jumlah bulan sebelum churn | Regresi Poisson, survival analysis |
| **Waktu** | Kapan pelanggan akan churn | Survival analysis (Bab 10) |
Target biner memungkinkan kita membangun model **klasifikasi**—fokus Bab 9. Tetapi penting dicatat: **target biner menyederhanakan realitas**. Pelanggan tidak "churn" pada satu titik; mereka melalui proses. Bab 10 akan memperkenalkan pendekatan yang lebih kaya (survival analysis) sebagai pelengkap.
### 2. Untuk Siapa Prediksi Ini? (Audiens)
Prediksi untuk **tim retensi** berbeda dari prediksi untuk **direksi**:
| Audiens | Butuh apa | Bentuk keluaran |
|---|---|---|
| Tim retensi operasional | Daftar pelanggan untuk dihubungi minggu ini | Skor probabilitas + ranking |
| Manajer retensi | Segmentasi risiko untuk alokasi anggaran | Distribusi skor, segmen risiko |
| Direksi | Dampak finansial dan tren | Agregat, forecast, confidence interval |
Buku ini fokus pada keluaran **skor probabilitas per pelanggan**—yang dapat diturunkan menjadi ketiganya.
### 3. Kapan Prediksi Dibutuhkan? (Waktu)
Prediksi churn untuk **bulan depan** berbeda dari prediksi untuk **tahun depan**:
- **Horizon pendek** (1 bulan): Model dapat menggunakan fitur yang lebih spesifik dan terbaru (mis. jumlah keluhan terakhir).
- **Horizon panjang** (12 bulan): Model harus lebih umum; banyak fitur spesifik menjadi noise.
Model prediksi churn biasanya memiliki horizon 30–90 hari—cukup lama untuk intervensi, cukup pendek agar prediksi tetap relevan.
### 4. Apa Konsekuensi Kesalahan? (Cost Matrix)
Setiap model membuat dua jenis kesalahan:
| | Aktual: Churn | Aktual: Tidak Churn |
|---|---|---|
| **Prediksi: Churn** | True Positive (TP) ✅ | False Positive (FP) ❌ |
| **Prediksi: Tidak Churn** | False Negative (FN) ❌ | True Negative (TN) ✅ |
- **False Positive**: kita menghubungi pelanggan yang tidak akan churn. Biaya: waktu tim retensi, potensi mengganggu pelanggan.
- **False Negative**: kita melewatkan pelanggan yang akan churn. Biaya: kehilangan revenue, kehilangan pelanggan.
Dalam bisnis nyata, **FN biasanya jauh lebih mahal** dari FP—kehilangan pelanggan seharga LTV jauh lebih besar dari biaya satu panggilan telepon. Ini akan memengaruhi **metrik** yang kita optimalkan (Bab 9) dan **threshold** yang kita pilih untuk keputusan.
### 5. Apa Baseline yang Harus Dikalahkan? (Baseline)
Sebelum membangun model apa pun, kita perlu **baseline**—prediksi paling sederhana yang menjadi pembanding:
- **Baseline trivial**: prediksi semua pelanggan sebagai "tidak churn". Akurasi ~73,5% (karena 73,5% pelanggan tidak churn), tetapi **tidak berguna**—kita tidak menangkap satu pun pelanggan yang churn.
- **Baseline naif**: prediksi "churn" jika `Contract == "Month-to-month"`. Churn rate prediksi ~43%, akurasi tidak sebaik baseline trivial, tetapi **jauh lebih berguna** untuk retensi.
Model yang baik harus **secara signifikan mengalahkan baseline naif** dalam metrik yang relevan—bukan hanya dalam akurasi.
::: {.callout-tip}
**Aturan penting.** Sebelum membangun model apa pun, tuliskan **baseline** yang akan kita kalahkan. Ini mencegah kita membangun model canggih yang sebenarnya lebih buruk dari aturan sederhana. Banyak proyek gagal karena tidak pernah menetapkan baseline.
:::
## Alur Kerja Pemodelan Prediktif
Proses pemodelan prediktif bukan satu langkah, melainkan **siklus iteratif** yang dikenal sebagai **CRISP-DM** (*Cross-Industry Standard Process for Data Mining*):
```{mermaid}
flowchart LR
    A[1. Business<br/>Understanding] --> B[2. Data<br/>Understanding]
    B --> C[3. Data<br/>Preparation]
    C --> D[4. Modeling]
    D --> E[5. Evaluation]
    E --> F[6. Deployment]
    E -.->|Tidak memuaskan| C
    E -.->|Data kurang| B
    F -.->|Monitor & iterasi| A
```
Kita telah menyelesaikan tahap 1–3 di Bagian I (business understanding melalui SCQA, data understanding & preparation melalui Bab 1–2). Bab 7–9 akan fokus pada **tahap 4–5** (modeling dan evaluation); tahap 6 (deployment) akan disinggung di Bab 18.
## Membagi Data: Train, Validation, Test
Ini adalah **keputusan paling penting** dalam pemodelan—dan salah satu yang paling sering salah dilakukan.
### Mengapa Kita Tidak Bisa Mengukur Performa pada Data Latih?
Jika kita melatih model pada seluruh dataset dan mengukur performanya pada dataset yang sama, kita akan mendapat gambaran yang terlalu optimis. Model **menghafal** data latih—termasuk noise dan outlier—sehingga performanya pada data latih bisa jauh lebih baik daripada performa pada data baru.
Analoginya: seorang siswa yang belajar dengan menghafal seluruh jawaban soal tahun lalu akan tampak jenius ketika diuji dengan soal yang sama, tetapi mungkin gagal ketika diuji dengan soal baru. **Kita ingin model yang belajar *pola*, bukan *menghafal data*.**
### Mengapa Tiga Pembagian, Bukan Dua?
Pembagian umum adalah **train (60–80%)**, **validation (10–20%)**, **test (10–20%)**. Masing-masing memiliki peran yang berbeda:
| Set | Fungsi | Kapan dipakai |
|---|---|---|
| **Train** | Melatih model | Selama proses modeling |
| **Validation** | Memilih model & hyperparameter | Selama proses modeling |
| **Test** | Estimasi performa final | **Hanya sekali**, di akhir |
Kesalahan klasik: menggunakan test set untuk "mencoba beberapa model dan memilih yang terbaik". Jika kita melakukannya, test set bukan lagi test set—ia menjadi validation set kedua, dan estimasi performa kita menjadi bias optimis.
::: {.callout-warning}
**Aturan emas test set.** Test set hanya boleh disentuh **satu kali**, di akhir, untuk mengukur performa final. Jika kita melihat hasil test set dan kembali mengubah model, kita telah melakukan *test set leakage*—estimasi performa kita tidak akan bertahan ketika model digunakan di dunia nyata.
:::
### Menerapkan Pembagian Data
```{python}
#| label: setup-split
import sys
sys.path.insert(0, ".")
import pandas as pd
import numpy as np

from decanal.utils import load_churn_clean

df = load_churn_clean()

# Konvensi buku ini: random_state=42 di mana-mana
RANDOM_STATE = 42
TARGET = "Churn"

# Pisahkan fitur (X) dan target (y)
X = df.drop(columns=[TARGET])
y = df[TARGET]

print(f"Fitur : {X.shape[1]} kolom")
print(f"Target: {y.name} (distribusi: {dict(y.value_counts())})")
```
```{python}
#| label: three-way-split
from sklearn.model_selection import train_test_split

# Langkah 1: pisahkan test set (20%)
X_temp, X_test, y_temp, y_test = train_test_split(
    X, y,
    test_size=0.20,
    random_state=RANDOM_STATE,
    stratify=y,     # ← penting! lihat catatan di bawah
)

# Langkah 2: dari sisa 80%, pisahkan validation set (25% dari 80% = 20% dari total)
X_train, X_val, y_train, y_val = train_test_split(
    X_temp, y_temp,
    test_size=0.25,
    random_state=RANDOM_STATE,
    stratify=y_temp,
)

print(f"Train set     : {len(X_train):,} ({len(X_train)/len(X):.0%})")
print(f"Validation set: {len(X_val):,} ({len(X_val)/len(X):.0%})")
print(f"Test set      : {len(X_test):,} ({len(X_test)/len(X):.0%})")
```
::: {.callout-important}
**Parameter `stratify=y`.** Tanpa stratifikasi, pembagian acak bisa menghasilkan distribusi kelas yang tidak seimbang antara train dan test—misalnya, train memiliki 25% churn tetapi test memiliki 30%. Dengan `stratify=y`, proporsi kelas dipertahankan di semua subset. Ini **wajib** untuk dataset dengan kelas tidak seimbang seperti Telco (26,5% churn).
:::
### Verifikasi: Apakah Distribusi Konsisten?
```{python}
#| label: verify-split
def churn_rate(s: pd.Series) -> str:
    return f"{(s == 'Yes').mean() * 100:.1f}%"

pd.DataFrame({
    "set": ["train", "validation", "test"],
    "n": [len(y_train), len(y_val), len(y_test)],
    "churn_rate": [churn_rate(y_train), churn_rate(y_val), churn_rate(y_test)],
})
```
Jika churn rate di ketiga set kira-kira sama (~26,5%), pembagian berhasil. Jika tidak, ada masalah dengan stratifikasi.
## Cross-Validation: Estimasi yang Lebih Stabil
Pembagian train/validation tunggal memiliki kelemahan: hasilnya bergantung pada **pembagian acak tertentu**. Jika kita mengulang dengan `random_state` berbeda, hasilnya bisa berubah beberapa persen—terutama jika dataset kecil.
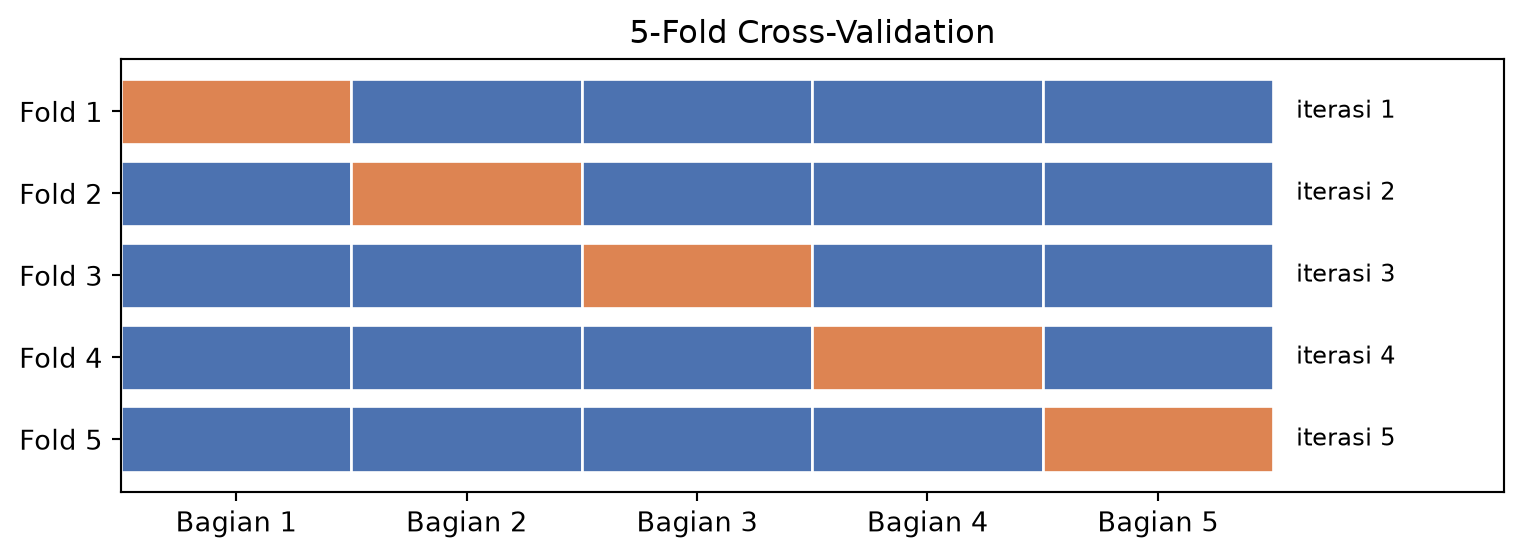
**K-fold cross-validation** mengatasi ini dengan membagi data latih menjadi K bagian, melatih model K kali (masing-masing menggunakan K-1 bagian sebagai training dan 1 bagian sebagai validation), lalu merata-ratakan hasilnya.
```{python}
#| label: cv-visual
#| fig-cap: "Ilustrasi 5-fold cross-validation: model dilatih 5 kali, setiap kali dengan subset validasi yang berbeda."
#| fig-width: 8
#| fig-height: 3
import matplotlib.pyplot as plt

fig, ax = plt.subplots(figsize=(8, 3))
for fold in range(5):
    for i in range(5):
        color = "#DD8452" if i == fold else "#4C72B0"
        ax.barh(fold, 1, left=i, color=color, edgecolor="white")
    ax.text(5.1, fold, f"iterasi {fold+1}", va="center", fontsize=9)

ax.set_yticks(range(5))
ax.set_yticklabels([f"Fold {i+1}" for i in range(5)])
ax.set_xticks(np.arange(0.5, 5.5, 1))
ax.set_xticklabels([f"Bagian {i+1}" for i in range(5)])
ax.set_xlim(0, 6)
ax.set_title("5-Fold Cross-Validation")
ax.invert_yaxis()
plt.tight_layout()
plt.show()
```
Oranye = validation pada iterasi tersebut. Biru = training. Model dilatih 5 kali, setiap kali subset validasi berbeda. Rata-rata performa dari 5 iterasi lebih stabil daripada satu pembagian tunggal.
```{python}
#| label: cv-example
from sklearn.model_selection import cross_val_score, StratifiedKFold
from sklearn.linear_model import LogisticRegression
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler, OneHotEncoder
from sklearn.compose import ColumnTransformer
from sklearn.impute import SimpleImputer

# Siapkan preprocessing dasar
numeric_features = X.select_dtypes(include=["int64", "float64"]).columns.tolist()
categorical_features = X.select_dtypes(include=["object"]).columns.tolist()

preprocessor = ColumnTransformer([
    ("num", Pipeline([
        ("imputer", SimpleImputer(strategy="median")),
        ("scaler", StandardScaler()),
    ]), numeric_features),
    ("cat", Pipeline([
        ("imputer", SimpleImputer(strategy="most_frequent")),
        ("onehot", OneHotEncoder(handle_unknown="ignore")),
    ]), categorical_features),
])

# Pipeline: preprocessing + model
baseline_pipeline = Pipeline([
    ("prep", preprocessor),
    ("clf", LogisticRegression(max_iter=1000, random_state=RANDOM_STATE)),
])

# 5-fold CV pada train set
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=RANDOM_STATE)
scores = cross_val_score(baseline_pipeline, X_train, y_train,
                          cv=cv, scoring="roc_auc")

print(f"ROC-AUC per fold: {[f'{s:.3f}' for s in scores]}")
print(f"Rata-rata       : {scores.mean():.3f} ± {scores.std():.3f}")
```
::: {.callout-tip}
**Mengapa ROC-AUC dan bukan akurasi?** Karena kelas kita tidak seimbang (26,5% churn). Model yang selalu memprediksi "tidak churn" mendapat akurasi 73,5% tetapi ROC-AUC 0,5 (setara tebakan acak). ROC-AUC mengukur **kemampuan membedakan** antara kelas positif dan negatif—jauh lebih informatif untuk keputusan. Detail metrik akan dibahas di Bab 9.
:::
## Bias-Variance Tradeoff: Inti dari Semua Pemodelan
**Bias-variance tradeoff** adalah konsep paling fundamental dalam machine learning—dan salah satu yang paling sering disalahpahami. Ia menjelaskan **mengapa** model bisa gagal dengan dua cara yang berbeda.
### Dua Jenis Kesalahan
Bayangkan kita membangun model untuk memprediksi churn. Kesalahan model dapat diuraikan menjadi tiga komponen:
$$\text{Total Error} = \text{Bias}^2 + \text{Variance} + \text{Irreducible Error}$$
| Komponen | Arti | Penyebab |
|---|---|---|
| **Bias** | Seberapa jauh prediksi rata-rata model dari nilai sebenarnya | Model terlalu sederhana—tidak cukup fleksibel menangkap pola |
| **Variance** | Seberapa banyak prediksi model berubah jika data latih berubah | Model terlalu kompleks—menghafal noise dalam data latih |
| **Irreducible Error** | Noise yang tidak bisa dihilangkan | Batas fundamental dari data—tidak bisa dikurangi oleh model apa pun |
### Underfitting vs Overfitting
| | Underfitting | Overfitting |
|---|---|---|
| **Bias** | Tinggi | Rendah |
| **Variance** | Rendah | Tinggi |
| **Performa train** | Buruk | Sangat baik |
| **Performa test** | Buruk | Buruk |
| **Penyebab** | Model terlalu sederhana | Model terlalu kompleks |
| **Solusi** | Model lebih kompleks, fitur lebih banyak | Regularisasi, lebih banyak data, model lebih sederhana |
**Analogi.** Seorang siswa yang hanya membaca satu halaman buku akan gagal ujian karena **tidak cukup belajar** (underfitting). Seorang siswa yang menghafal seluruh buku tetapi tidak memahami konsep akan gagal ujian dengan soal baru karena **terlalu menghafal** (overfitting). Yang kita inginkan adalah siswa yang memahami pola—cukup belajar untuk menangkap konsep, tetapi tidak terlalu terikat pada detail spesifik.
### Demonstrasi: Overfitting pada Decision Tree
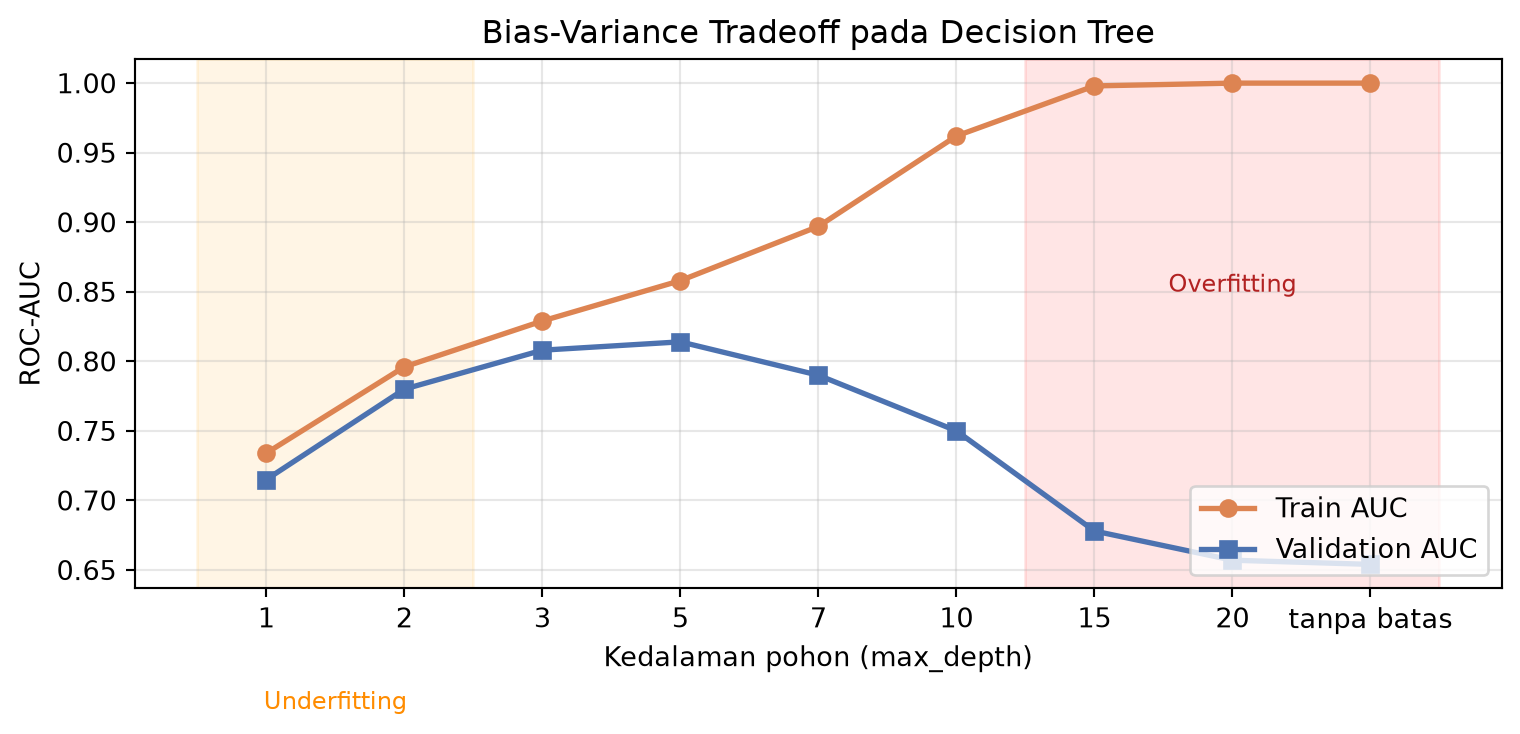
Mari kita lihat overfitting secara langsung. Kita akan melatih decision tree dengan **kedalaman berbeda** dan membandingkan performanya pada train dan validation set.
```{python}
#| label: overfitting-demo
from sklearn.tree import DecisionTreeClassifier
from sklearn.metrics import roc_auc_score

depths = [1, 2, 3, 5, 7, 10, 15, 20, None]
hasil = []

for depth in depths:
    pipe = Pipeline([
        ("prep", preprocessor),
        ("clf", DecisionTreeClassifier(max_depth=depth, random_state=RANDOM_STATE)),
    ])
    pipe.fit(X_train, y_train)

    train_auc = roc_auc_score(y_train, pipe.predict_proba(X_train)[:, 1])
    val_auc = roc_auc_score(y_val, pipe.predict_proba(X_val)[:, 1])

    hasil.append({
        "max_depth": depth if depth is not None else "tanpa batas",
        "train_AUC": round(train_auc, 3),
        "val_AUC": round(val_auc, 3),
        "selisih": round(train_auc - val_auc, 3),
    })

pd.DataFrame(hasil)
```
```{python}
#| label: fig-bias-variance
#| fig-cap: "Bias-variance tradeoff. Model dengan kedalaman kecil underfitting (kedua kurva rendah). Model dengan kedalaman besar overfitting (train tinggi, validation menurun)."
#| fig-width: 8
#| fig-height: 4
plot_data = pd.DataFrame(hasil)
plot_data["depth_num"] = range(1, len(plot_data) + 1)

fig, ax = plt.subplots(figsize=(8, 4))
ax.plot(plot_data["depth_num"], plot_data["train_AUC"], marker="o",
        label="Train AUC", color="#DD8452", linewidth=2)
ax.plot(plot_data["depth_num"], plot_data["val_AUC"], marker="s",
        label="Validation AUC", color="#4C72B0", linewidth=2)

# Anotasi zona
ax.axvspan(0.5, 2.5, alpha=0.1, color="orange")
ax.axvspan(6.5, len(plot_data) + 0.5, alpha=0.1, color="red")
ax.text(1.5, 0.55, "Underfitting", ha="center", fontsize=9, color="darkorange")
ax.text(8, 0.85, "Overfitting", ha="center", fontsize=9, color="firebrick")

ax.set_xticks(plot_data["depth_num"])
ax.set_xticklabels(plot_data["max_depth"])
ax.set_xlabel("Kedalaman pohon (max_depth)")
ax.set_ylabel("ROC-AUC")
ax.set_title("Bias-Variance Tradeoff pada Decision Tree")
ax.legend(loc="lower right")
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
```
**Cara membaca grafik ini:**
- **Kedalaman 1–2 (underfitting)**: Train dan validation AUC keduanya rendah—model terlalu sederhana untuk menangkap pola.
- **Kedalaman 3–7 (zona ideal)**: Train dan validation AUC naik bersama—model menangkap pola tanpa menghafal noise. Titik di mana **validation AUC tertinggi** adalah kandidat model terbaik.
- **Kedalaman 10+ (overfitting)**: Train AUC terus naik menuju 1,0, tetapi **validation AUC mulai menurun**—model menghafal noise dalam train set, dan performanya pada data baru memburuk.
::: {.callout-important}
**Cara mendeteksi overfitting.** Tanda paling jelas adalah **selisih besar antara performa train dan validation**. Jika train AUC 0,99 tetapi validation AUC 0,75, model kita overfitting. Selisih 5–10% masih wajar; selisih >15% adalah tanda bahaya.
**Cara mendeteksi underfitting.** Jika **kedua** performa (train dan validation) rendah dan tidak ada model sederhana yang berhasil, model kita underfitting. Solusinya bukan regularisasi—tetapi model yang lebih kompleks.
:::
## Data Leakage: Musuh yang Tidak Terlihat
**Data leakage** adalah kondisi ketika model tidak sengaja memiliki akses ke informasi yang **tidak akan tersedia** pada saat prediksi di dunia nyata. Ini adalah kesalahan paling berbahaya dalam pemodelan prediktif, karena model akan tampak **sangat baik** selama pengujian tetapi **gagal total** ketika diterapkan.
### Contoh Data Leakage
| Jenis Leakage | Contoh | Mengapa berbahaya |
|---|---|---|
| **Target leakage** | Fitur `TotalCharges` dihitung **setelah** pelanggan churn (mencakup tagihan terakhir) | Model akan belajar bahwa "TotalCharges tinggi = churn" padahal sebenarnya itu adalah konsekuensi churn |
| **Temporal leakage** | Model menggunakan data 2024 untuk memprediksi 2023 | Di dunia nyata, kita tidak punya data masa depan |
| **Preprocessing leakage** | Menstandardisasi fitur pada **seluruh** dataset, lalu membagi train/test | Statistik (mean, std) dari test bocor ke preprocessing—model tampak lebih baik daripada seharusnya |
| **Group leakage** | Data pelanggan yang sama muncul di train dan test | Model menghafal pelanggan tersebut, bukan pola umum |
### Contoh Temporal Leakage di Dataset Telco
Dataset Telco tidak memiliki timestamp, tetapi kita bisa membayangkan leakagenya. Misalnya:
```{python}
#| label: leakage-demo
#| eval: false
# JANGAN LAKUKAN INI — contoh anti-pattern
X_leaky = X.copy()
# Bayangkan kita punya kolom "last_complaint_date" yang hanya diisi
# SETELAH pelanggan menyatakan churn.
# X_leaky["had_complaint"] = (df["last_complaint_date"].notna()).astype(int)
# Model akan mendapat AUC 0.99 — tetapi tidak akan berguna di dunia nyata.
```
**Cara mendeteksi leakage.** Tanyakan untuk setiap fitur: *"Apakah nilai fitur ini akan tersedia pada saat prediksi?"* Jika tidak, fitur tersebut tidak boleh digunakan.
### Mencegah Preprocessing Leakage
Kesalahan klasik: menstandardisasi data **sebelum** train/test split. Cara yang benar: preprocessing **di dalam pipeline**, sehingga hanya melihat train set saat fitting.
```{python}
#| label: leakage-prevent
# BENAR: preprocessing di dalam pipeline
# Pipeline hanya "melihat" train set saat .fit()
# Saat .predict() pada test set, scaler menggunakan statistik dari train
# (bukan dari test) — sehingga tidak ada leakage.

print("Pipeline yang kita bangun di atas:")
print("  1. SimpleImputer menghitung median dari X_train saja")
print("  2. StandardScaler menghitung mean/std dari X_train saja")
print("  3. OneHotEncoder mempelajari kategori dari X_train saja")
print()
print("→ Semua statistik diturunkan dari train, diterapkan ke test.")
print("→ Tidak ada informasi test yang 'bocor' ke preprocessing.")
```
::: {.callout-warning}
**Aturan praktis.** **Jangan pernah** melakukan preprocessing (imputasi, scaling, encoding) di luar pipeline. Bahkan jika hasilnya tampak sama, ia menciptakan risiko leakage yang tidak terlihat. Pipeline scikit-learn ada **persis** untuk mencegah kesalahan ini—gunakan selalu.
:::
## Baseline Model: Yang Harus Dikalahkan
Dengan kerangka di atas, mari kita bangun **baseline**—model paling sederhana yang masuk akal. Baseline ini akan menjadi pembanding untuk model yang lebih canggih di Bab 8–9.
```{python}
#| label: baseline-fit
# Latih pada train set, evaluasi pada validation set
baseline_pipeline.fit(X_train, y_train)

# Prediksi
y_train_pred = baseline_pipeline.predict_proba(X_train)[:, 1]
y_val_pred = baseline_pipeline.predict_proba(X_val)[:, 1]

# Evaluasi
from sklearn.metrics import roc_auc_score, accuracy_score

print("=== Baseline: Logistic Regression + Preprocessing ===")
print(f"Train AUC     : {roc_auc_score(y_train, y_train_pred):.3f}")
print(f"Validation AUC: {roc_auc_score(y_val, y_val_pred):.3f}")
print(f"Train accuracy: {accuracy_score(y_train, baseline_pipeline.predict(X_train)):.3f}")
print(f"Val accuracy  : {accuracy_score(y_val, baseline_pipeline.predict(X_val)):.3f}")
```
```{python}
#| label: compare-baselines
from sklearn.metrics import accuracy_score, roc_auc_score

# Konversi target ke biner 0/1 SEKALI di sini
y_val_bin = (y_val == "Yes").astype(int)
y_train_bin = (y_train == "Yes").astype(int)

# Trivial: selalu prediksi "No" (0)
trivial_pred = np.zeros(len(y_val_bin), dtype=int)
trivial_accuracy = accuracy_score(y_val_bin, trivial_pred)
trivial_auc = 0.5

# Naif: prediksi "Yes" (1) jika Contract == Month-to-month
naive_pred = (X_val["Contract"] == "Month-to-month").astype(int).values
naive_accuracy = accuracy_score(y_val_bin, naive_pred)
naive_auc = roc_auc_score(y_val_bin, naive_pred)

# Baseline LogReg:
#   - predict()       → string "Yes"/"No"  → bandingkan ke "Yes" agar jadi 0/1
#   - predict_proba() → float 0–1          → langsung dipakai untuk AUC
baseline_accuracy = accuracy_score(
    y_val_bin,
    baseline_pipeline.predict(X_val) == "Yes"
)
baseline_auc = roc_auc_score(y_val_bin, y_val_pred)

pd.DataFrame({
    "Model": ["Trivial (selalu 'No')", "Naif (Contract)", "Baseline (LogReg)"],
    "Val accuracy": [
        f"{trivial_accuracy:.1%}",
        f"{naive_accuracy:.1%}",
        f"{baseline_accuracy:.1%}",
    ],
    "Val ROC-AUC": [
        f"{trivial_auc:.3f}",
        f"{naive_auc:.3f}",
        f"{baseline_auc:.3f}",
    ],
})
```
Perhatikan pola penting:
- **Baseline trivial** memiliki akurasi tertinggi (73,5%) tetapi AUC terburuk (0,5). Ini menunjukkan bahwa **akurasi bukan metrik yang tepat** untuk kelas tidak seimbang.
- **Baseline naif** mengalahkan trivial dalam AUC tetapi kalah dalam akurasi. Ini adalah ilustrasi sempurna bahwa **metrik yang kita pilih menentukan model yang kita pilih**.
- **Baseline LogReg** mengalahkan keduanya dalam AUC—dan inilah **titik awal** yang harus dikalahkan oleh model yang lebih canggih.
::: {.callout-important}
**Peluang untuk model yang lebih baik.** Baseline LogReg mencapai AUC ~0,85. Model yang lebih canggih (random forest, gradient boosting) di Bab 9 mungkin mencapai AUC 0,88–0,90. Tetapi **peningkatan 3–5% ini tidak otomatis berarti lebih baik**—kita harus mempertimbangkan interpretabilitas, biaya komputasi, dan kemudahan deployment. Sering kali, model yang lebih sederhana dipilih karena **lebih mudah dijelaskan kepada pemangku kepentingan**, meskipun performanya sedikit lebih rendah.
:::
## Latihan Terbimbing
**Latihan 7.1 — Formulasi masalah.**
Untuk setiap skenario berikut, tentukan: (a) jenis target (biner/kontinu/multikelas), (b) metrik yang tepat, (c) baseline yang wajar.
- (a) Memprediksi apakah pelanggan akan membayar tagihan tepat waktu.
- (b) Memprediksi berapa banyak unit produk yang akan terjual besok.
- (c) Memprediksi jenis kontrak yang akan dipilih pelanggan baru (bulanan/tahunan/dua tahun).
**Latihan 7.2 — Split vs CV.**
Jelaskan dalam satu paragraf: mengapa kita membutuhkan **keduanya**—train/validation/test split **dan** cross-validation? Kapan menggunakan yang mana?
**Latihan 7.3 — Deteksi overfitting.**
Hasil berikut berasal dari tiga model pada dataset yang sama:
| Model | Train AUC | Val AUC |
|---|---|---|
| A | 0,72 | 0,70 |
| B | 0,95 | 0,75 |
| C | 0,65 | 0,64 |
Model mana yang **overfitting**? Model mana yang **underfitting**? Model mana yang tampaknya paling seimbang? Jelaskan.
**Latihan 7.4 — Identifikasi leakage.**
Untuk setiap fitur berikut, tentukan apakah aman digunakan untuk memprediksi churn, atau berpotensi leakage:
- (a) `tenure` (bulan berlangganan)
- (b) `total_support_tickets` (jumlah tiket dukungan yang dibuka **selama** berlangganan)
- (c) `last_payment_date` (tanggal pembayaran terakhir)
- (d) `account_status` (aktif/ditutup—hanya diperbarui setelah pelanggan churn)
- (e) `monthly_charges`
**Latihan 7.5 — Baseline comparison.**
Bangun baseline trivial kedua: prediksi "Yes" jika `tenure <= 6`. Bandingkan dengan baseline `Contract` yang sudah kita buat. Mana yang lebih baik dalam AUC? Mana yang lebih baik dalam akurasi? Mana yang akan kita pilih untuk sistem retensi, dan mengapa?
::: {.callout-note collapse="true"}
**Petunjuk Latihan 7.3.** Ingat definisi:
- **Overfitting**: train tinggi, validation rendah, selisih besar.
- **Underfitting**: train dan validation keduanya rendah.
- **Seimbang**: train dan validation tinggi, selisih kecil.
Model B overfitting (selisih 0,20). Model C underfitting (keduanya rendah). Model A paling seimbang (selisih 0,02). Tetapi "paling seimbang" tidak berarti "terbaik"—model A mungkin masih kalah dari model yang lebih kompleks jika model itu memiliki validation AUC yang lebih tinggi.
:::
## Kotak "Jembatan": Dari Data ke Keputusan
::: {.callout-important}
**Jembatan.** Bab ini memberi kita **kerangka** yang akan menyertai seluruh Bagian II:
1. **Model bukan kotak hitam.** Setiap model memiliki asumsi, batasan, dan kegagalan. Kerangka bias-variance mengajarkan kita kapan model perlu dibuat lebih kompleks, dan kapan perlu disederhanakan.
2. **Metrik bukan tujuan.** Memaksimalkan AUC tanpa mempertimbangkan konteks bisnis adalah kesalahan. Model dengan AUC 0,85 tetapi interpretabilitas tinggi sering lebih berharga daripada model dengan AUC 0,90 tetapi tidak bisa dijelaskan ke pemangku kepentingan.
3. **Data leakage adalah ancaman nyata.** Model yang tampak sempurna dalam pengujian bisa gagal total dalam produksi jika ada leakage. Selalu tanyakan: *"Apakah informasi ini akan tersedia saat prediksi?"*
4. **Baseline bukan formalitas.** Baseline mengingatkan kita bahwa model yang canggih belum tentu lebih baik dari aturan sederhana. Banyak model machine learning yang dikembangkan dengan biaya besar akhirnya kalah dari aturan sederhana yang sudah dipakai tim bisnis selama bertahun-tahun.
Dengan kerangka ini, kita siap membangun model yang lebih canggih. Bab 8 akan fokus pada **regresi**—fondasi statistik untuk memodelkan hubungan antar variabel. Bab 9 akan fokus pada **klasifikasi**—yang secara langsung menjawab pertanyaan churn kita.
:::
## Rangkuman
Dalam bab ini kita telah:
- **Membedakan prediksi dari deskripsi**, memahami bahwa prediksi menjawab pertanyaan **tingkat individu** sementara deskripsi menjawab **tingkat populasi**.
- **Merumuskan masalah prediktif** dengan lima pertanyaan kunci: apa targetnya, untuk siapa, kapan, apa konsekuensi kesalahannya, dan apa baseline-nya.
- **Menerapkan CRISP-DM** sebagai kerangka kerja siklus pemodelan, dengan penekanan pada iterasi antara modeling dan evaluation.
- **Membagi data menjadi train/validation/test** dengan stratifikasi, memahami peran unik masing-masing subset dan aturan emas test set.
- **Menerapkan cross-validation** untuk estimasi performa yang lebih stabil, dan memahami kapan CV lebih tepat daripada single split.
- **Memahami bias-variance tradeoff** sebagai fondasi semua pemodelan, dan mendemonstrasikan overfitting secara langsung dengan decision tree.
- **Mengenali dan menghindari data leakage**—terutama dalam preprocessing—dengan menerapkan pipeline scikit-learn.
- **Membangun baseline model** (LogReg + preprocessing) yang mencapai AUC ~0,85, mengalahkan baseline trivial dan naif—dan menjadi patokan yang harus dikalahkan oleh model di bab selanjutnya.
## Jembatan ke Bab 8
Kita memiliki kerangka. Sekarang kita membutuhkan model yang sesungguhnya. Bab 8—**Regresi**—akan memperkenalkan fondasi statistik untuk memodelkan hubungan antar variabel:
- **Regresi linear** untuk target kontinu, dengan interpretasi koefisien yang jelas.
- **Regresi logistik** untuk target biner—model yang baru saja kita pakai sebagai baseline, tetapi akan kita pelajari secara mendalam.
- **Diagnostik residual** untuk memeriksa apakah asumsi model terpenuhi.
- **Regularisasi** (Ridge, Lasso) untuk mengendalikan kompleksitas model.
Regresi bukan sekadar "model sederhana yang kalah dari random forest". Ia adalah **fondasi** dari sebagian besar machine learning modern, dan pemahaman mendalamnya akan membuat kita lebih efektif dalam semua model yang lebih canggih.