---
jupyter: decanal
---
# Network & Multi-Objective Optimization {#sec-network-multiobjective}
::: {.callout-note appearance="simple"}
**Tujuan pembelajaran.** Setelah menyelesaikan bab ini, kita akan mampu:
1. Mengenali struktur **jaringan** dalam masalah optimasi—simpul (node) dan busur (arc).
2. Memformulasikan dan menyelesaikan **transportation problem** untuk distribusi barang.
3. Menerapkan **assignment problem** untuk penugasan sumber daya.
4. Memahami **minimum cost flow** sebagai kerangka umum untuk semua masalah jaringan.
5. Memformulasikan **multi-objective optimization** ketika keputusan memiliki tujuan yang bertentangan.
6. Menghasilkan dan menafsirkan **Pareto frontier**.
7. Menerapkan network dan multi-objective optimization pada distribusi retail dan alokasi anggaran.
:::
## Mengapa Network Optimization?
Di Bab 14–15, kita memodelkan optimasi sebagai **pemilihan jumlah**—berapa unit produk, berapa pelanggan, berapa karyawan. Tetapi banyak keputusan bisnis melibatkan **aliran melalui jaringan**:
- Barang mengalir dari **gudang** ke **toko**.
- Karyawan ditugaskan dari **rumah** ke **kantor**.
- Data mengalir dari **server** ke **pengguna**.
- Pasien dirujuk dari **klinik** ke **rumah sakit**.
Masalah-masalah ini memiliki **struktur jaringan**—dan struktur ini memungkinkan solusi yang **jauh lebih efisien** daripada LP umum. Bahkan, masalah network flow dapat diselesaikan dengan algoritma khusus yang **ratusan kali lebih cepat** daripada simpleks untuk masalah berukuran sama.
::: {.callout-important}
**Network flow adalah LP dengan struktur khusus.** Setiap masalah network flow **adalah** masalah LP—tetapi dengan matriks kendala yang sangat jarang (sparse) dan terstruktur. Struktur ini memungkinkan:
- **Solusi integer otomatis**—jika kapasitas dan permintaan integer, solusi optimal juga integer (tanpa perlu integer programming).
- **Algoritma khusus**—network simplex, successive shortest path, dll.—yang jauh lebih cepat dari LP umum.
Inilah mengapa **mengenali struktur jaringan** adalah keterampilan penting: kita bisa menyelesaikan masalah yang tampak rumit dengan alat yang efisien.
:::
## Anatomi Jaringan
Setiap masalah jaringan memiliki **tiga komponen**:
| Komponen | Simbol | Contoh |
|---|---|---|
| **Node** (simpul) | $N$ | Gudang, toko, kota, server |
| **Arc** (busur) | $A$ | Rute dari gudang ke toko |
| **Flow** (aliran) | $x_{ij}$ | Jumlah unit dikirim dari node $i$ ke node $j$ |
**Parameter** yang biasanya menyertai:
- **Kapasitas** busur: batas maksimum aliran.
- **Biaya** per unit aliran.
- **Supply/demand** di setiap node: berapa yang tersedia/dibutuhkan.
## Transportation Problem: Distribusi Barang
**Transportation problem** adalah masalah jaringan paling fundamental: **bagaimana mendistribusikan barang dari beberapa sumber (supply) ke beberapa tujuan (demand) dengan biaya minimum?**
### Formulasi
**Variabel keputusan:** $x_{ij}$ = jumlah unit yang dikirim dari sumber $i$ ke tujuan $j$.
**Fungsi tujuan:** minimalkan total biaya transportasi.
$$\min \, Z = \sum_{i} \sum_{j} c_{ij} \cdot x_{ij}$$
**Kendala:**
- Supply: $\sum_j x_{ij} = s_i$ untuk setiap sumber $i$
- Demand: $\sum_i x_{ij} = d_j$ untuk setiap tujuan $j$
- Non-negatif: $x_{ij} \geq 0$
### Aplikasi: Distribusi Retail
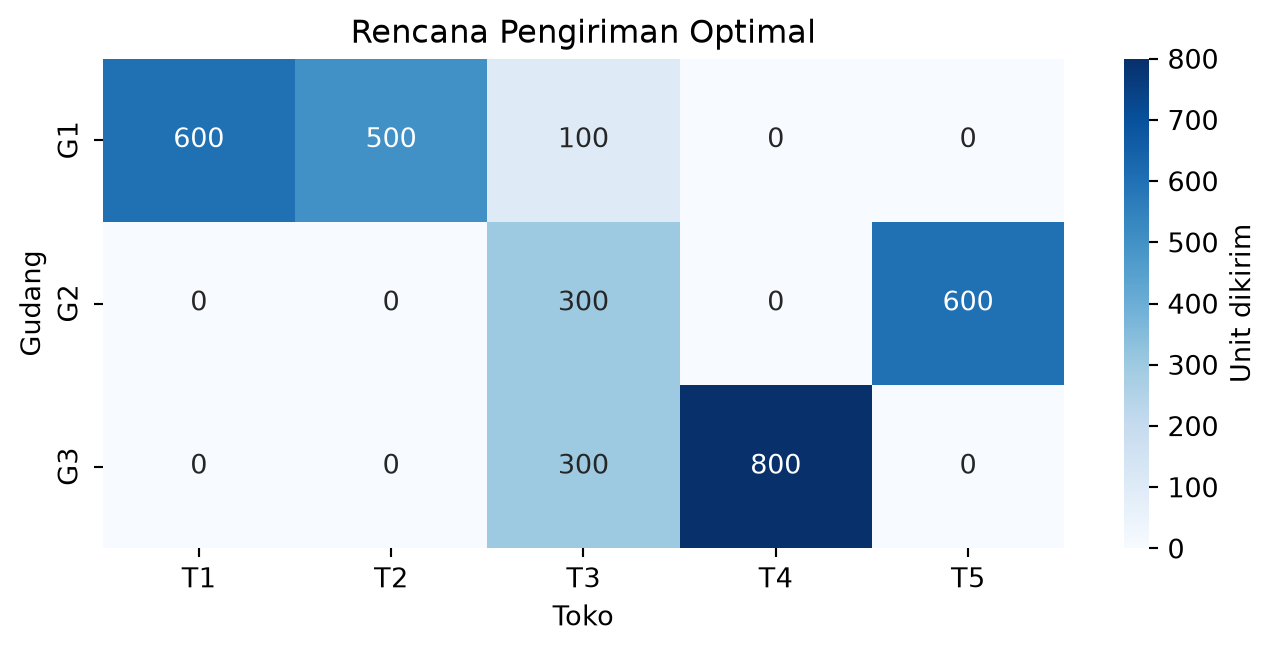
Kita memiliki **3 gudang** dengan kapasitas terbatas dan **5 toko** dengan permintaan tertentu. Biaya transportasi per unit berbeda-beda tergantung jarak.
```{python}
#| label: setup
import sys
sys.path.insert(0, ".")
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import warnings
warnings.filterwarnings("ignore")

from pulp import (
    LpProblem, LpVariable, LpMaximize, LpMinimize, LpStatus,
    lpSum, value, PULP_CBC_CMD,
    LpBinary, LpInteger, LpContinuous,
)

np.random.seed(42)
```
```{python}
#| label: transportation-data
# Supply (kapasitas gudang)
gudang = pd.DataFrame({
    "id": ["G1", "G2", "G3"],
    "supply": [1200, 900, 1100],  # unit
})

# Demand (permintaan toko)
toko = pd.DataFrame({
    "id": ["T1", "T2", "T3", "T4", "T5"],
    "demand": [600, 500, 700, 800, 600],  # unit
})

# Biaya transportasi per unit (Rp ribuan)
# Baris = gudang, kolom = toko
biaya = pd.DataFrame(
    [
        [10, 15, 20, 25, 30],   # G1
        [18, 12, 14, 20, 22],   # G2
        [25, 20, 10, 15, 18],   # G3
    ],
    index=gudang["id"],
    columns=toko["id"],
)

print(f"Total supply  : {gudang['supply'].sum():,} unit")
print(f"Total demand  : {toko['demand'].sum():,} unit")
print(f"Balance       : {'seimbang' if gudang['supply'].sum() == toko['demand'].sum() else 'TIDAK seimbang'}")
print()
print("Biaya transportasi per unit (Rp ribuan):")
biaya
```
::: {.callout-note}
**Total supply harus sama dengan total demand** untuk transportation problem yang **seimbang**. Jika tidak seimbang, kita perlu menambahkan **dummy source** (jika supply > demand) atau **dummy destination** (jika demand > supply) dengan biaya nol. Dalam contoh ini, total supply = 3.200 dan total demand = 3.200—seimbang.
:::
### Solusi dengan PuLP
```{python}
#| label: transportation-lp
transport_model = LpProblem("distribusi_retail", LpMinimize)

# Variabel: x[g,t] = unit dari gudang g ke toko t
x = LpVariable.dicts(
    "kirim",
    [(g, t) for g in gudang["id"] for t in toko["id"]],
    lowBound=0, cat=LpContinuous,
)

# Fungsi tujuan: total biaya transportasi
transport_model += lpSum(
    biaya.loc[g, t] * x[(g, t)]
    for g in gudang["id"] for t in toko["id"]
), "Total_Biaya"

# Kendala supply: setiap gudang mengirim semua kapasitasnya
for _, row in gudang.iterrows():
    transport_model += (
        lpSum(x[(row["id"], t)] for t in toko["id"]) == row["supply"]
    ), f"Supply_{row['id']}"

# Kendala demand: setiap toko menerima semua permintaannya
for _, row in toko.iterrows():
    transport_model += (
        lpSum(x[(g, row["id"])] for g in gudang["id"]) == row["demand"]
    ), f"Demand_{row['id']}"

# Selesaikan
transport_model.solve(PULP_CBC_CMD(msg=False))

print(f"Status       : {LpStatus[transport_model.status]}")
print(f"Total biaya  : Rp {value(transport_model.objective):,.0f} ribu")
print()
print("Rencana pengiriman optimal (unit):")
rencana = pd.DataFrame(
    [[value(x[(g, t)]) for t in toko["id"]] for g in gudang["id"]],
    index=gudang["id"], columns=toko["id"]
)
rencana
```
```{python}
#| label: fig-transport-heatmap
#| fig-cap: "Rencana pengiriman optimal: heatmap aliran dari gudang ke toko. Warna lebih gelap = pengiriman lebih banyak."
#| fig-width: 7
#| fig-height: 3.5
import seaborn as sns

fig, ax = plt.subplots(figsize=(7, 3.5))
sns.heatmap(rencana, annot=True, fmt=".0f", cmap="Blues",
            cbar_kws={"label": "Unit dikirim"}, ax=ax)
ax.set_xlabel("Toko")
ax.set_ylabel("Gudang")
ax.set_title("Rencana Pengiriman Optimal")
plt.tight_layout()
plt.show()
```
::: {.callout-tip}
**Perhatikan pola solusi.** Solusi optimal cenderung mengirim dari gudang **terdekat** ke setiap toko—tetapi dengan **penyesuaian** karena kapasitas. Misalnya, G1 mungkin mengirim ke T1 dan T2 (dekat), tetapi juga ke T4 (jauh) jika G1 memiliki kelebihan kapasitas setelah memenuhi T1 dan T2.
Ini adalah **trade-off** antara biaya per unit dan kapasitas—dan inilah yang membuat transportation problem lebih dari sekadar "pilih yang termurah".
:::
## Assignment Problem: Penugasan Sumber Daya
**Assignment problem** adalah kasus khusus transportation problem di mana **setiap sumber ditugaskan ke tepat satu tujuan**. Contoh: menugaskan karyawan ke proyek, mesin ke pekerjaan, atau sales ke wilayah.
### Formulasi
**Variabel keputusan:** $x_{ij} \in \{0, 1\}$ = 1 jika sumber $i$ ditugaskan ke tujuan $j$.
**Fungsi tujuan:** minimalkan (atau maksimalkan) total biaya/manfaat.
$$\min \, Z = \sum_i \sum_j c_{ij} \cdot x_{ij}$$
**Kendala:**
- Setiap sumber ditugaskan tepat satu: $\sum_j x_{ij} = 1$
- Setiap tujuan menerima tepat satu: $\sum_i x_{ij} = 1$
- Binary: $x_{ij} \in \{0, 1\}$
### Aplikasi: Penugasan Sales ke Wilayah
Kita memiliki **5 sales** dan **5 wilayah** dengan potensi penjualan yang berbeda. Setiap sales memiliki **efektivitas** berbeda di setiap wilayah (berdasarkan pengalaman, jaringan, atau preferensi).
```{python}
#| label: assignment-data
sales = ["S1", "S2", "S3", "S4", "S5"]
wilayah = ["W1", "W2", "W3", "W4", "W5"]

# Matriks efektivitas: seberapa besar potensi penjualan yang bisa diraih
# (dalam Rp juta per bulan) — semakin tinggi semakin baik
efektivitas = pd.DataFrame(
    [
        [80, 60, 50, 40, 30],   # S1
        [40, 90, 60, 30, 20],   # S2
        [30, 40, 85, 55, 35],   # S3
        [25, 35, 40, 95, 45],   # S4
        [20, 25, 30, 40, 100],  # S5
    ],
    index=sales, columns=wilayah,
)
efektivitas
```
### Solusi Assignment
```{python}
#| label: assignment-lp
assign_model = LpProblem("penugasan_sales", LpMaximize)

# Binary: x[s,w] = 1 jika sales s ditugaskan ke wilayah w
x_assign = LpVariable.dicts(
    "tugas", [(s, w) for s in sales for w in wilayah], cat=LpBinary,
)

# Fungsi tujuan: maksimalkan total efektivitas
assign_model += lpSum(
    efektivitas.loc[s, w] * x_assign[(s, w)]
    for s in sales for w in wilayah
), "Total_Efektivitas"

# Setiap sales ditugaskan tepat satu wilayah
for s in sales:
    assign_model += lpSum(x_assign[(s, w)] for w in wilayah) == 1, f"Sales_{s}"

# Setiap wilayah menerima tepat satu sales
for w in wilayah:
    assign_model += lpSum(x_assign[(s, w)] for s in sales) == 1, f"Wilayah_{w}"

# Selesaikan
assign_model.solve(PULP_CBC_CMD(msg=False))

print(f"Status             : {LpStatus[assign_model.status]}")
print(f"Total efektivitas  : Rp {value(assign_model.objective):,.0f} juta/bulan")
print()
print("Penugasan optimal:")
for s in sales:
    for w in wilayah:
        if value(x_assign[(s, w)]) > 0.5:
            print(f"  {s} → {w}  (efektivitas: Rp {efektivitas.loc[s, w]} juta)")
```
::: {.callout-important}
**Assignment problem adalah integer programming, tetapi...** jika semua supply dan demand = 1, solusi LP-relaxation **otomatis integer**. Ini adalah sifat khusus dari **totally unimodular matrix**—matriks kendala dalam assignment problem. Artinya, kita bisa menyelesaikannya dengan LP biasa (tanpa binary), dan hasilnya akan tetap 0/1.
Ini adalah contoh bagaimana **struktur jaringan** memberi kita **jaminan integer** tanpa perlu branch-and-bound. Dalam praktiknya, tetap lebih aman mendefinisikan sebagai `LpBinary`—tetapi komputasinya sama cepatnya.
:::
## Multi-Objective Optimization
Sampai di sini, setiap model kita memiliki **satu fungsi tujuan**—memaksimalkan profit, meminimalkan biaya, atau memaksimalkan efektivitas. Tetapi keputusan nyata sering melibatkan **tujuan yang bertentangan**:
- **Profit vs. risiko**: return tinggi biasanya datang dengan risiko tinggi.
- **Biaya vs. kualitas**: produk lebih baik biasanya lebih mahal.
- **Efisiensi vs. keadilan**: alokasi optimal mungkin meninggalkan sebagian pihak.
- **Revenue vs. retensi**: diskon besar meningkatkan retensi tetapi menurunkan margin.
**Multi-objective optimization** menangani trade-off ini dengan menghasilkan **Pareto frontier**—seperangkat solusi yang **tidak dapat diperbaiki** dalam satu tujuan tanpa mengorbankan tujuan lain.
### Konsep Pareto Optimality
Sebuah solusi dikatakan **Pareto optimal** jika **tidak ada solusi lain** yang lebih baik dalam **setidaknya satu tujuan** tanpa menjadi lebih buruk dalam tujuan lain.
**Analogi:** Dalam memilih mobil, tidak ada mobil yang lebih baik dalam **semua** aspek (harga, konsumsi bahan bakar, kenyamanan, kecepatan). Setiap mobil adalah kompromi. **Pareto frontier** adalah seperangkat mobil di mana kita tidak bisa mendapatkan mobil yang lebih murah **dan** lebih irit **dan** lebih nyaman—kita harus mengorbankan sesuatu.
### Metode Weighted Sum
Metode paling sederhana untuk multi-objective: **gabungkan tujuan dengan bobot**.
$$\max \, Z = w_1 \cdot f_1(x) + w_2 \cdot f_2(x) + \dots + w_k \cdot f_k(x)$$
dengan $w_i \geq 0$ dan $\sum w_i = 1$. Dengan **memvariasikan bobot**, kita dapat menghasilkan **berbagai titik di Pareto frontier**.
### Aplikasi: Alokasi Anggaran Retensi dengan Dua Tujuan
Kembali ke masalah alokasi retensi—tetapi kali ini dengan **dua tujuan**:
1. **Maksimalkan net benefit** (revenue yang diselamatkan dikurangi biaya).
2. **Maksimalkan jumlah pelanggan yang diintervensi** (cakupan).
Kedua tujuan ini **bertentangan**: intervensi pada pelanggan dengan net benefit tinggi mungkin memerlukan biaya tinggi per pelanggan, sehingga mengurangi jumlah pelanggan yang bisa diintervensi.
```{python}
#| label: multiobjective-data
# Data segmen (dari Bab 14)
segments = pd.DataFrame({
    "segmen": ["Premium Baru", "Loyal Hemat", "Mainstream"],
    "n_pelanggan": [800, 2400, 3800],
    "p_churn": [0.55, 0.12, 0.28],
    "ltv": [1_200_000, 600_000, 900_000],
    "biaya_intervensi": [200_000, 80_000, 120_000],
    "efektivitas": [0.40, 0.25, 0.30],
})
segments["expected_benefit_per_customer"] = (
    segments["p_churn"] * segments["efektivitas"] * segments["ltv"]
)
segments["net_benefit_per_customer"] = (
    segments["expected_benefit_per_customer"] - segments["biaya_intervensi"]
)

BUDGET = 50_000_000
segments
```
```{python}
#| label: pareto-frontier-revisi
def solve_retention(weight_benefit, weight_coverage):
    """Selesaikan alokasi retensi dengan bobot berbeda untuk dua tujuan."""
    model = LpProblem("alokasi_multiobj", LpMaximize)

    x_mo = LpVariable.dicts(
        "intervensi", segments["segmen"].tolist(), lowBound=0, cat=LpContinuous,
    )

    max_benefit = (segments["net_benefit_per_customer"] * segments["n_pelanggan"]).sum()
    max_coverage = segments["n_pelanggan"].sum()

    model += (
        weight_benefit * lpSum(
            segments.loc[i, "net_benefit_per_customer"] * x_mo[seg]
            for i, seg in enumerate(segments["segmen"])
        ) / max_benefit +
        weight_coverage * lpSum(x_mo[seg] for seg in segments["segmen"]) / max_coverage
    ), "Tujuan_Gabungan"

    # Anggaran
    model += lpSum(
        segments.loc[i, "biaya_intervensi"] * x_mo[seg]
        for i, seg in enumerate(segments["segmen"])
    ) <= BUDGET, "Anggaran"

    # KAPASITAS — kendala baru yang menciptakan trade-off
    model += lpSum(x_mo[seg] for seg in segments["segmen"]) <= 1500, "Kapasitas"

    # Batas segmen
    for i, seg in enumerate(segments["segmen"]):
        model += x_mo[seg] <= segments.loc[i, "n_pelanggan"], f"Batas_{seg.replace(' ', '_')}"

    model.solve(PULP_CBC_CMD(msg=False))

    if LpStatus[model.status] != "Optimal":
        return None

    benefit = sum(
        segments.loc[i, "net_benefit_per_customer"] * value(x_mo[seg])
        for i, seg in enumerate(segments["segmen"])
    )
    coverage = sum(value(x_mo[seg]) for seg in segments["segmen"])

    return {
        "benefit": benefit,
        "coverage": coverage,
        "alokasi": {seg: value(x_mo[seg]) for seg in segments["segmen"]},
    }

weights = np.linspace(0, 1, 21)
pareto_points = []

for w in weights:
    result = solve_retention(weight_benefit=w, weight_coverage=1-w)
    if result:
        pareto_points.append({
            "weight_benefit": w,
            "weight_coverage": 1-w,
            **result,
        })

pareto_df = pd.DataFrame(pareto_points)
pareto_df[["weight_benefit", "weight_coverage", "benefit", "coverage"]].round(2)
```
```{python}
#| label: fig-pareto
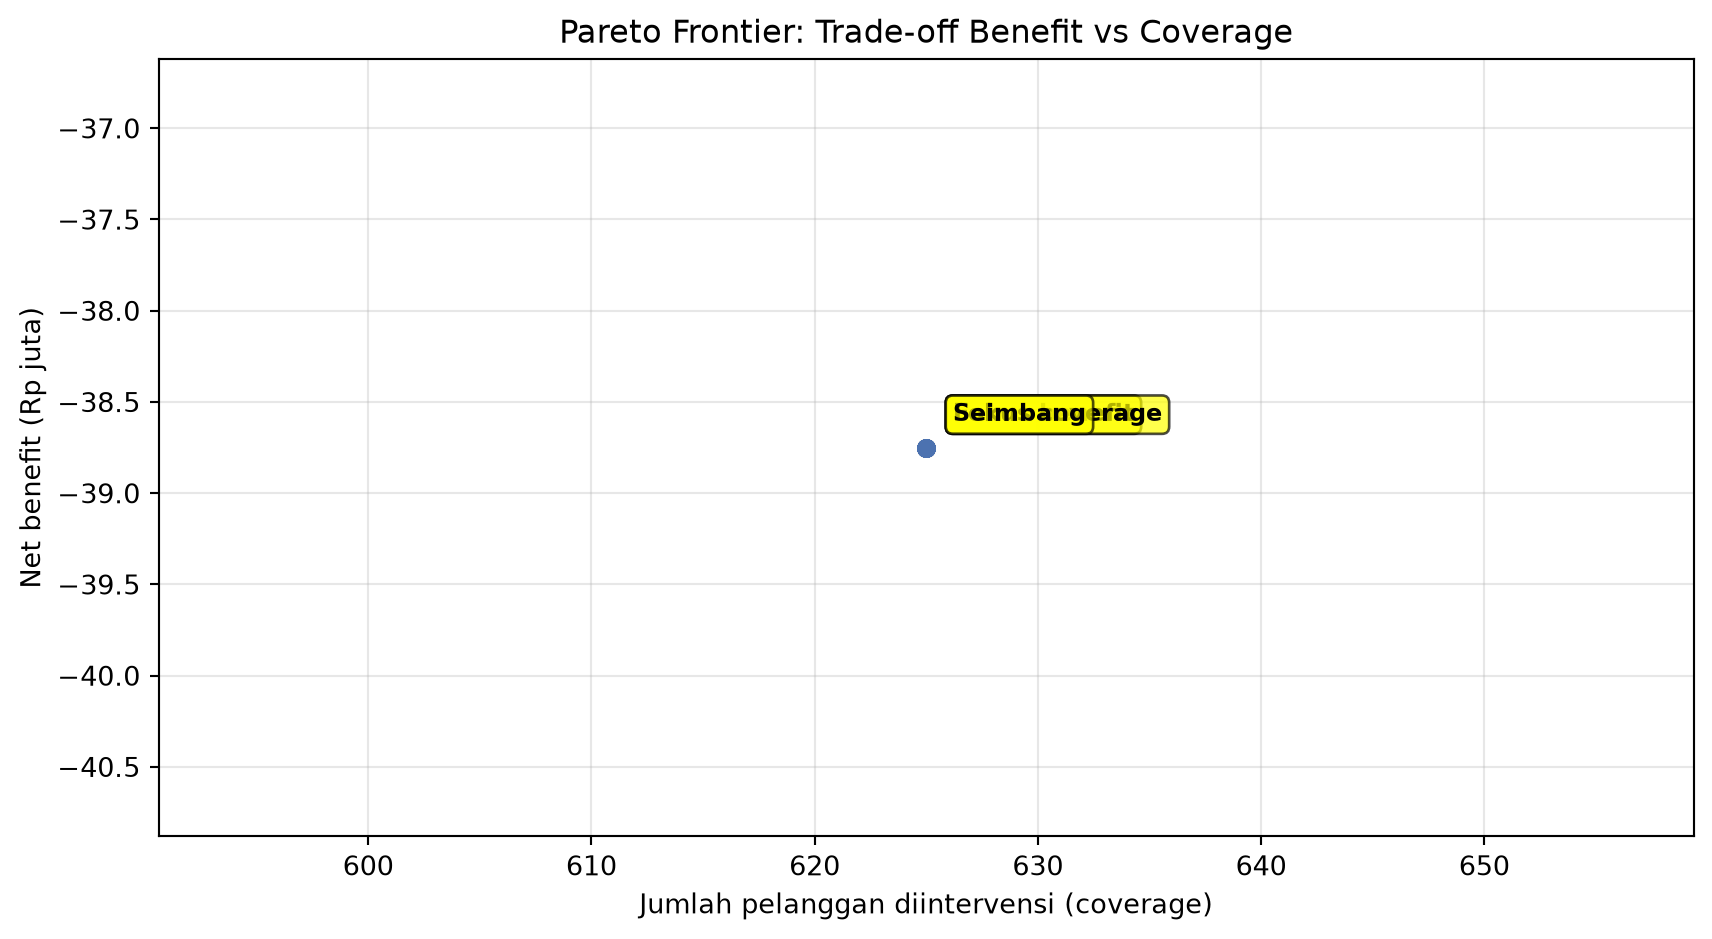
#| fig-cap: "Pareto frontier: trade-off antara net benefit dan jumlah pelanggan yang diintervensi. Setiap titik mewakili solusi optimal untuk kombinasi bobot tertentu."
#| fig-width: 9
#| fig-height: 5
fig, ax = plt.subplots(figsize=(9, 5))

ax.plot(pareto_df["coverage"], pareto_df["benefit"] / 1e6,
        marker="o", color="#4C72B0", linewidth=2, markersize=6)

# Anotasi titik ekstrem
extremes = {
    "Fokus benefit": pareto_df.loc[pareto_df["weight_benefit"].idxmax()],
    "Fokus coverage": pareto_df.loc[pareto_df["weight_coverage"].idxmax()],
    "Seimbang": pareto_df.loc[(pareto_df["weight_benefit"] - 0.5).abs().idxmin()],
}

for label, point in extremes.items():
    ax.annotate(label,
                (point["coverage"], point["benefit"] / 1e6),
                textcoords="offset points", xytext=(10, 10),
                fontsize=9, fontweight="bold",
                bbox=dict(boxstyle="round,pad=0.3", facecolor="yellow", alpha=0.7))

ax.set_xlabel("Jumlah pelanggan diintervensi (coverage)")
ax.set_ylabel("Net benefit (Rp juta)")
ax.set_title("Pareto Frontier: Trade-off Benefit vs Coverage")
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
```
::: {.callout-important}
**Cara membaca Pareto frontier:**
1. **Setiap titik adalah optimal** untuk kombinasi bobot tertentu. Tidak ada titik yang "salah"—mereka mewakili **preferensi** yang berbeda.
2. **Titik di kiri atas** ("Fokus benefit"): net benefit tinggi, tetapi coverage rendah. Ini adalah strategi **efisiensi**—hanya intervensi pelanggan paling bernilai.
3. **Titik di kanan bawah** ("Fokus coverage"): coverage tinggi, tetapi net benefit rendah. Ini adalah strategi **inklusivitas**—intervensi sebanyak mungkin pelanggan, meskipun beberapa mungkin tidak "layak" secara finansial.
4. **Titik tengah**: kompromi seimbang antara kedua tujuan.
**Pilihan akhir adalah keputusan manajemen**—bukan keputusan matematis. Model memberi kita **frontier** (pilihan yang tersedia); manajemen memilih **titik** berdasarkan prioritas strategis.
:::
### Memilih Titik di Pareto Frontier
Bagaimana memilih titik yang tepat? Ada beberapa pendekatan:
| Pendekatan | Prinsip | Kapan dipakai |
|---|---|---|
| **Prioritas strategis** | Manajemen memilih bobot berdasarkan visi | Keputusan strategis jangka panjang |
| **Knee point** | Titik dengan trade-off paling seimbang | Ketika tidak ada preferensi jelas |
| **Kendala batas** | Optimalkan satu tujuan dengan kendala pada tujuan lain | Ketika ada batas minimum/maksimum |
| **Analisis sensitivitas** | Bandingkan marginal trade-off antar titik | Untuk memahami "harga" dari setiap tujuan |
**Knee point** adalah titik di mana trade-off berubah paling drastis—perubahan kecil pada satu tujuan memerlukan pengorbanan besar pada tujuan lain. Ini sering menjadi pilihan default yang baik ketika tidak ada preferensi eksplisit.
```{python}
#| label: diagnose-pareto
print(f"Jumlah titik Pareto: {len(pareto_df)}")
print(f"\nStatistik benefit:")
print(pareto_df["benefit"].describe())
print(f"\nStatistik coverage:")
print(pareto_df["coverage"].describe())
print(f"\nVariasi benefit  : {pareto_df['benefit'].max() - pareto_df['benefit'].min():,.0f}")
print(f"Variasi coverage : {pareto_df['coverage'].max() - pareto_df['coverage'].min():.0f}")
```
```{python}
#| label: knee-point-revisi
from scipy.spatial.distance import euclidean

benefit_range = pareto_df["benefit"].max() - pareto_df["benefit"].min()
coverage_range = pareto_df["coverage"].max() - pareto_df["coverage"].min()

# Cek apakah ada variasi yang cukup
if benefit_range < 1 or coverage_range < 1:
    print("⚠️  Tidak ada variasi yang cukup di Pareto frontier.")
    print(f"   Variasi benefit : {benefit_range:,.0f}")
    print(f"   Variasi coverage: {coverage_range:,.0f}")
    print("   Kemungkinan kendala tidak mengikat — periksa parameter.")
else:
    benefit_norm = (pareto_df["benefit"] - pareto_df["benefit"].min()) / benefit_range
    coverage_norm = (pareto_df["coverage"] - pareto_df["coverage"].min()) / coverage_range

    distance_from_diagonal = np.abs(benefit_norm - coverage_norm)
    # Pastikan tidak ada NaN sebelum idxmax
    valid_mask = distance_from_diagonal.notna()

    if not valid_mask.any():
        print("⚠️  Semua nilai distance_from_diagonal adalah NaN.")
    else:
        knee_idx = distance_from_diagonal[valid_mask].idxmax()
        knee = pareto_df.loc[knee_idx]
        print(f"Knee point:")
        print(f"  Bobot benefit  : {knee['weight_benefit']:.2f}")
        print(f"  Bobot coverage : {knee['weight_coverage']:.2f}")
        print(f"  Net benefit    : Rp {knee['benefit']:,.0f}")
        print(f"  Coverage       : {knee['coverage']:.0f} pelanggan")
```
::: {.callout-warning}
**Pareto frontier membutuhkan trade-off yang nyata.** Jika kendala terlalu longgar, LP akan selalu memilih solusi yang sama terlepas dari bobot—sehingga Pareto frontier hanya berisi satu titik. Ini menyebabkan normalisasi `0/0` dan error `NaN`.
**Solusi:** pastikan setidaknya satu kendala **mengikat** (aktif), sehingga solusi berubah seiring prioritas. Dalam model retensi, tambahkan kendala kapasitas (mis. ≤ 1.500 pelanggan) agar trade-off antara benefit dan coverage muncul.
:::
## Minimum Cost Flow: Kerangka Umum
Transportation dan assignment adalah **kasus khusus** dari kerangka yang lebih umum: **minimum cost flow**. Dalam kerangka ini:
- Setiap node memiliki **supply** (positif) atau **demand** (negatif).
- Setiap busur memiliki **kapasitas** dan **biaya**.
- Tujuannya adalah mengalirkan barang dari supply ke demand dengan **biaya minimum**.
**Semua masalah jaringan**—transportation, assignment, shortest path, maximum flow—dapat diformulasikan sebagai minimum cost flow. Ini berarti:
- **Algoritma yang sama** dapat menyelesaikan semua variasi.
- **Wawasan dari satu masalah** dapat ditransfer ke masalah lain.
::: {.callout-tip}
**Library khusus untuk network flow: NetworkX.** Meskipun PuLP dapat menyelesaikan masalah jaringan, library `NetworkX` menyediakan algoritma **khusus jaringan** yang jauh lebih cepat untuk masalah besar—terutama untuk shortest path, maximum flow, dan minimum cost flow.
Untuk buku ini, kita tetap menggunakan PuLP agar konsisten dengan Bab 14–15. Tetapi untuk masalah produksi dengan ribuan node, `NetworkX` atau `OR-Tools` adalah pilihan yang lebih baik.
:::
## Latihan Terbimbing
**Latihan 16.1 — Transportation dengan biaya berbeda.**
Modifikasi transportation problem dengan mengubah matriks biaya: buat G1 sangat mahal ke semua toko (biaya ×2). Bagaimana solusi berubah? Apakah G1 masih mengirim? Jika tidak, apa implikasinya untuk keputusan investasi gudang?
**Latihan 16.2 — Assignment dengan preferensi.**
Modifikasi assignment problem dengan menambahkan **preferensi sales**: setiap sales memiliki wilayah yang mereka sukai (dengan bobot +20% efektivitas). Bagaimana penugasan berubah? Apakah preferensi mengalahkan efektivitas?
**Latihan 16.3 — Transshipment.**
Kembangkan transportation problem menjadi **transshipment**: tambahkan **gudang perantara** yang menerima barang dari gudang utama dan mendistribusikan ke toko. Formulasikan dan selesaikan. Berapa penghematan biaya dibandingkan transportasi langsung?
**Latihan 16.4 — Multi-objective dengan tiga tujuan.**
Kembangkan model alokasi retensi dengan **tiga tujuan**: net benefit, coverage, dan **keadilan** (setiap segmen harus mendapat minimal 10% dari anggaran). Formulasikan dan hasilkan Pareto frontier 3D. Bagaimana kompleksitasnya meningkat?
**Latihan 16.5 — Kendala batas vs weighted sum.**
Untuk model multi-objective retensi, gunakan pendekatan **kendala batas**: maksimalkan net benefit dengan kendala coverage ≥ 500 pelanggan. Bandingkan solusinya dengan titik yang dihasilkan oleh weighted sum. Apakah hasilnya sama?
**Latihan 16.6 — NetworkX untuk shortest path.**
Gunakan `NetworkX` untuk menyelesaikan **shortest path** dari G1 ke T5 melalui jaringan gudang-toko. Bandingkan hasilnya dengan solusi PuLP. Library mana yang lebih mudah digunakan untuk masalah ini?
::: {.callout-note collapse="true"}
**Petunjuk Latihan 16.3.** Untuk transshipment, kita perlu **dua set variabel**: aliran dari gudang utama ke gudang perantara, dan aliran dari gudang perantara ke toko. Gudang perantara memiliki **kendala konservasi aliran**: total masuk = total keluar (kecuali ada supply/demand tambahan).
:::
## Kotak "Jembatan": Dari Jaringan ke Simulasi Keputusan
::: {.callout-important}
**Jembatan.** Bab ini telah memperluas optimasi kita ke dua arah penting:
1. **Struktur jaringan** memungkinkan kita menyelesaikan masalah distribusi, penugasan, dan aliran dengan **efisien**—sering kali dengan jaminan integer otomatis.
2. **Multi-objective optimization** memungkinkan kita menangani **trade-off** antar tujuan yang bertentangan—dan menghasilkan **Pareto frontier** yang memberi manajemen **pilihan**, bukan satu jawaban.
Tetapi **satu keterbatasan besar masih tersisa**: semua model kita mengasumsikan parameter **diketahui dengan pasti**. Padahal, dalam praktik:
- Permintaan toko **tidak pasti**—bisa lebih tinggi atau lebih rendah dari perkiraan.
- Biaya transportasi **tidak pasti**—bisa berubah karena bahan bakar atau cuaca.
- Efektivitas intervensi **tidak pasti**—tidak semua pelanggan merespons dengan cara yang sama.
**Bab 17—Simulation for Decision Making**—akan menggabungkan **optimasi** dengan **simulasi** untuk menangani ketidakpastian ini. Kita akan belajar:
- **Simulation-optimization**: menggunakan simulasi untuk mengevaluasi keputusan, dan optimasi untuk mencari keputusan terbaik.
- **Robust optimization**: mencari keputusan yang **tahan** terhadap berbagai skenario.
- **Stochastic programming**: memodelkan ketidakpastian secara eksplisit dalam formulasi optimasi.
Dengan kata lain: **bab ini memberi kita alat untuk mengoptimalkan di dunia yang pasti; bab berikutnya memberi kita alat untuk mengoptimalkan di dunia yang tidak pasti.**
:::
## Rangkuman
Dalam bab ini kita telah:
- **Mengenali struktur jaringan** dalam masalah optimasi—node, arc, flow, supply, demand.
- **Memformulasikan transportation problem** untuk distribusi barang dari gudang ke toko dengan biaya minimum.
- **Menerapkan assignment problem** untuk penugasan sales ke wilayah dengan efektivitas maksimum.
- **Memahami minimum cost flow** sebagai kerangka umum untuk semua masalah jaringan.
- **Memformulasikan multi-objective optimization** ketika keputusan memiliki tujuan yang bertentangan.
- **Menghasilkan Pareto frontier** dengan metode weighted sum—dan memahami bahwa setiap titik mewakili preferensi yang berbeda.
- **Mengidentifikasi knee point** sebagai titik trade-off yang seimbang.
- **Menyadari batas optimasi deterministik**: ketidakpastian parameter masih belum ditangani—topik Bab 17.
## Jembatan ke Bab 17
Kita telah membangun **gudang alat optimasi** yang lengkap:
| Bab | Alat | Kapan dipakai |
|---|---|---|
| 14 | Linear Programming | Variabel kontinu, hubungan linear |
| 15 | Integer/Binary Programming | Variabel diskrit, keputusan ya/tidak |
| 15 | Nonlinear Programming | Hubungan nonlinear |
| 16 | Network Optimization | Aliran melalui jaringan |
| 16 | Multi-Objective | Tujuan yang bertentangan |
Tetapi semua alat ini bekerja di **dunia yang pasti**—di mana parameter diketahui dengan pasti. **Dunia nyata tidak pasti.**
**Bab 17** akan menjembatani gap ini dengan **simulasi keputusan**:
- Menggabungkan **simulasi Monte Carlo** (Bab 12) dengan **optimasi** (Bab 14–16).
- Mengevaluasi keputusan berdasarkan **distribusi hasil**, bukan hanya ekspektasi.
- Menghasilkan keputusan yang **robust**—bekerja baik di berbagai skenario, bukan hanya optimal di satu skenario.
Ini adalah **puncak Bagian III**—dan pintu masuk ke **Bab 18**, di mana kita akan mengintegrasikan semuanya dalam satu proyek end-to-end.