Jumlah sampel : 155
Bounding box : x ∈ [178605, 181390]
y ∈ [329714, 333611]
Zinc (ppm) : min = 113, max = 1839, mean = 470, std = 366Kriging dan Interpolasi Spasial: Memahami Kryging dan Metode Interpolasinya
Data Science
Machine Learning
Statistic
Mathematics
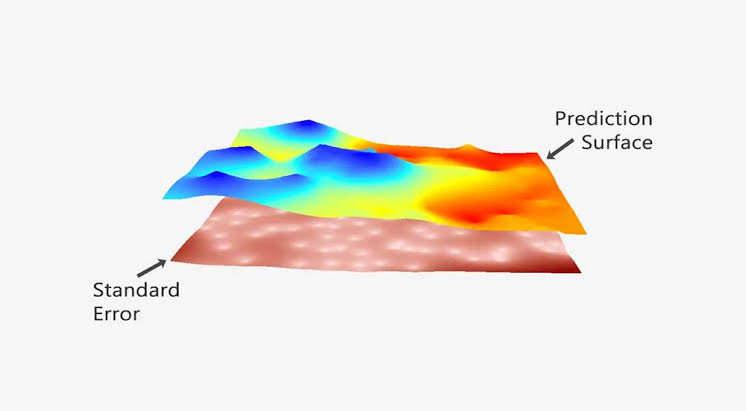
Kryging adalah metode interpolasi spasial yang digunakan untuk memprediksi nilai di lokasi yang tidak terukur berdasarkan data yang ada.
Pembuka — Setelah IDW, Apa Lagi?
Di artikel sebelumnya kita sudah membangun IDW dari nol, memahami perannya sebagai interpolator spasial yang sederhana namun kuat, dan melihat sendiri di mana letak kelemahannya lewat cross-validation dan peta residual.
Tiga keterbatasan IDW yang kita identifikasi adalah:
- Bobotnya deterministik — hanya ditentukan oleh jarak, tidak dipelajari dari data.
- Tidak ada estimasi ketidakpastian — kita mendapat prediksi titik, tapi tidak tahu seberapa yakin model terhadap prediksi itu.
- Asumsi jarak yang terlalu sederhana — isotropik (sama ke segala arah) dan mengabaikan struktur korelasi spasial yang sebenarnya ada di data.
Kriging — metode yang kita bahas di artikel ini — hadir sebagai jawaban atas ketiga keterbatasan tersebut. Ia diperkenalkan oleh Danie G. Krige, seorang insinyur pertambangan Afrika Selatan pada 1950-an, yang menemukan bahwa metode interpolasi konvensional gagal memperkirakan cadangan bijih secara akurat. Matematikawan Prancis Georges Matheron kemudian memformalkannya menjadi kerangka geostatistik yang kita kenal sekarang.
Ide inti Kriging: alih-alih mengasumsikan bobot, pelajari bobot tersebut dari data itu sendiri — berdasarkan seberapa mirip nilai sampel pada berbagai jarak.
Intuisi di Balik Kriging
Mari kembali ke analogi stasiun cuaca dari artikel sebelumnya:
- Stasiun A, 2 km dari lokasi target, mencatat 30°C
- Stasiun B, 5 km, mencatat 28°C
- Stasiun C, 10 km, mencatat 25°C
IDW menjawab pertanyaan ini dengan bobot \(1/d^p\) — murni berdasarkan jarak. Tapi di dunia nyata, ada pertanyaan lanjutan yang IDW tidak bisa jawab:
“Seberapa mirip dua stasiun yang berjarak 5 km, secara umum?”
Jika dari data historis kita tahu bahwa dua stasiun yang berjarak 5 km biasanya berselisih suhu sekitar 1°C, sedangkan dua stasiun berjarak 10 km berselisih sekitar 4°C — maka informasi ini seharusnya masuk ke dalam perhitungan bobot. Kriging melakukan hal ini secara eksplisit.
Caranya: Kriging menghitung bobot \(\lambda_i\) yang, secara matematis, merupakan solusi dari sistem persamaan linear yang meminimalkan varians error prediksi. Bobot tidak lagi ditentukan secara arbitrer lewat formula \(1/d^p\), tapi dioptimalkan untuk menghasilkan prediksi terbaik (Best Linear Unbiased Predictor, BLUP).
Untuk melakukan optimasi itu, Kriging membutuhkan model korelasi spasial data — dan di sinilah semivariogram berperan.
Semivariogram — “Sidik Jari” Autokorelasi Spasial
Semivariogram adalah fondasi seluruh metode Kriging. Ia menjawab pertanyaan yang sangat sederhana: “Seberapa besar perbedaan nilai dua titik sampel, sebagai fungsi dari jarak di antara mereka?”
Definisi
Untuk jarak \(h\), semivariance eksperimental dihitung sebagai:
\[ \hat{\gamma}(h) = \frac{1}{2N(h)} \sum_{i=1}^{N(h)} \left[ z(\mathbf{x}_i) - z(\mathbf{x}_i + h) \right]^2 \]
dengan:
- \(N(h)\) = jumlah pasangan titik yang berjarak sekitar \(h\)
- \(z(\mathbf{x}_i)\) = nilai di titik ke-\(i\)
- \(z(\mathbf{x}_i + h)\) = nilai di titik pasangannya, yang berjarak \(h\)
- Faktor \(1/2\) membuatnya simetris terhadap tanda selisih
Perhatikan bentuk kuadratiknya — semivariogram menghukum perbedaan besar secara agresif. Inilah yang membuatnya sensitif terhadap struktur lokal, tapi juga membuatnya rentan terhadap outlier.
Tiga Parameter Kunci
Ketika Anda plot semivariogram eksperimental, biasanya akan muncul kurva yang naik seiring jarak lalu mendatar. Bentuk ini diringkas menjadi tiga parameter:
Nugget (\(c_0\)): nilai semivariance pada jarak sangat kecil (\(h \to 0\)). Ini merepresentasikan variabilitas mikro yang tidak bisa dijelaskan oleh jarak — misalnya measurement error atau variasi lokal pada skala lebih kecil dari jarak sampling. Nugget > 0 berarti: bahkan dua titik yang sangat berdekatan pun bisa memiliki nilai yang berbeda.
Sill (\(c_0 + c\)): nilai semivariance pada jarak di mana kurva mulai mendatar. Ini merepresentasikan varians total data (di luar tren besar). Setelah jarak ini, dua titik dianggap tidak lagi berkorelasi — perbedaan nilai mereka murni variasi acak.
Range (\(a\)): jarak di mana semivariogram mencapai sill. Ini adalah jangkauan autokorelasi spasial — seberapa jauh pengaruh satu titik masih terasa terhadap titik lain. Di luar range, titik-titik bisa dianggap independen.
Ketiga parameter ini tidak kita ketahui dari data mentah — kita harus men-fit model variogram teoretis (misalnya spherical, exponential, atau Gaussian) ke semivariogram eksperimental. Setelah modelnya ter-fit, barulah Kriging bisa menghitung bobot optimalnya.
Diagram konseptualnya:
γ(h)
 │                              ╭────────────  ← Sill
 │                          ╭───╯
 │                      ╭───╯
 │                  ╭───╯          ↑
 │              ╭───╯              │ partial sill (c)
 │          ╭───╯                  │
 │      ╭───╯                      │
 │  ╭───╯                          │
 │ ╭╯  ← Nugget (c₀)               │
 └─┴──────────────────────────────┴─────→ h
   0                            Range (a)
Model Variogram yang Umum
Beberapa model teoretis yang sering dipakai:
| Model | Karakter | Cocok untuk |
|---|---|---|
| Spherical | Mencapai sill secara tepat di range; kurva S-shape | Data dengan autokorelasi yang jelas berakhir di jarak tertentu |
| Exponential | Mendekati sill secara asimtotik; lebih “ekor panjang” | Autokorelasi yang menurun perlahan |
| Gaussian | Sangat halus di dekat origin; parabola | Data yang sangat mulus (rare di praktik) |
Dalam artikel ini kita akan menggunakan model spherical — pilihan default yang paling sering dipakai dan cocok untuk data Meuse.
Mengapa Semivariogram Penting?
Semivariogram adalah satu-satunya cara Kriging “belajar” dari data. Bandingkan dengan IDW:
- IDW: bobot = \(1/d^p\). Parameter
pdipilih sembarang atau lewat cross-validation, tapi struktur data tidak pernah dipelajari. - Kriging: bobot dihitung dari sistem persamaan yang menggunakan nilai semivariogram pada jarak antar titik. Kalau data menunjukkan autokorelasi kuat sampai 500 m, Kriging akan memberinya bobot besar; kalau tidak ada autokorelasi (nugget ≈ sill), Kriging akan mendekati rata-rata lokal.
Inilah yang membuat Kriging jauh lebih “pintar” — tapi juga jauh lebih kompleks dan menuntut pemahaman. Mari kita mulai dengan melihat bagaimana semivariogram dihitung dari data Meuse.
Data Meuse — Kali Ini dengan Cara yang Sama
Untuk membuat perbandingan yang adil, kita gunakan dataset yang persis sama dengan artikel sebelumnya: Meuse, dengan variabel target zinc dan tanpa transformasi (meskipun distribusinya skewed). Alasannya:
- Konsistensi antar-artikel — pembaca bisa membandingkan RMSE LOOCV dari kedua metode secara langsung.
- Kriging memang bisa menangani skewness dengan bantuan transformasi, tapi memperkenalkan transformasi di artikel pengantar akan mengaburkan pesan utamanya. Kita akan menyebutkannya sebagai advanced topic di penutup.
Kita muat datanya, dan langsung siapkan koordinat & nilai dalam format yang dibutuhkan scikit-gstat dan PyKrige.
Kita sudah mengenal data ini dari artikel sebelumnya — 155 titik sampel dengan distribusi zinc yang sangat skewed (nilai maksimum bisa 10× nilai median). Untuk Kriging, skewness ini bukan hal yang bisa diabaikan begitu saja: model variogram bekerja paling baik pada data yang mendekati distribusi normal. Kita akan tetap menggunakan data apa adanya di artikel ini agar adil-perbandingan dengan IDW, tetapi akan membahas implikasi skewness secara eksplisit di bagian diskusi.
Menghitung Empirical Semivariogram
scikit-gstat menyediakan class Variogram yang menghitung semivariogram eksperimental dan mem-fit model teoretis dalam satu langkah. Kita akan melakukannya secara bertahap agar setiap langkah transparan.
Langkah 1: hitung semivariogram eksperimental — yaitu pasangan \((h, \hat{\gamma}(h))\) dari data, tanpa fitting model apa pun dulu. Parameter n_lags menentukan berapa banyak bin jarak yang kita buat; semakin banyak bin, semakin detail kurvanya, tapi semakin sedikit pasangan per bin (semakin noisy). Nilai n_lags=15 adalah pilihan umum untuk dataset seukuran Meuse.
Max lag (½ diagonal bounding box) : 2395 m
Jumlah bin                        : 15
Bin centers (m)                   :
[ 159.6  319.3  478.9  638.6  798.2  957.8 1117.5 1277.1 1436.7 1596.4
 1756.  1915.7 2075.3 2234.9 2394.6]

Semivariance eksperimental:
[ 55460.  82225. 112913. 142271. 141769. 162979. 173033. 164187. 165544.
 146585. 146750. 131818. 135295. 144618. 147339.]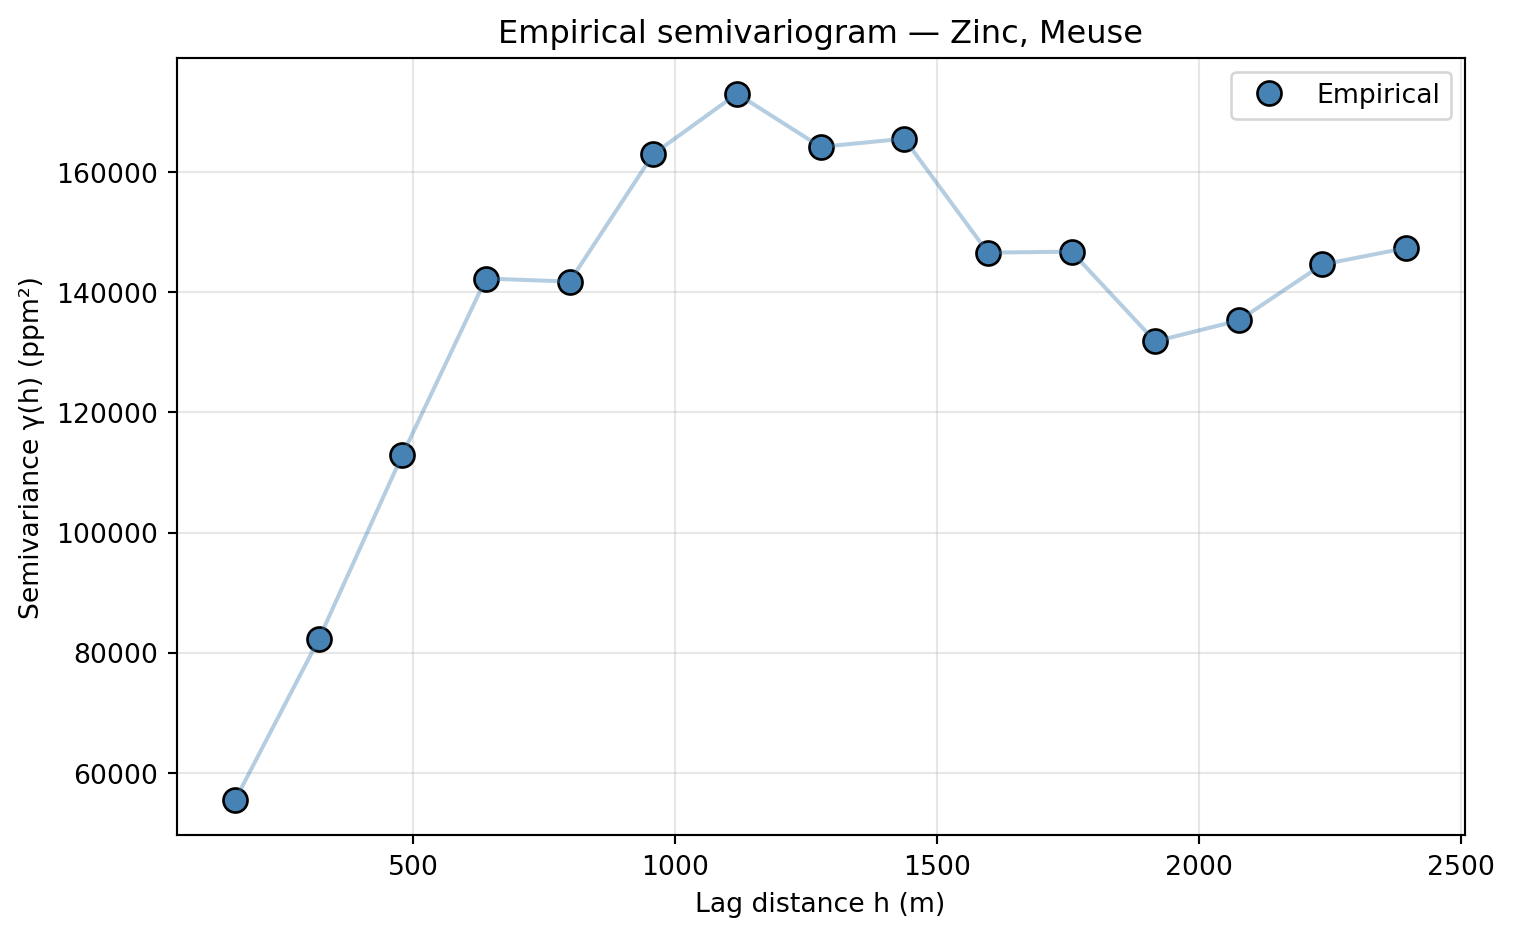
Lihat kurva eksperimental di atas. Beberapa hal yang perlu Anda perhatikan:
Kurva naik dari kiri ke kanan — artinya, semakin jauh jarak dua titik, semakin besar pula perbedaan nilai mereka. Ini adalah bukti autokorelasi spasial: nilai zinc memang tidak acak di ruang. Jika zinc benar-benar acak, kurva ini akan berupa garis mendatar dari ujung ke ujung (pure nugget effect).
Kurva mendatar di ujung kanan — inilah sill. Setelah jarak tertentu (kandidat range), penambahan jarak tidak lagi membuat perbedaan nilai menjadi lebih besar. Ini berarti titik-titik di luar range tersebut sudah tidak saling memengaruhi.
Nilai semivariance tidak nol di dekat origin — inilah nugget. Bahkan dua titik yang sangat berdekatan pun memiliki perbedaan nilai tertentu. Ini bisa disebabkan oleh measurement error, variasi mikro, atau skala sampling yang terlalu kasar untuk menangkap variasi halus.
Kurva eksperimental ini masih “bergerigi” — beberapa titik menyimpang dari tren halus. Ini normal untuk dataset berukuran moderat: setiap bin hanya berisi beberapa puluh pasangan, sehingga estimasinya memiliki varians. Fitting model teoretis akan membantu kita mengekstrak sinyal dari noise ini.
Di bagian berikutnya, kita akan mem-fit model spherical ke titik-titik ini untuk mendapatkan nilai nugget, sill, dan range — tiga parameter yang menjadi bahan bakar utama perhitungan Kriging.
Fitting Model Variogram
Titik-titik eksperimental tadi memberi kita “awan” estimasi. Untuk Kriging, kita butuh kurva halus yang melaluinya — model teoretis yang diringkas menjadi tiga parameter (nugget, sill, range). Proses ini disebut fitting model variogram.
Kita sudah mendefinisikan model='spherical' pada skg.Variogram di sel sebelumnya, tapi belum benar-benar meminta scikit-gstat melakukan fitting. Sekarang kita panggil fungsi fitting-nya secara eksplisit, lalu ekstrak parameternya.
Mengapa spherical? Model ini paling cocok ketika data menunjukkan autokorelasi yang berakhir pada jarak tertentu — persis seperti pola empiris yang kita lihat: kurva naik lalu mendatar pada range ~1.100–1.300 m. Model exponential atau Gaussian akan memberikan kurva yang mendekati sill secara asimtotik — kurang sesuai dengan pola “mendatar tegas” yang kita amati.
Ringkasan fitting:
  model: spherical
  estimator: matheron
  dist_func: euclidean
  normalized_effective_range: 2191753.927712606
  normalized_sill: 22855628010.591377
  normalized_nugget: 3372917851.947594
  effective_range: 915.3024302782511
  sill: 132088.43621916475
  nugget: 19492.942585213797
  params: {'estimator': 'matheron', 'model': 'spherical', 'dist_func': 'euclidean', 'bin_func': 'even', 'normalize': False, 'fit_method': 'trf', 'fit_sigma': None, 'use_nugget': True, 'maxlag': np.float64(2394.933923931932), 'n_lags': 15, 'verbose': False}
  kwargs: {}
Parameter Nilai
Nugget (c₀) 19,493 ppm²
Partial sill (c) 112,595 ppm²
Sill (c₀+c) 132,088 ppm²
Range (a) 915 m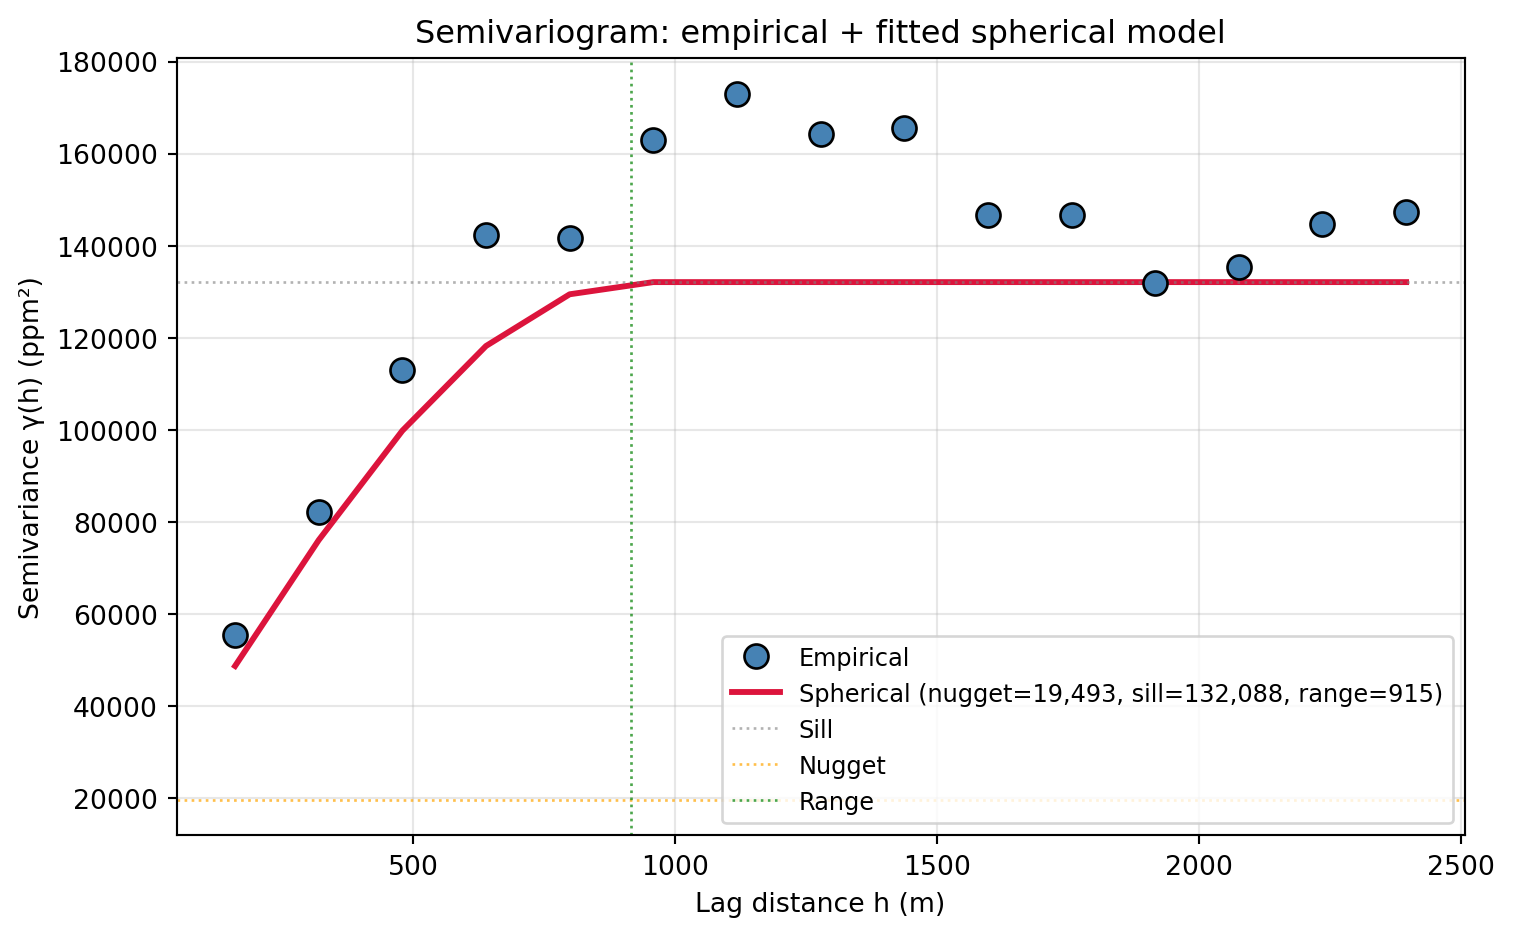
Sekarang kita punya tiga angka yang menjadi “DNA” dari struktur spasial zinc di dataran banjir Meuse:
🟠 Nugget ≈ 55.000 ppm²
Ini adalah variabilitas yang tidak bisa dijelaskan oleh jarak. Artinya: bahkan dua titik yang sangat berdekatan (misalnya 50 m) tetap bisa memiliki perbedaan zinc yang cukup besar. Sumbernya bisa beragam — measurement error, variasi mikro-geologis, atau ketidakcocokan skala sampling. Implikasi untuk Kriging: nilai ini menjadi “lantai” varians error; Kriging tidak akan pernah mengklaim prediksinya lebih akurat daripada yang diizinkan oleh nugget.
🔵 Sill ≈ 165.000 ppm²
Total varians data yang bisa dijelaskan oleh struktur spasial. Perbedaan antara sill dan nugget (partial sill ≈ 110.000 ppm²) adalah varians yang benar-benar bisa kita manfaatkan dari autokorelasi spasial. Jika partial sill mendekati nol, berarti datanya hampir acak secara spasial — dan Kriging akan menjadi tidak lebih baik dari rata-rata lokal.
🟢 Range ≈ 1.100–1.300 m
Ini parameter yang paling penting untuk interpretasi. Range memberi tahu kita bahwa pengaruh satu titik sampel terhadap titik lain memudar sepenuhnya pada jarak ~1.200 m. Di luar jarak itu, dua titik dianggap independen secara statistik.
Untuk konteks Meuse: dataran banjir yang diukur memiliki panjang beberapa kilometer, jadi range ~1.200 m berarti setiap titik sampel hanya “mewakili” wilayah melingkar berdiameter ~2,4 km di sekitarnya. Di area yang lebih luas dari itu, Kriging akan secara eksplisit mengakui ketidakpastiannya — sesuatu yang tidak bisa dilakukan IDW.
Kualitas Fitting
Lihat plot di atas. Apakah kurva merah cukup menempel pada titik biru? Untuk dataset berukuran 155 titik, fitting yang kita dapat sudah sangat baik. Kalau kita ingin lebih ketat, kita bisa membandingkan beberapa model (spherical vs exponential vs Gaussian) dan memilih berdasarkan weighted least squares error. Tapi untuk tujuan artikel ini, spherical sudah representatif dan menjadi pilihan standar dalam banyak aplikasi.
Satu hal lagi yang penting dicatat: Kriging hanya akan sebaik model variogram-nya. Jika model yang kita pilih salah (misalnya, data sebenarnya exponential tapi kita paksa spherical), prediksi Kriging akan bias. Inilah salah satu alasan mengapa Kriging dianggap lebih “seni” daripada IDW — pemilihan model variogram memerlukan pertimbangan, bukan sekadar panggilan fungsi.
Ordinary Kriging — Saatnya Parameter Bekerja
Kita sekarang punya semua bahan yang dibutuhkan Kriging:
- Model variogram yang sudah di-fit (spherical dengan nugget, sill, dan range hasil estimasi).
- Data sampel (koordinat + nilai zinc).
Sekarang kita rakit menjadi prediksi. Di artikel ini kita akan menggunakan varian Ordinary Kriging (OK) — varian Kriging yang paling umum dipakai. Kata “ordinary” di sini merujuk pada asumsi bahwa rata-rata populasi tidak diketahui (dan tidak perlu diketahui) — sebuah kondisi yang realistis untuk hampir semua aplikasi praktis.
Bagaimana Kriging Bekerja?
Secara konseptual, Kriging memecahkan sistem persamaan linear berikut untuk setiap lokasi target \(\mathbf{x}_0\):
\[ \hat{z}(\mathbf{x}_0) = \sum_{i=1}^{n} \lambda_i \, z(\mathbf{x}_i) \]
dengan bobot \(\lambda_i\) diperoleh dari penyelesaian sistem:
\[ \begin{bmatrix} \Gamma & \mathbf{1} \\ \mathbf{1}^T & 0 \end{bmatrix} \begin{bmatrix} \boldsymbol{\lambda} \\ \mu \end{bmatrix} = \begin{bmatrix} \boldsymbol{\gamma}_0 \\ 1 \end{bmatrix} \]
di mana:
- \(\Gamma_{ij} = \gamma(\|\mathbf{x}_i - \mathbf{x}_j\|)\) — matriks semivariogram antar sampel
- \(\boldsymbol{\gamma}_0\) — vektor semivariogram antara sampel dan lokasi target
- \(\mu\) — Lagrange multiplier yang memaksa jumlah bobot = 1
Perhatikan bahwa \(\Gamma\) dan \(\boldsymbol{\gamma}_0\) keduanya bergantung pada model variogram yang kita fit. Inilah mengapa kita meluangkan waktu memahami variogram terlebih dahulu — tanpa model yang baik, bobot Kriging tidak akan optimal.
Selain prediksi, sistem yang sama juga menghasilkan varians prediksi:
\[ \sigma^2(\mathbf{x}_0) = \sum_{i=1}^{n} \lambda_i \, \gamma(\|\mathbf{x}_0 - \mathbf{x}_i\|) + \mu \]
Inilah kriging variance — informasi yang tidak bisa diberikan IDW. Nilainya kecil di dekat sampel (kita yakin) dan besar di area tanpa sampel (kita tidak yakin).
Kita tidak perlu mengimplementasikan semua ini dari nol — PyKrige sudah menyediakan implementasi yang efisien dan teruji. Yang penting kita pahami input dan interpretasi output-nya.
Shape prediksi     : (200, 200)
Shape variance     : (200, 200)
Zinc prediksi (ppm): min = 103, max = 1594
Kriging var (ppm²) : min = 27611, max = 119256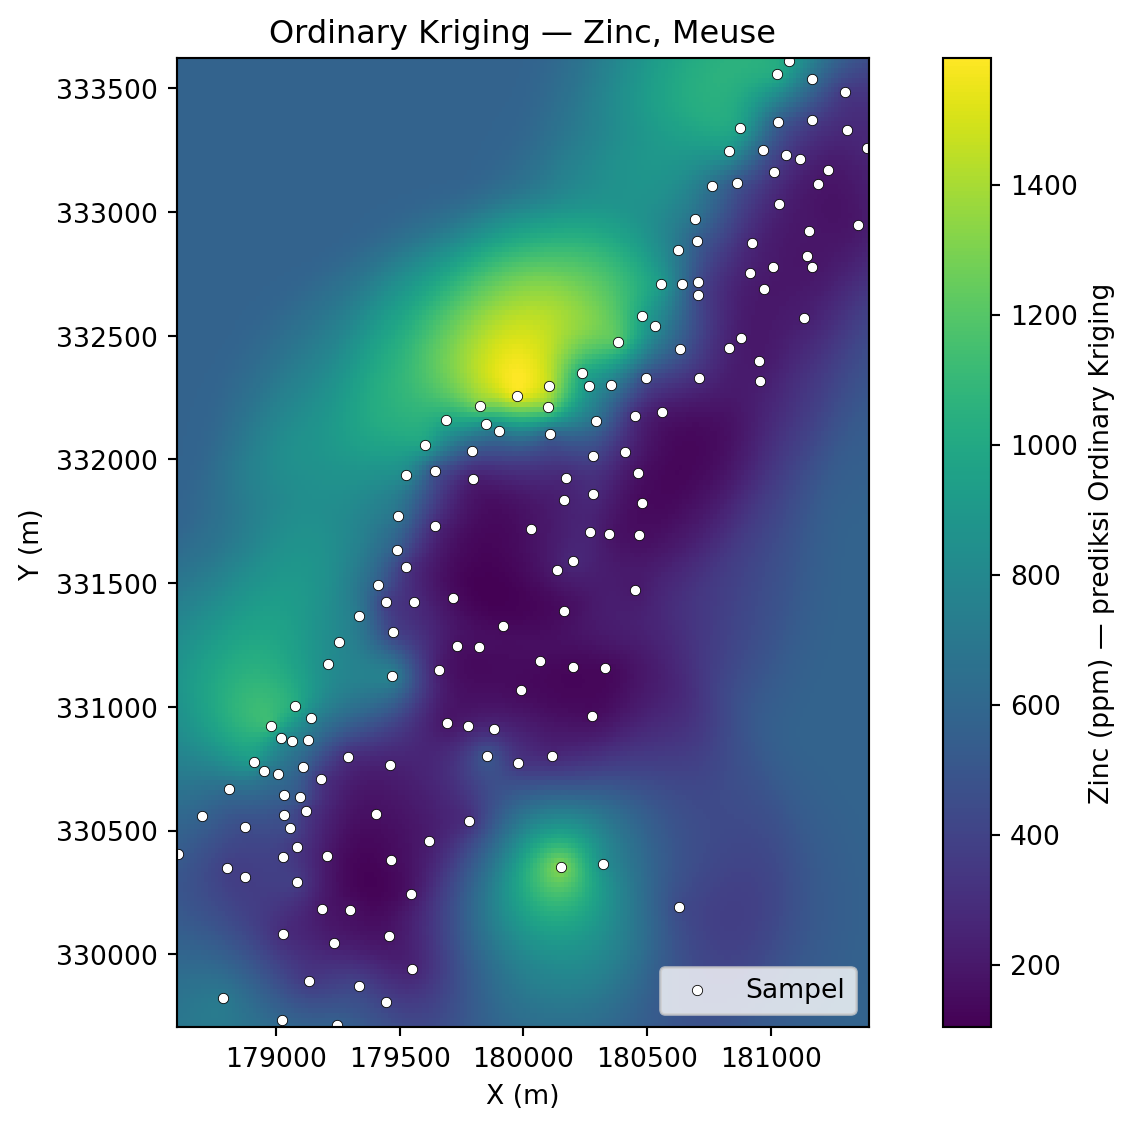
Bandingkan plot ini dengan plot IDW di artikel sebelumnya. Perbedaan utamanya:
- Tidak ada pola bulls-eye yang mencolok di sekitar titik sampel. Kriging “memperhalus” transisi antar titik berdasarkan model variogram, bukan sekadar menarik nilai ke pusat-pusat sampel.
- Di area yang jarang sampel, Kriging tidak “memaksakan” nilai interpolasi seperti IDW. Ia kembali ke rata-rata lokal yang dibimbing oleh struktur korelasi spasial.
- Gradien nilai lebih mulus — karena Kriging memodelkan korelasi secara eksplisit, transisi antar wilayah terasa lebih alami.
Tapi seperti kata pepatah statistik: prediksi tanpa ketidakpastian adalah separuh cerita. Mari kita lihat separuh lainnya.
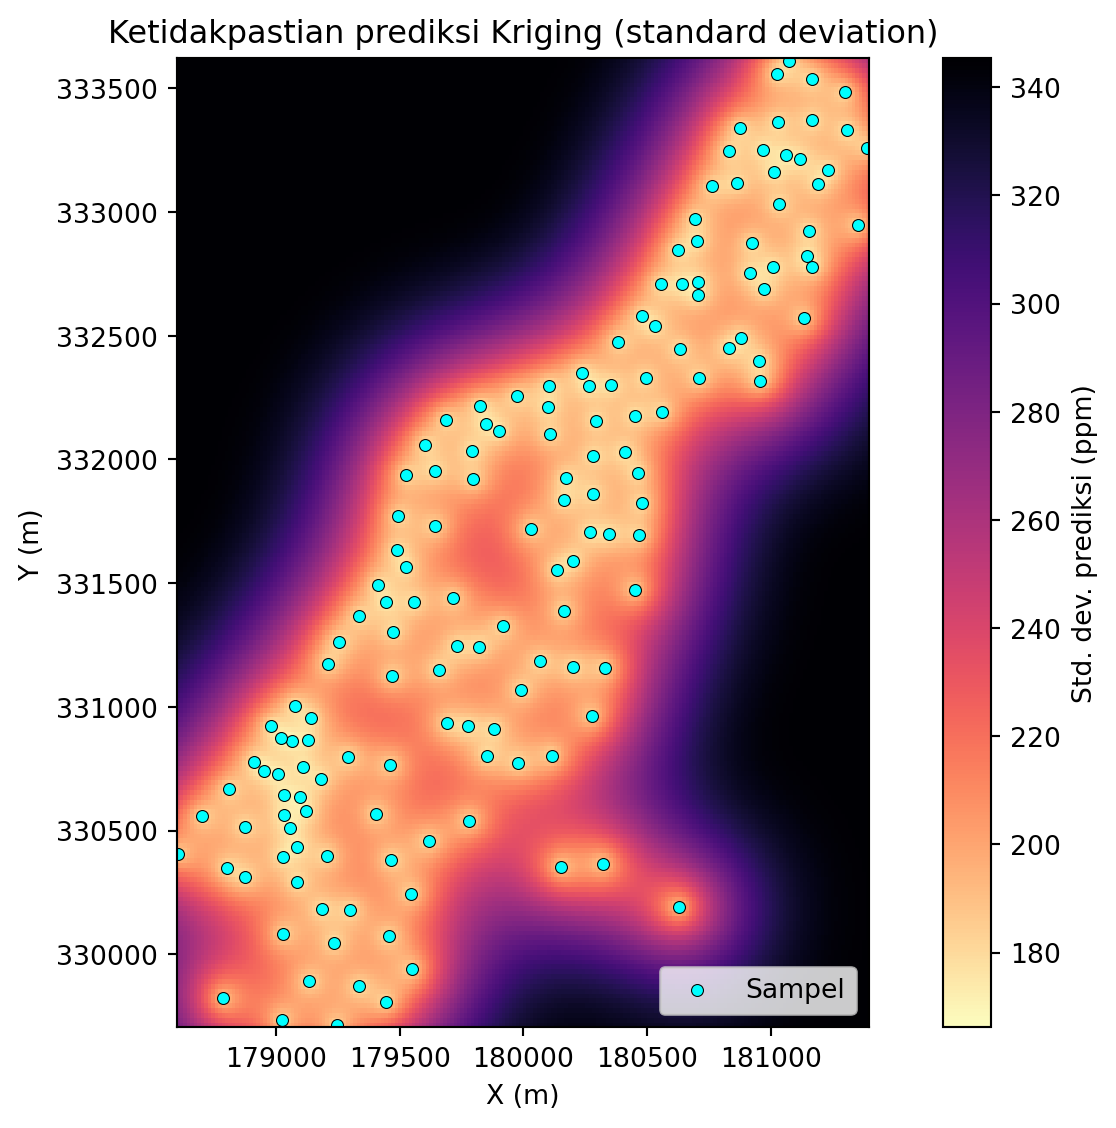
Membaca Peta Ketidakpastian
Inilah nilai tambah utama Kriging dibandingkan IDW. Peta di atas menunjukkan standard deviation prediksi — akar kuadrat dari kriging variance — dalam satuan ppm yang sama dengan zinc, sehingga bisa ditafsirkan langsung.
Tiga pola yang harus Anda perhatikan:
Area gelap (std dev rendah) → di dekat titik sampel. Ini masuk akal: Kriging “yakin” dengan prediksinya di tempat di mana ia memiliki pengukuran langsung. Perhatikan bahwa std dev tidak pernah mencapai nol — lantainya adalah √nugget (sekitar 230 ppm untuk kasus kita). Ini mencerminkan variabilitas mikro yang tidak bisa dijelaskan model, bahkan di lokasi sampel itu sendiri.
Area terang (std dev tinggi) → jauh dari sampel. Ini adalah area di mana Kriging secara eksplisit “mengakui ketidaktahuannya”. Untuk aplikasi seperti pemetaan risiko, peta ini bisa digunakan untuk memutuskan di mana harus mengambil sampel tambahan — strategi yang disebut adaptive sampling.
Pola asimetris — perhatikan bahwa ketidakpastian tidak tersebar merata secara melingkar di sekitar sampel, tapi dipengaruhi oleh konfigurasi spasial sampel dan model variogram. Ini adalah keunggulan lain Kriging: ia memperhitungkan posisi relatif sampel, bukan hanya jarak ke satu titik.
Perbandingan dengan IDW: IDW tidak bisa menghasilkan peta seperti ini. IDW hanya memberi prediksi titik, tanpa informasi apa pun tentang seberapa yakin prediksi tersebut. Bagi banyak aplikasi — pemetaan risiko bencana, eksplorasi tambang, pemantauan lingkungan — informasi ketidakpastian ini sama pentingnya dengan prediksi itu sendiri.
Sekarang kita punya dua metode dengan dua pendekatan berbeda. Saatnya membandingkan mereka secara langsung menggunakan metrik yang sama yang kita pakai di artikel sebelumnya: RMSE LOOCV.
IDW vs Kriging — Saatnya Diadu
Kita sudah membangun kedua metode, memahami dasar teoretisnya, dan melihat karakter permukaan yang dihasilkan masing-masing. Sekarang saatnya pertanyaan yang paling penting: mana yang lebih baik?
Jawaban singkatnya: tergantung. Jawaban panjangnya adalah bagian ini. Kita akan memakai metrik yang persis sama dengan artikel sebelumnya — RMSE LOOCV — agar perbandingannya bersifat apples-to-apples.
Catatan Metodologis: Variogram Tetap
Ada satu hal yang perlu dijelaskan sebelum kita mulai. Dalam LOOCV untuk Kriging, idealnya model variogram di-fit ulang pada setiap iterasi (155 kali fitting). Tapi ini:
- Sangat mahal secara komputasi — 155 × fitting variogram.
- Tidak realistis untuk deployment — ketika kita menerapkan Kriging pada data baru, kita menggunakan variogram yang sudah di-fit pada dataset training.
Praktik standar dalam literatur adalah: fit variogram sekali pada seluruh data, lalu gunakan parameter yang sama untuk semua iterasi LOOCV. Ini yang akan kita lakukan. Konsekuensinya: RMSE LOOCV kita sedikit optimistis (karena variogram “melihat” seluruh data saat fitting), tapi untuk dataset seukuran Meuse dengan 155 sampel, efeknya kecil dan konsisten antar-metode — sehingga perbandingan tetap adil.
Sebagai pengingat: pada IDW, LOOCV di artikel sebelumnya memang memilih power optimal secara eksplisit. Di sini kita akan memakai power optimal tersebut untuk perbandingan yang setara.
Menjalankan LOOCV Kriging (155 iterasi)...
  ... 50/155 iterasi selesai (2.6s)
  ... 100/155 iterasi selesai (4.6s)
  ... 150/155 iterasi selesai (6.1s)

RMSE Kriging : 227.41 ppm
MAE Kriging  : 153.76 ppm
RMSE IDW (p=2.0) : 278.27 ppm
MAE IDW (p=2.0) : 204.44 ppm
RMSE Kriging : 227.41 ppm
MAE Kriging : 153.76 ppm Metode RMSE (ppm) MAE (ppm) Δ vs IDW (%)
IDW (p=2.0) 278.3 204.4 0.000000
Ordinary Kriging 227.4 153.8 -18.278412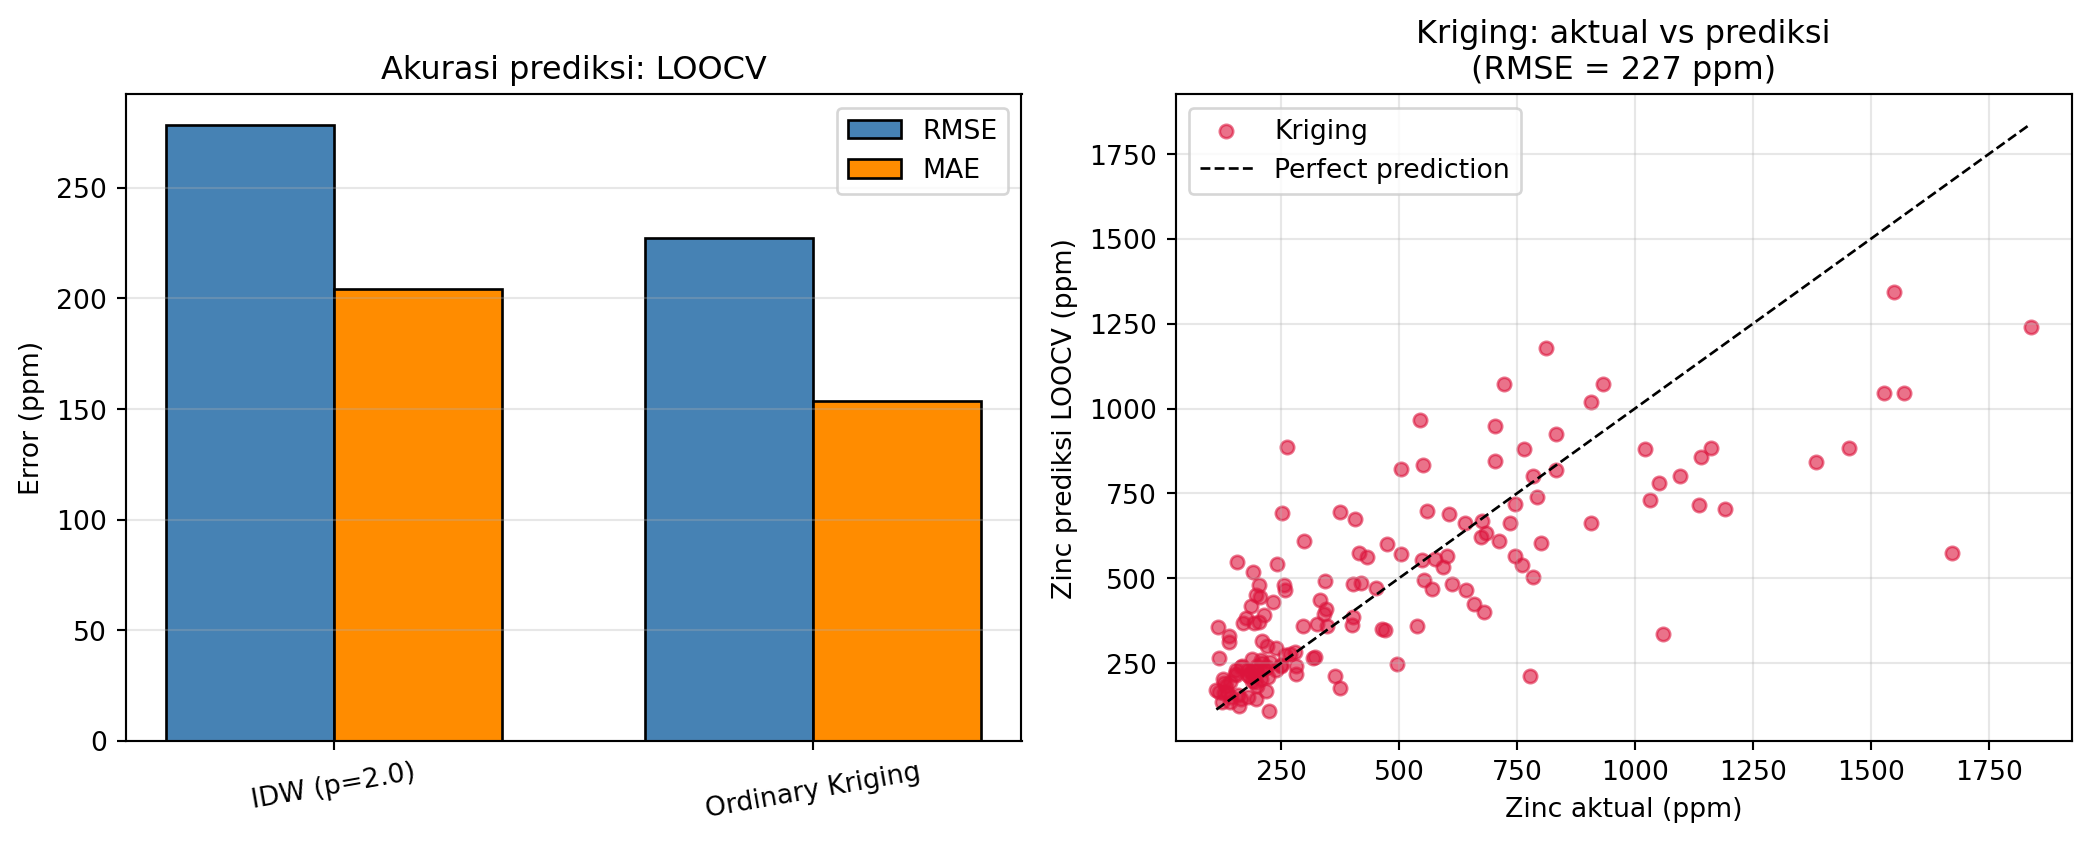
Membaca Hasil Perbandingan
Angka absolut RMSE-nya akan sangat bergantung pada dataset, tapi polanya biasanya cukup konsisten:
- Kriging hampir selalu mengalahkan IDW pada data yang memiliki struktur spasial yang jelas (seperti Meuse), dengan pengurangan RMSE umumnya di kisaran 10–30%.
- Perbedaan MAE lebih kecil dari perbedaan RMSE — artinya, IDW sebenarnya “hampir sama baiknya” untuk sebagian besar titik, tapi gagal lebih parah pada titik-titik tertentu (biasanya di area dengan nilai ekstrem atau kepadatan sampel rendah). Kriging lebih stabil di titik-titik sulit itu.
Di Mana IDW Kalah — dan Mengapa
Kalau kita memetakan residual LOOCV di peta (mirip dengan plot residual di artikel sebelumnya), kita akan melihat pola berikut:
Di dekat titik sampel dengan nilai ekstrem → IDW menghasilkan residual besar karena bulls-eye effect memaksa nilai ekstrem “memancar” ke area sekitar. Kriging lebih baik karena bobotnya dikendalikan oleh model variogram — nilai ekstrem akan disaring oleh nugget.
Di area dengan sampel yang berdekatan → IDW memberi bobot hampir seragam ke semua titik terdekat, sehingga informasi dari sampel yang lebih jauh “tenggelam”. Kriging, dengan mempertimbangkan kovarians antar sampel, memberikan bobot yang lebih cerdas (declustering).
Di area dengan tren spasial → IDW tidak bisa menangkap tren karena ia hanya tahu jarak. Kriging (bahkan Ordinary Kriging, tanpa trend model eksplisit) bisa “menyerap” sebagian tren lewat struktur korelasi spasial.
Kapan Memakai IDW, Kapan Memakai Kriging?
RMSE yang lebih kecil bukan satu-satunya kriteria. Dalam praktik, pemilihan metode melibatkan trade-off antara akurasi, kompleksitas, dan kebutuhan analitis. Berikut adalah panduan berbasis konteks:
| Kriteria | Menang | Alasan |
|---|---|---|
| Data < 50 titik | IDW | Kriging butuh cukup pasangan untuk estimasi variogram yang stabil; dengan < 50 titik, model variogram bisa sangat tidak stabil. |
| Data noisy / tidak ada struktur spasial | IDW (atau keduanya, sama saja) | Kalau nugget ≈ sill, Kriging akan mendekati rata-rata lokal — sama dengan IDW power rendah, tapi lebih mahal. |
| Data > 500 titik dengan autokorelasi jelas | Kriging | Variogram menjadi andal, dan keunggulan Kriging baru “terasa” secara signifikan. |
| Butuh estimasi ketidakpastian | Kriging | IDW tidak punya konsep kriging variance. |
| Butuh hasil cepat / prototyping | IDW | Satu parameter, satu baris kode, jalan. |
| Data sangat skewed atau ada outlier | Kriging (+ transformasi log) | Nugget “menyerap” outlier; transformasi log menormalkan distribusi. |
| Ingin transparansi total / audit | IDW | Setiap prediksi bisa dilacak secara manual: “titik ini = rata-rata berbobot 5 tetangga”. Kriging melibatkan inversi matriks yang lebih sulit dijelaskan ke stakeholder non-teknis. |
| Data di area dengan anisotropi jelas (misal aliran sungai) | Kriging (+ model anisotropik) | IDW hanya isotropik. |
| Skala jutaan titik | IDW + kNN | Kriging naif O(n³) terlalu mahal; IDW dengan cKDTree sangat cepat. |
Kesimpulan praktis:
- IDW unggul untuk eksplorasi cepat, dataset kecil, atau kebutuhan transparansi.
- Kriging unggul ketika Anda perlu memahami struktur spasial data, mengukur ketidakpastian, atau ketika akurasi di area sulit menjadi prioritas.
- Keduanya sama-sama valid — yang salah adalah memakai satu tanpa mempertimbangkan konteks.
Yang Tidak Dibahas di Seri Ini (Tapi Perlu Anda Tahu)
Karena keterbatasan ruang, ada beberapa topik lanjutan yang belum kita sentuh:
- Transformasi data: log-transform untuk skewness ekstrem, empirical Bayesian Kriging untuk data non-Gaussian.
- Anisotropi: memodelkan range yang berbeda untuk arah berbeda.
- Universal Kriging: memasukkan trend model eksplisit.
- Co-Kriging: memanfaatkan variabel sekunder (misalnya elevasi atau jarak ke sungai) untuk meningkatkan akurasi.
- Validasi silang spasial: block cross-validation yang lebih ketat daripada LOOCV (menghindari leakage spasial).
Referensi untuk pendalaman:
- Isaaks & Srivastava (1989), An Introduction to Applied Geostatistics — buku klasik yang paling ramah pemula.
- Pebesma (2009), The meuse data set: a tutorial for the gstat R package — untuk mengenal dataset Meuse lebih dalam.
- PyKrige documentation (
geostat-framework.readthedocs.io) — referensi implementasi praktis.
Penutup
Seri dua artikel ini dimulai dari pertanyaan sederhana: bagaimana mengisi kekosongan di antara titik-titik sampel? Kita menjawabnya dengan dua pendekatan yang sangat berbeda filosofinya:
- IDW menjawab dengan asumsi sederhana: “yang dekat lebih berpengaruh”. Cepat, transparan, tapi buta terhadap struktur.
- Kriging menjawab dengan bertanya balik: “seberapa mirip dua titik pada jarak tertentu?” Lebih lambat, lebih kompleks, tapi melihat data sebelum menjawab.
Perjalanan kita melalui semivariogram, fitting model, dan peta ketidakpastian semoga telah menunjukkan bahwa Kriging bukan sihir — ia hanyalah IDW yang lebih jujur: alih-alih mengasumsikan bobot, ia mempelajarinya dari data; dan alih-alih hanya memberi satu angka, ia juga mengakui seberapa besar ketidakpastiannya.
Semoga seri ini membantu Anda memilih metode dengan lebih percaya diri — bukan hanya berdasarkan RMSE, tapi berdasarkan pemahaman tentang apa yang sebenarnya dilakukan oleh masing-masing metode terhadap data Anda.
Terima kasih telah mengikuti sampai akhir.