NumPy       : 2.0.1
Pandas      : 2.3.1
GeoPandas   : 1.1.4
SciKit-GStat: 1.0.22
GSTools     : 1.7.0

Meuse loaded: <class 'dict'>Inverese Distance Weighting (IDW) dan Spatial Interpolation
Data Science
Machine Learning
Statistic
Mathematics
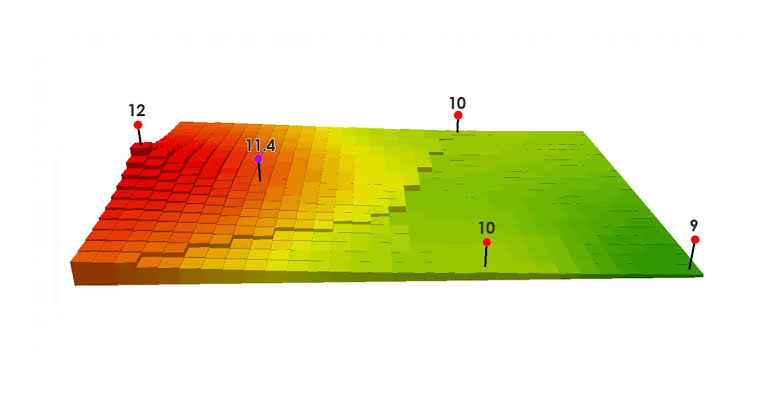
Artikel ini membahas tentang metode interpolasi spasial yang dikenal sebagai Inverse Distance Weighting (IDW). Metode ini mengasumsikan bahwa titik-titik yang lebih dekat memiliki pengaruh yang lebih besar terhadap nilai yang diperkirakan dibandingkan dengan titik-titik yang lebih jauh.
Pembuka — Masalah yang Kita Hadapi
Bayangkan Anda adalah seorang ahli lingkungan yang ditugaskan memetakan konsentrasi logam berat di sebuah dataran banjir. Anda punya dana untuk mengambil 155 sampel tanah, dan sekarang Anda memegang tabel berisi koordinat dan konsentrasi zinc di setiap titik. Pertanyaannya: bagaimana cara membuat peta penuh dari 155 titik ini?
Ini adalah masalah klasik interpolasi spasial. Kita punya nilai di sejumlah lokasi terbatas, dan ingin memperkirakan nilai di lokasi lain yang tidak terukur — dengan asumsi bahwa titik-titik yang berdekatan cenderung memiliki nilai yang mirip.
Ada banyak metode untuk melakukan ini. Dalam seri dua artikel ini, kita akan fokus pada dua yang paling sering dibandingkan:
- Inverse Distance Weighting (IDW) — sederhana, intuitif, dan cepat.
- Kriging — berbasis statistik, lebih kompleks, tapi lebih “pintar” dalam memahami struktur spasial data.
Artikel ini fokus pada IDW. Kita akan membangunnya from scratch, memahami setiap parameter, dan melihat di mana letak kekuatan sekaligus kelemahannya. Artikel berikutnya akan membahas Kriging — dan kita akan mengakhiri seri dengan perbandingan langsung kedua metode pada dataset yang sama.
Intuisi di Balik IDW
Ide IDW sangat sederhana dan intuitif: semakin dekat sebuah titik sampel ke lokasi yang ingin kita prediksi, semakin besar pengaruhnya terhadap prediksi tersebut.
Bayangkan Anda ingin memperkirakan suhu udara di suatu lokasi. Di sekitar lokasi itu ada tiga stasiun cuaca:
- Stasiun A, 2 km dari lokasi, mencatat 30°C
- Stasiun B, 5 km dari lokasi, mencatat 28°C
- Stasiun C, 10 km dari lokasi, mencatat 25°C
Perkiraan Anda wajar jika “menarik” prediksi lebih dekat ke 30°C (stasiun terdekat) daripada ke 25°C (stasiun terjauh). IDW memformalkan intuisi ini secara matematis.
Rumus dan Parameter Kunci
Secara matematis, prediksi IDW di lokasi target \(\mathbf{x}_0\) adalah:
\[ \hat{z}(\mathbf{x}_0) = \frac{\sum_{i=1}^{n} w_i \, z(\mathbf{x}_i)} {\sum_{i=1}^{n} w_i}, \qquad w_i = \frac{1}{d(\mathbf{x}_0, \mathbf{x}_i)^p} \]
dengan:
- \(z(\mathbf{x}_i)\) = nilai yang terukur di sampel ke-\(i\)
- \(d(\mathbf{x}_0, \mathbf{x}_i)\) = jarak antara lokasi target dan sampel
- \(p\) = power parameter (biasanya 2), mengatur seberapa agresif pengaruh jarak
- \(n\) = jumlah sampel yang digunakan
Ada tiga hal yang perlu dicatat:
power = 0→ semua titik berbobot sama (prediksi = rata-rata global). Tidak berguna untuk interpolasi.powerkecil → permukaan halus, titik-titik jauh masih berpengaruh.powerbesar → permukaan “bergerigi”, pengaruh sangat terlokalisir di sekitar titik sampel (muncul efek bulls-eye).
Kita akan mengeksplorasi dampak power ini secara visual di bagian eksperimen.
Data Meuse: “Bahan Bakar” Analisis Kita
Daripada menggunakan data fiktif, kita akan memakai dataset Meuse — dataset klasik dalam dunia geostatistik yang berisi 155 titik sampel konsentrasi logam berat di dataran banjir Sungai Meuse, Belanda. Dataset ini ideal untuk tujuan kita karena:
- Ukurannya moderat (cukup untuk analisis, tidak membebani komputasi).
- Memiliki struktur spasial yang jelas — nilai tinggi cenderung mengelompok di dekat sungai.
- Tersedia gratis lewat package
scikit-gstat.
Kita akan memuatnya, memahami strukturnya, dan memvisualisasikan sebaran nilainya sebelum mulai melakukan interpolasi.
Shape: (155, 3)
Kolom: ['x', 'y', 'zinc']| x | y | zinc | |
|---|---|---|---|
| 0 | 181072 | 333611 | 1022 |
| 1 | 181025 | 333558 | 1141 |
| 2 | 181165 | 333537 | 640 |
| 3 | 181298 | 333484 | 257 |
| 4 | 181307 | 333330 | 269 |
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 155 entries, 0 to 154
Data columns (total 3 columns):
 #   Column  Non-Null Count  Dtype
---  ------  --------------  -----
 0   x       155 non-null    int64
 1   y       155 non-null    int64
 2   zinc    155 non-null    int64
dtypes: int64(3)
memory usage: 3.8 KB| x | y | zinc | |
|---|---|---|---|
| count | 155.000000 | 155.000000 | 155.000000 |
| mean | 180004.600000 | 331634.935484 | 469.716129 |
| std | 746.039775 | 1047.746801 | 367.073788 |
| min | 178605.000000 | 329714.000000 | 113.000000 |
| 25% | 179371.000000 | 330762.000000 | 198.000000 |
| 50% | 179991.000000 | 331633.000000 | 326.000000 |
| 75% | 180629.500000 | 332463.000000 | 674.500000 |
| max | 181390.000000 | 333611.000000 | 1839.000000 |
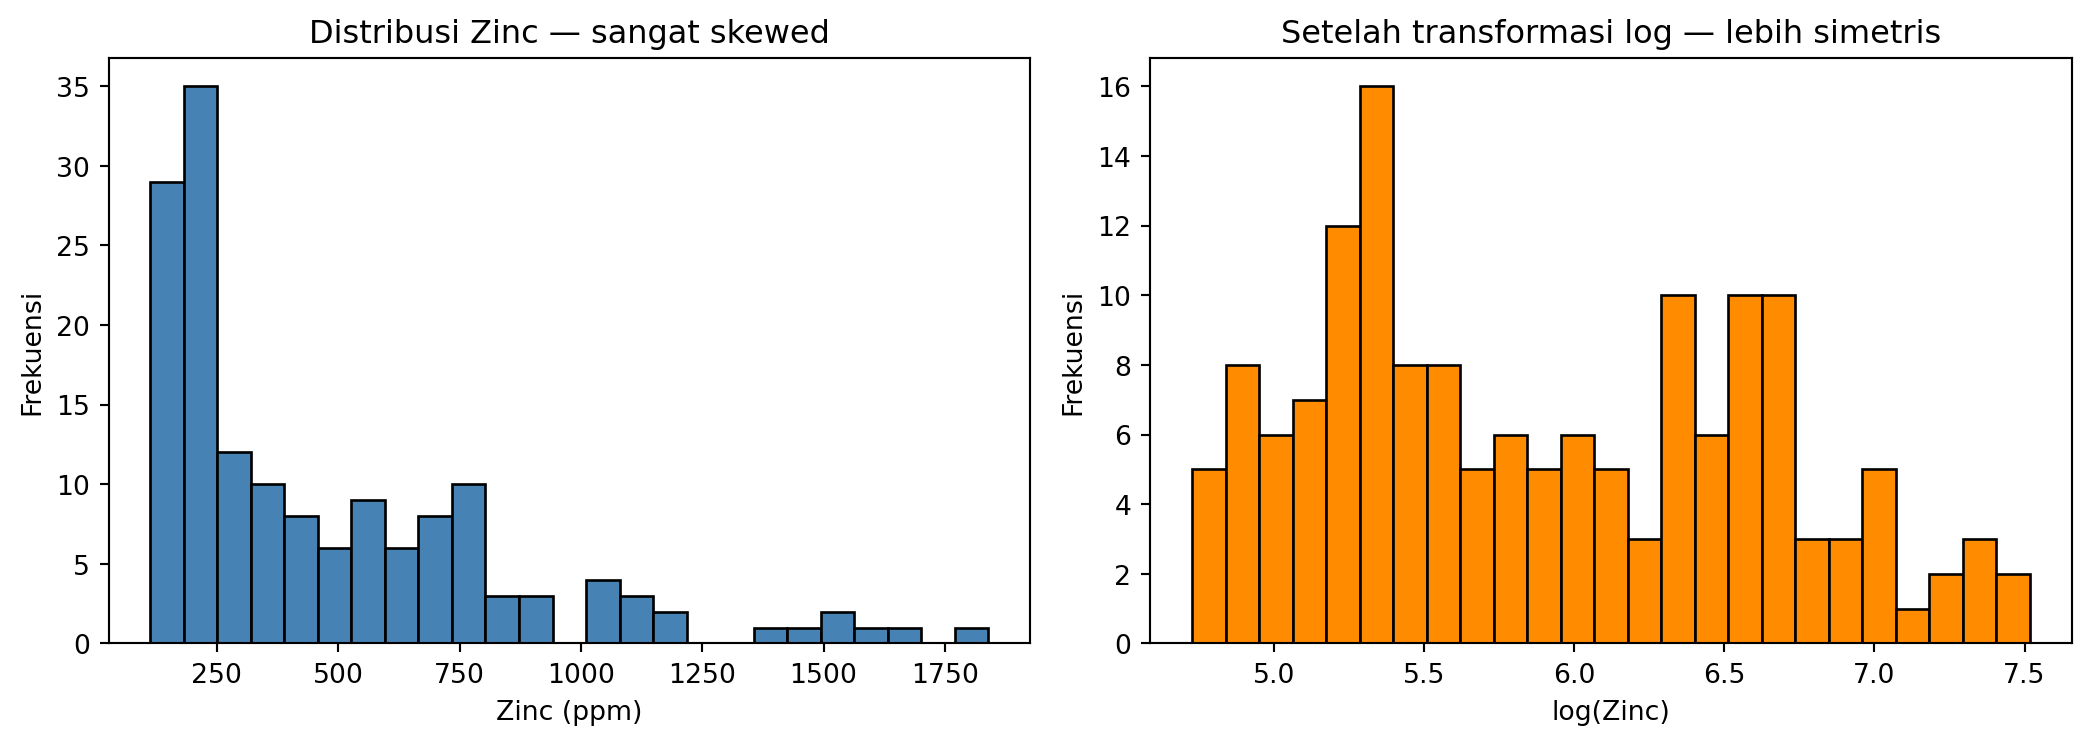
Skewness zinc       : 1.49
Skewness log(zinc)  : 0.33
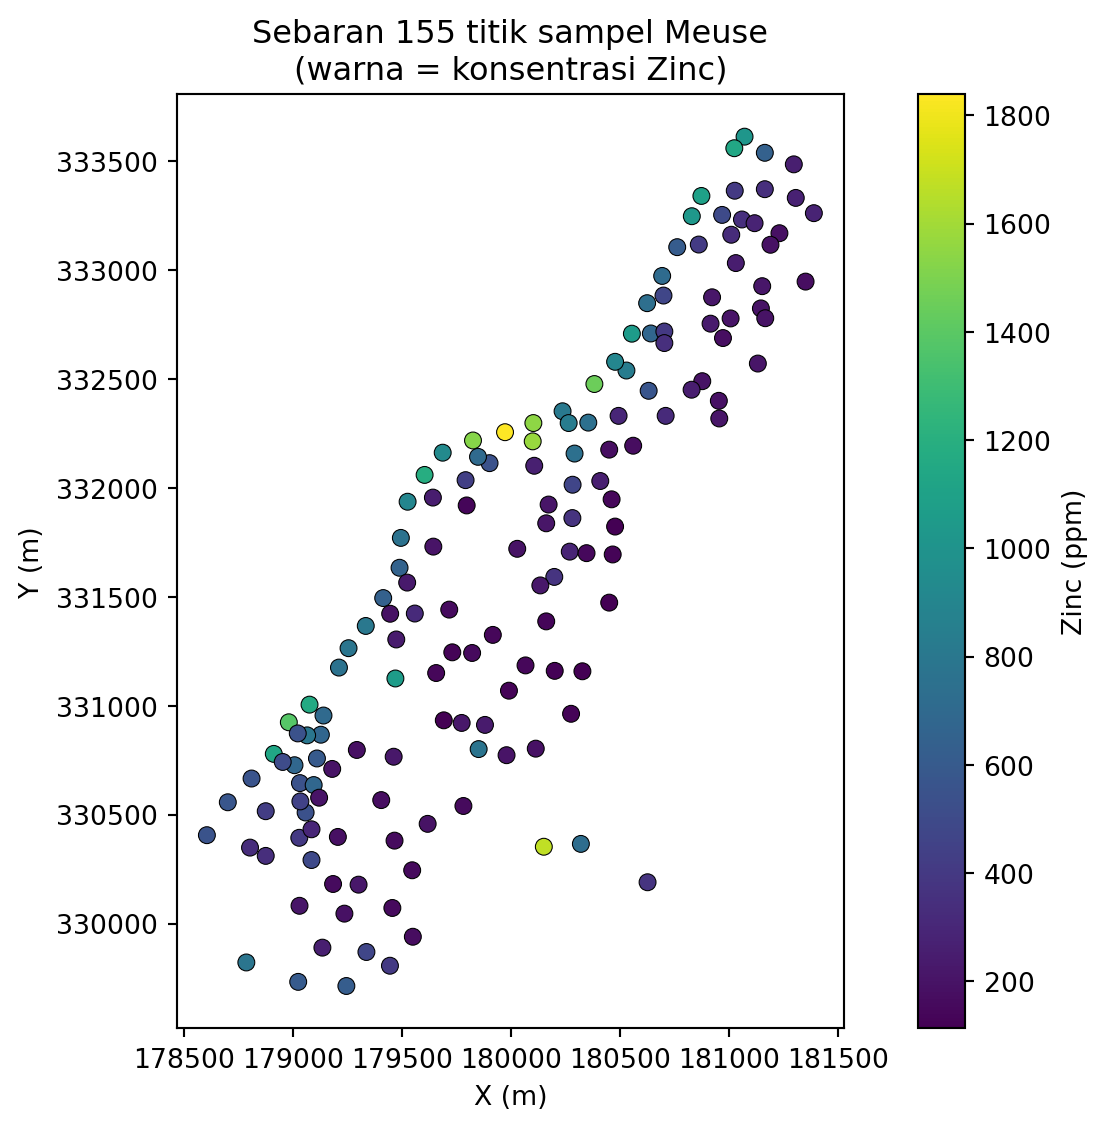
Dua hal penting dari eksplorasi ini:
- Distribusi zinc sangat skewed — nilai ekstrem menarik rata-rata jauh ke kanan. Ini adalah alasan mengapa banyak praktisi melakukan transformasi log sebelum interpolasi. Kita tidak akan melakukan transformasi di artikel ini agar perbandingan IDW vs Kriging di artikel berikutnya adil, tapi ini poin yang akan kita ingat.
- Sebaran titik tidak uniform — mereka mengelompok di dekat sungai. Ini akan menjadi foreshadowing untuk kelemahan IDW: di area dengan titik rapat, IDW bisa menghasilkan artefak “bulls-eye” yang tidak mencerminkan kondisi sebenarnya.
IDW from Scratch — Tanpa Library Interpolasi
Sebelum menggunakan library siap pakai, kita akan membangun IDW dari nol. Alasannya bukan karena kita anti-library, tapi karena dengan menulis setiap langkah sendiri, kita benar-benar memahami apa yang terjadi di dalamnya — dan itu akan sangat membantu ketika kita beralih ke Kriging nanti, di mana “kotak hitam”-nya lebih pekat.
Fungsi di bawah menerima titik-titik sampel dan grid target, lalu mengembalikan permukaan interpolasi. Kita membuatnya fully vectorized dengan NumPy agar cepat, dan menangani kasus khusus di mana lokasi target tepat berimpit dengan lokasi sampel (jarak = 0).
Sanity check (harus 15.0): 15.00Sanity check di atas memverifikasi bahwa ketika titik target berada tepat di tengah dua sampel dengan bobot simetris, hasilnya adalah rata-rata keduanya — persis seperti yang kita harapkan.
Sekarang kita siapkan grid target di atas bounding box data, lalu jalankan IDW dengan power = 2 (nilai default yang paling umum).
Bentuk permukaan : (200, 200)
Nilai minimum    : 114.24
Nilai maksimum   : 1822.96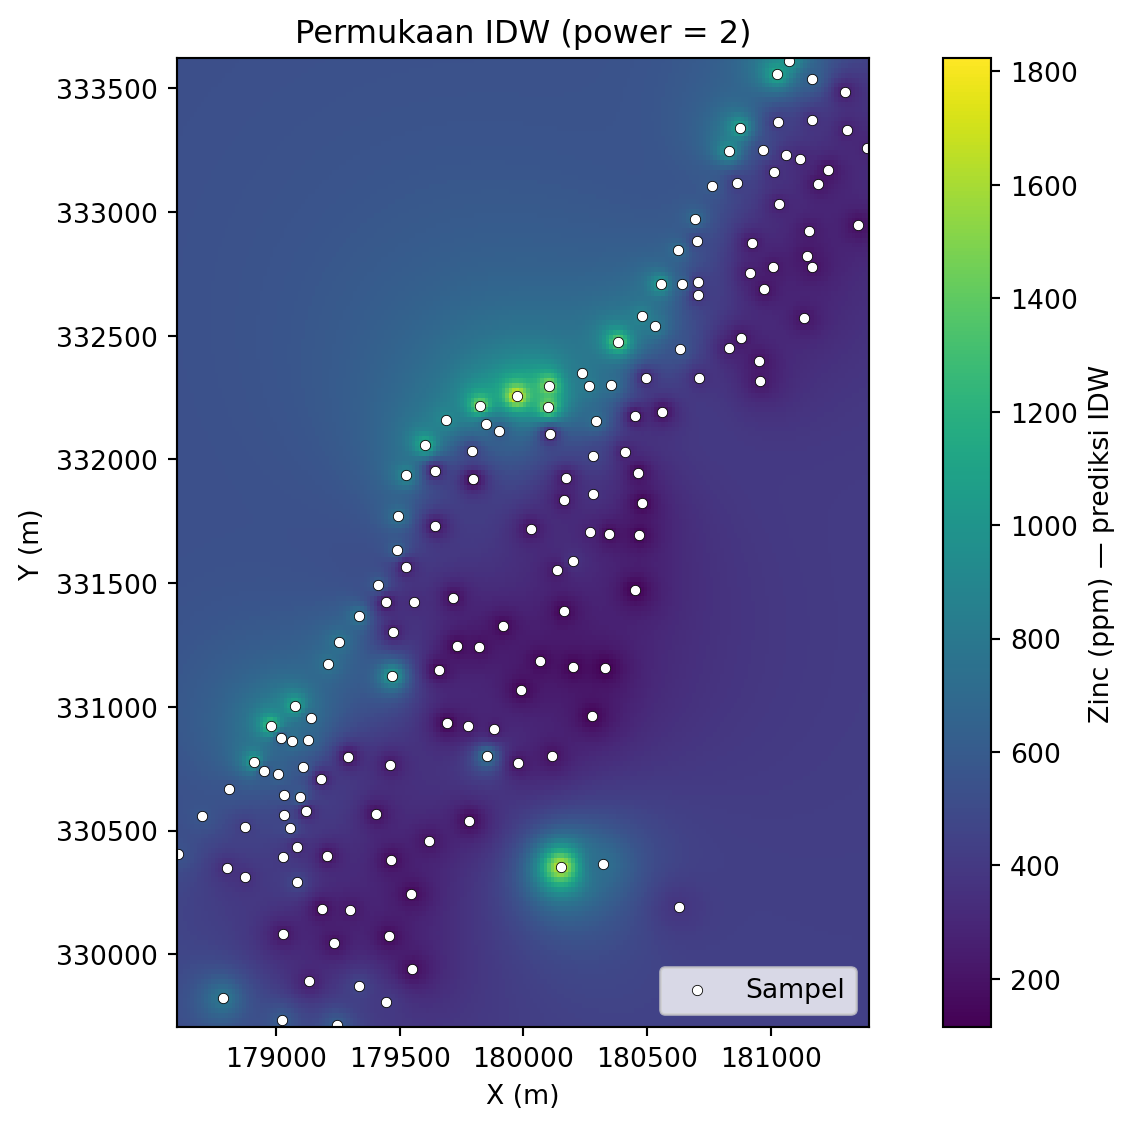
Perhatikan dua hal pada hasil di atas:
- Pola “bulls-eye” yang jelas di sekitar titik-titik sampel — nilai ekstrem “memancar” ke luar secara melingkar. Ini adalah ciri khas IDW dan sering dianggap artefak yang tidak diinginkan.
- Di area tanpa sampel (misalnya sudut-sudut peta), nilai cenderung mendekati rata-rata global karena semua sampel memberi kontribusi yang hampir sama rata.
Sekarang mari kita lihat bagaimana mengubah power mengubah karakter permukaan ini.
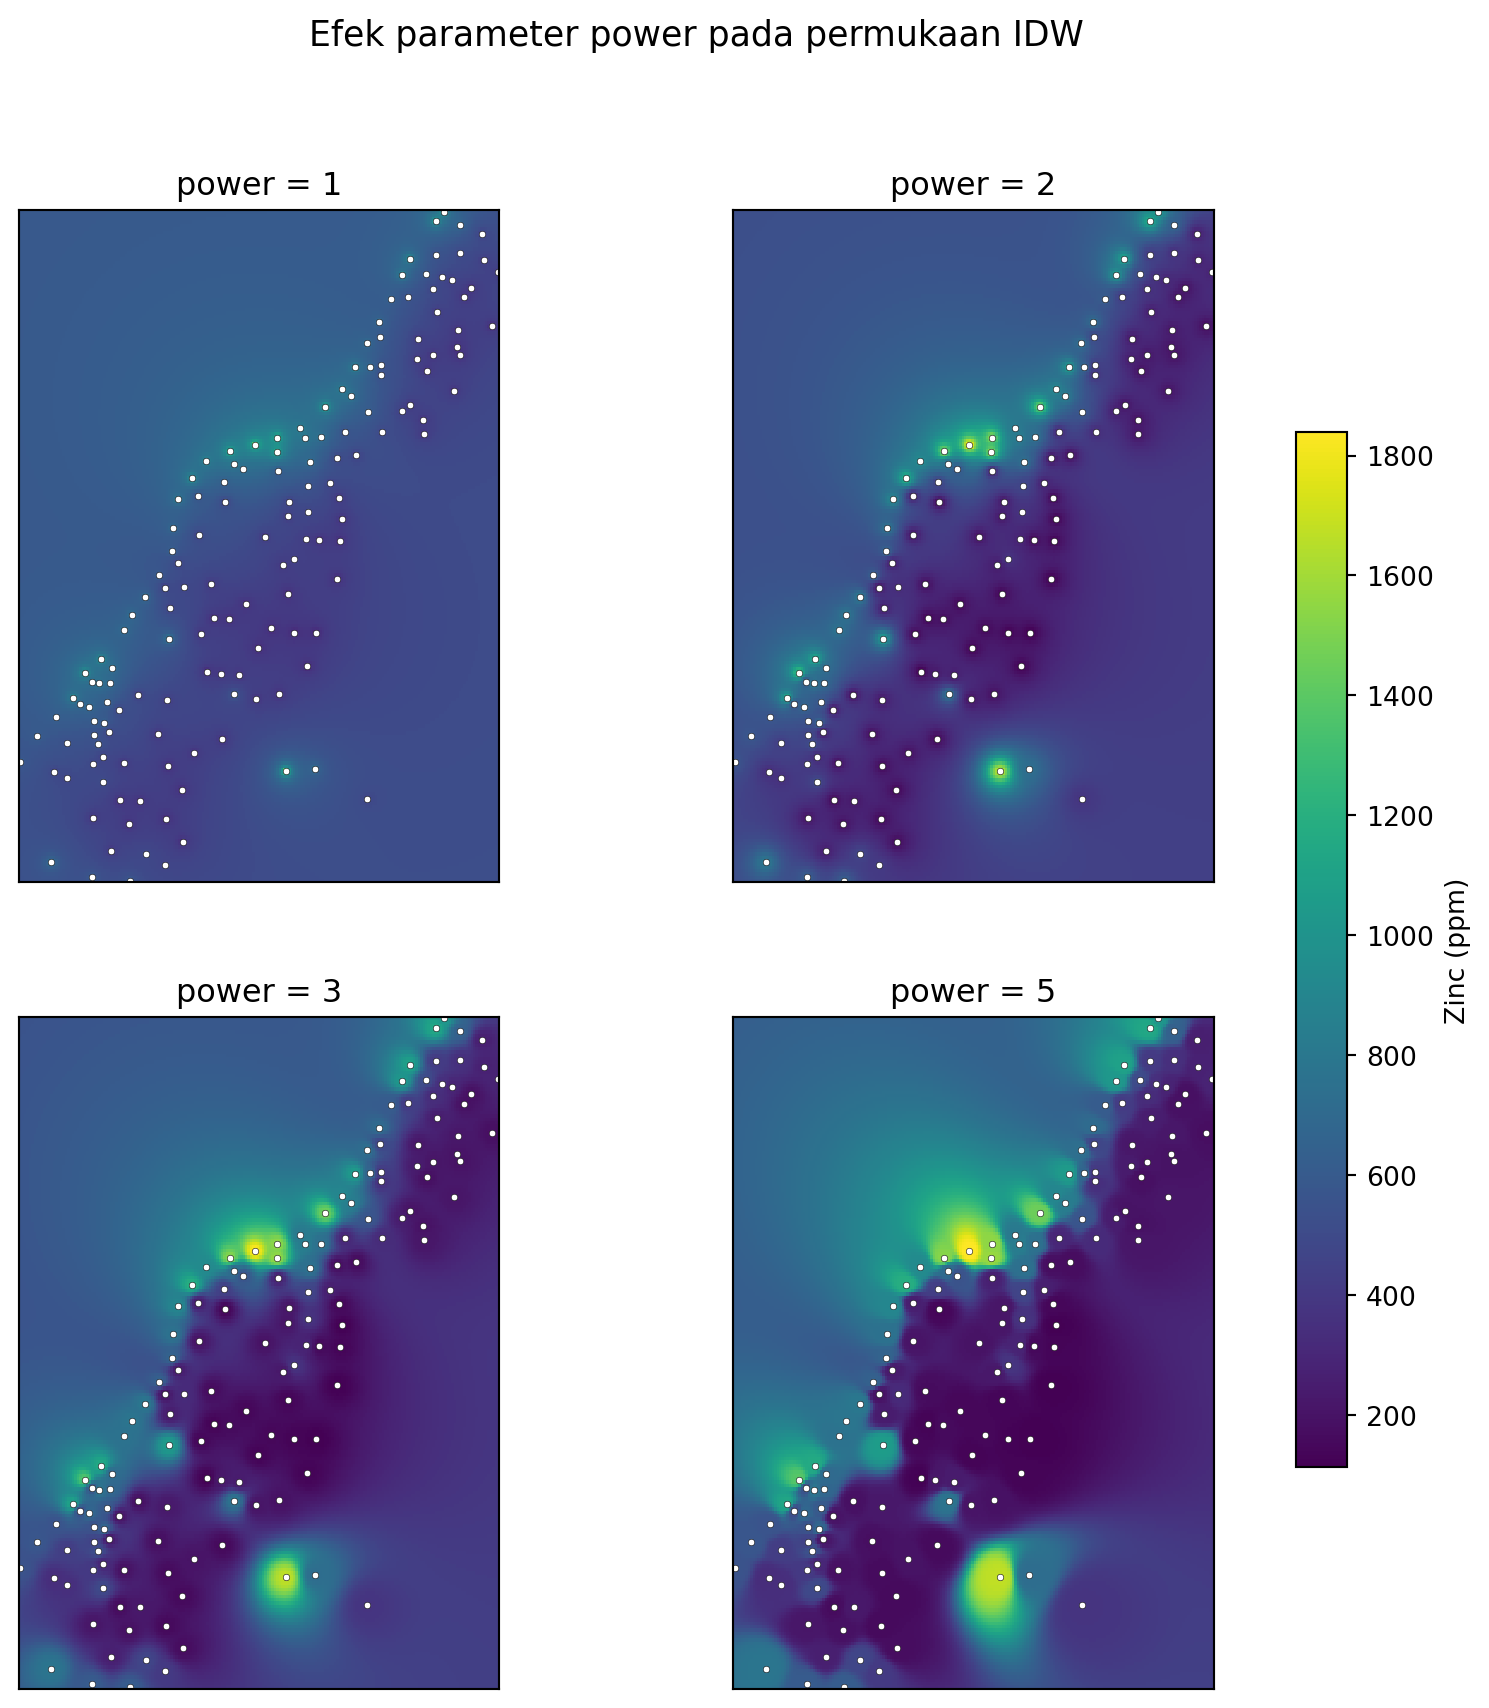
Dari empat panel di atas, kita bisa menarik beberapa kesimpulan:
power = 1→ permukaan paling halus. Titik-titik yang jauh masih memberi kontribusi signifikan, sehingga gradien nilai lebih merata.power = 2→ keseimbangan yang wajar antara kelancaran dan detail lokal. Ini adalah default yang paling sering digunakan di literatur.power = 3→ pengaruh makin terlokalisir. Pola bulls-eye makin terlihat.power = 5→ ekstrem. Setiap titik sampel “menguasai” wilayah kecil di sekitarnya, dan di antara titik-titik tersebut permukaan hampir “datar”. Detail yang sebenarnya mungkin ada di antara sampel menjadi hilang.
Pelajaran pentingnya: power bukan parameter yang bisa dipilih sembarangan. Nilai yang “benar” bergantung pada sifat data dan tujuan analisis. Salah satu cara memilihnya secara objektif adalah dengan cross-validation — dan itulah yang akan kita lakukan di bagian berikutnya.
Memilih power secara Objektif: Cross-Validation
Di bagian sebelumnya kita melihat bahwa power mengubah karakter permukaan interpolasi secara dramatis. Pertanyaannya: nilai mana yang “benar”?
Jawaban jujur: tidak ada nilai yang universal benar. Nilai optimal bergantung pada data. Tapi kita bisa memilihnya secara objektif dengan teknik cross-validation — khususnya Leave-One-Out Cross-Validation (LOOCV).
Ide LOOCV
Prosedurnya sangat intuitif:
- Sembunyikan satu titik sampel dari dataset.
- Latih model IDW menggunakan sisa \(n-1\) titik.
- Prediksi nilai titik yang disembunyikan tersebut.
- Hitung error: \(e_i = z_i - \hat{z}_i\).
- Ulangi untuk semua \(n\) titik.
- Ringkas error menjadi metrik tunggal — biasanya RMSE (Root Mean Squared Error).
RMSE yang lebih kecil → model lebih akurat dalam memprediksi nilai yang belum pernah dilihatnya. Kita melakukan ini untuk beberapa nilai power, lalu memilih yang RMSE-nya terkecil.
Kelebihan LOOCV: menggunakan seluruh data untuk training (karena kita hanya menyembunyikan satu titik), dan tidak memerlukan pembagian train/test yang bisa subjektif. Kekurangannya: biaya komputasi \(O(n^2)\) jika diimplementasikan naif — untuk \(n = 155\) ini masih sangat ringan.
Implementasi LOOCV
Kuncinya adalah memanfaatkan fungsi idw kita sendiri, tapi kali ini dipanggil berkali-kali dengan subset data yang berbeda. Supaya cepat, kita tulis versi yang lebih efisien: untuk setiap titik \(i\), kita mengecualikan kolom ke-\(i\) dari matriks jarak.
| power | RMSE | MAE | |
|---|---|---|---|
| 0 | 0.5 | 355.72 | 279.49 |
| 1 | 1.0 | 332.65 | 258.50 |
| 2 | 1.5 | 303.46 | 231.03 |
| 3 | 2.0 | 278.27 | 204.44 |
| 4 | 2.5 | 263.16 | 187.46 |
| 5 | 3.0 | 257.55 | 176.96 |
| 6 | 4.0 | 260.42 | 170.57 |
| 7 | 5.0 | 266.98 | 170.21 |
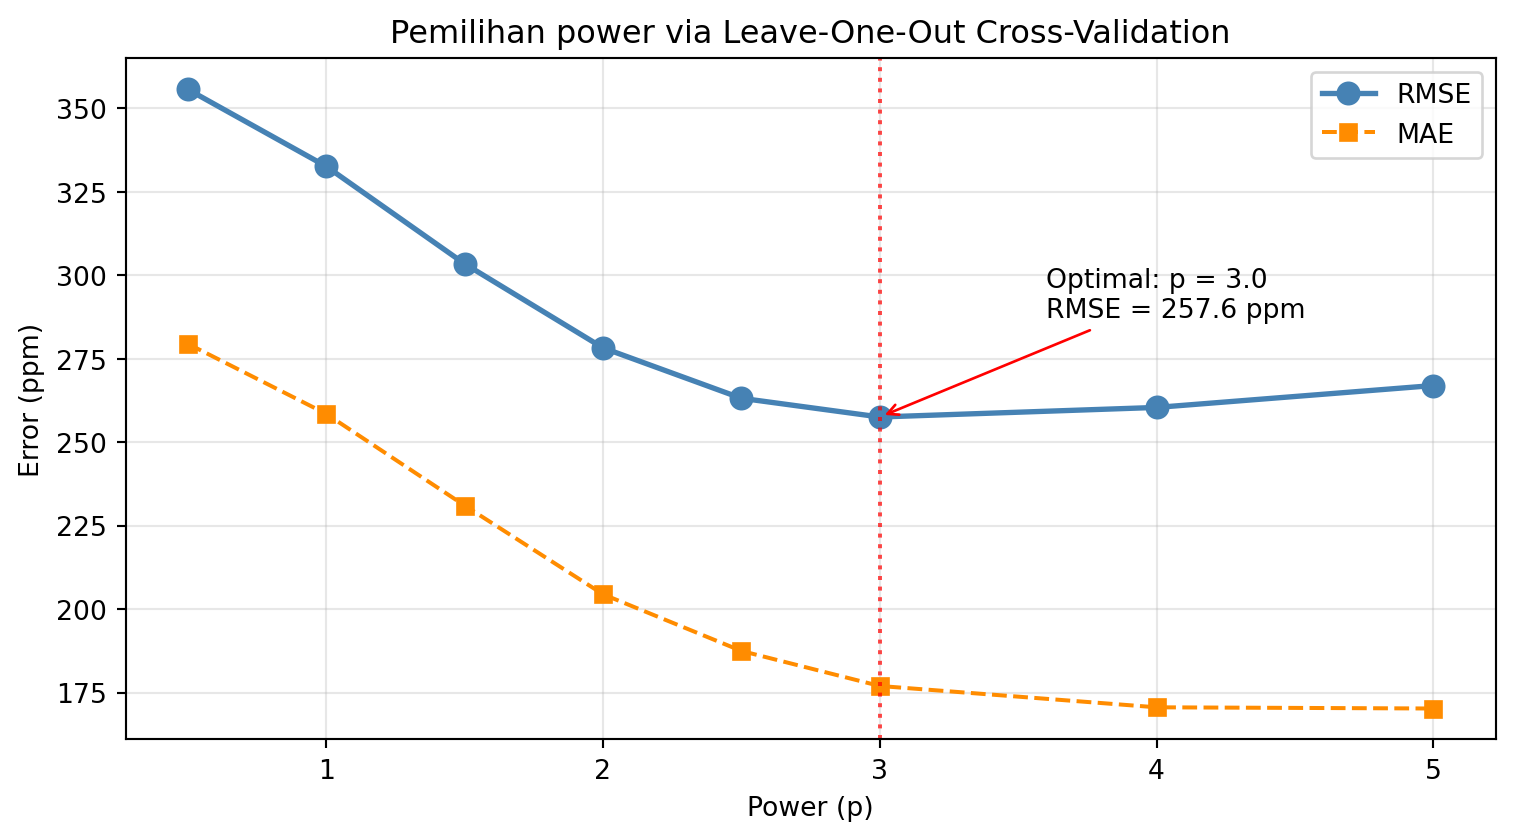
Power optimal (RMSE minimum): 3.0
RMSE terbaik                : 257.55 ppm
Kurva di atas biasanya menunjukkan pola yang khas:
- RMSE turun dari
powerrendah kepowermenengah (di sekitar 2–3), artinya pengaruh jarak yang lebih “tegas” memang membantu memprediksi nilai yang belum dilihat. - Setelah mencapai titik minimum, RMSE naik kembali untuk
poweryang sangat besar — karena permukaan menjadi terlalu “bergerigi” dan model menjadi overfit terhadap titik sampel, kehilangan kemampuan generalisasi. - Nilai optimal di sekitar
p = 2sering muncul, yang menjelaskan mengapapower = 2menjadi default di banyak implementasi IDW.
Penting dicatat: angka RMSE ini bersifat spesifik untuk dataset Meuse dan variabel zinc. Untuk dataset lain, kurva dan nilai optimalnya bisa sangat berbeda — dan itulah mengapa LOOCV penting dilakukan setiap kali, alih-alih memakai default tanpa berpikir.
Sekarang mari kita visualisasikan permukaan dengan power optimal, dan bandingkan dengan implementasi library siap pakai.
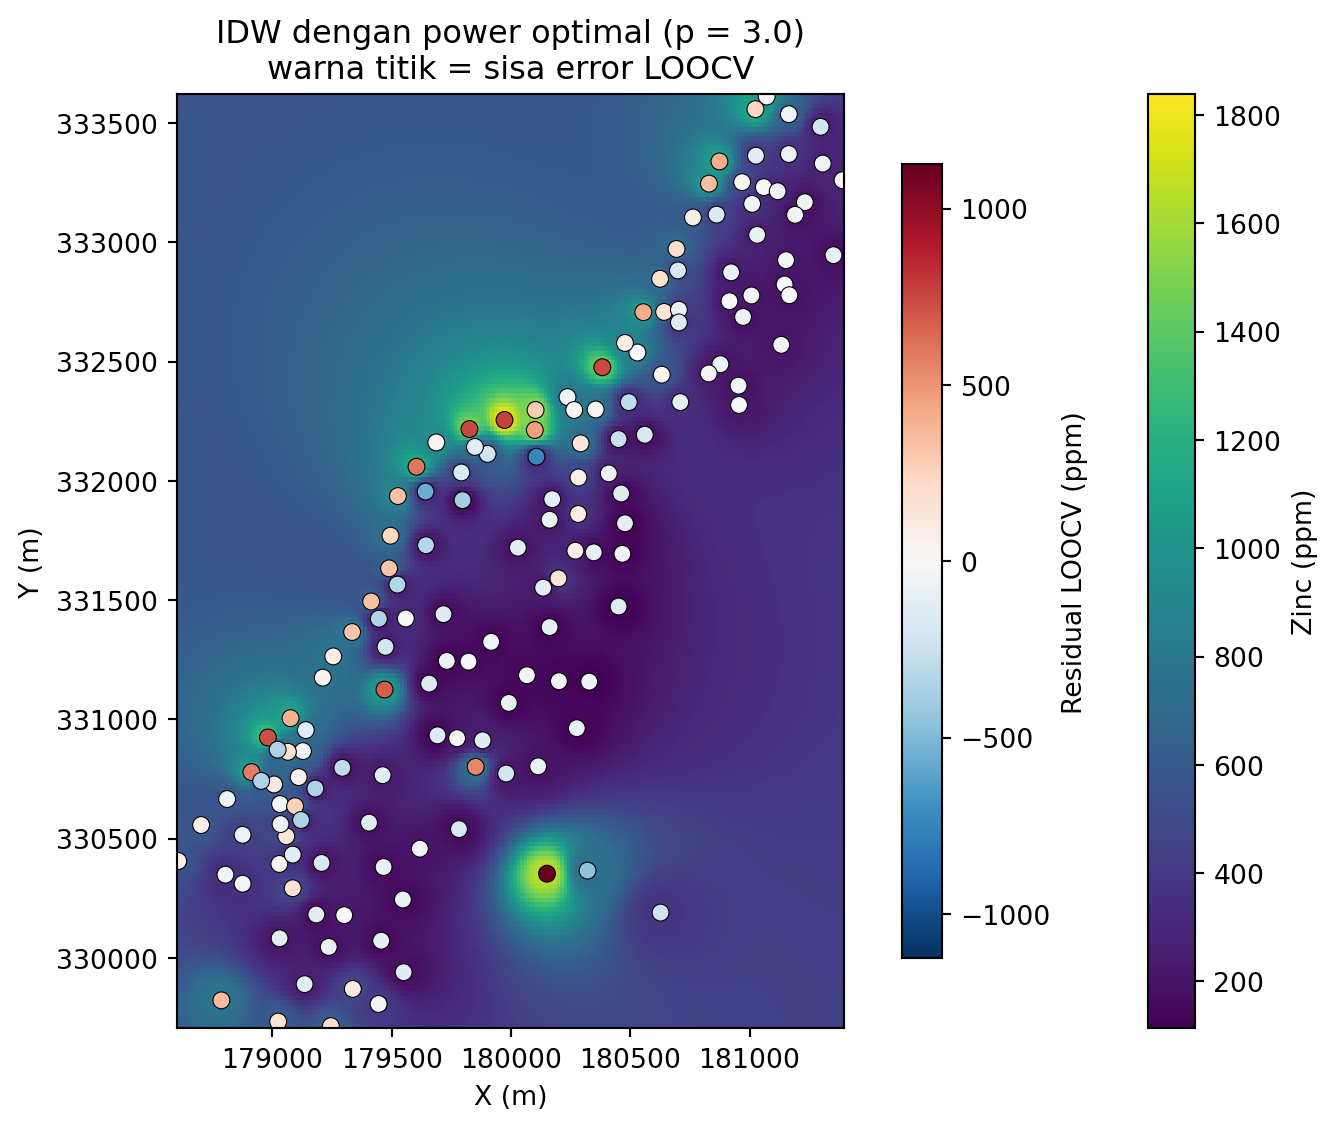
Plot residual ini memberikan informasi yang sangat berharga: di mana IDW gagal? Warna merah/biru menandakan titik-titik yang prediksinya paling menyimpang dari nilai aktual. Jika Anda perhatikan, residual cenderung besar di area yang jarang sampelnya atau di dekat nilai ekstrem — dua kondisi di mana IDW memang dikenal lemah.
Ini adalah petunjuk penting: IDW mengasumsikan bahwa jarak adalah satu-satunya penentu kemiripan nilai. Padahal di dunia nyata, dua titik yang berdekatan bisa saja punya nilai sangat berbeda (misalnya karena ada batas geologis di antara keduanya). Kriging akan mencoba memodelkan struktur ini secara eksplisit — dan itulah yang akan kita bahas di artikel berikutnya.
Verifikasi dengan Implementasi Library
Apakah implementasi from scratch kita benar? Cara terbaik untuk memverifikasinya adalah membandingkan hasilnya dengan library yang sudah mapan. Kita akan gunakan scipy.spatial.cKDTree untuk perhitungan jarak yang lebih cepat, lalu terapkan formula IDW yang sama — hasilnya harus identik dengan fungsi kita (dalam batas presisi numerik).
Sebagai cross-check, kita juga bisa membandingkan dengan pyinterpolate atau wradlib, tapi cukup satu verifikasi yang kuat sudah memadai untuk tujuan artikel ini.
Perbedaan maksimum : 1.36e-12
Perbedaan rata-rata: 7.87e-14
→ Kedua implementasi identik (dalam batas presisi floating point).
Verifikasi berhasil. Ini mengonfirmasi bahwa fungsi idw kita tidak hanya “terlihat benar” secara intuitif, tapi juga konsisten secara numerik dengan implementasi berbasis struktur data spasial yang sudah teruji.
Perlu dicatat: cKDTree jauh lebih cepat untuk k kecil (misalnya k=8 atau k=16, yaitu hanya memakai k tetangga terdekat), dan strategi k-nearest neighbors ini sering dipakai di produksi untuk dataset besar. Untuk dataset Meuse yang hanya berisi 155 titik, perbedaannya tidak signifikan — tapi untuk jutaan titik, memilih k yang tepat bisa menjadi penghematan komputasi yang besar.
Kekuatan dan Kelemahan IDW
Sekarang kita sudah membangun IDW dari nol, bereksperimen dengan parameternya, memilih power secara objektif, dan memverifikasi implementasinya. Saatnya merangkum kapan metode ini tepat digunakan — dan kapan tidak.
Kekuatan IDW
- Sederhana dan transparan. Hanya ada satu parameter (
power) yang perlu dipilih, dan efeknya mudah dipahami secara visual. - Cepat. Bahkan implementasi naif dengan NumPy vectorized sudah cukup untuk dataset berisi ribuan titik; dengan
cKDTreeataukterbatas, IDW bisa diskalakan ke jutaan titik. - Tidak memerlukan asumsi statistik. Tidak perlu memodelkan autokorelasi, tidak perlu fitting variogram, tidak ada asumsi Gaussian.
- Robust untuk eksplorasi cepat. Ketika Anda butuh first look pada data spasial dan tidak punya waktu membangun model geostatistik, IDW adalah pilihan tepat.
Kelemahan IDW
- Artefak bulls-eye. Nilai ekstrem “memancar” melingkar di sekitar titik sampel, menciptakan pola yang tidak selalu mencerminkan kondisi sebenarnya.
- Tidak ada estimasi ketidakpastian. IDW hanya memberi prediksi titik. Tidak ada informasi tentang seberapa yakin model terhadap prediksi tersebut — padahal di banyak aplikasi (misalnya pemetaan risiko), informasi ini sama pentingnya dengan prediksi itu sendiri.
- Asumsi jarak yang terlalu sederhana. IDW menganggap pengaruh spasial bersifat isotropik (sama ke segala arah) dan hanya bergantung pada jarak. Padahal di dunia nyata, struktur spasial sering memiliki arah preferensial (misalnya aliran sungai, arah angin, atau formasi geologis).
- Sensitif terhadap outlier. Karena bobot berbasis jarak saja, satu nilai ekstrem bisa “mencemari” area yang cukup luas di sekitarnya.
- Tidak memanfaatkan struktur data. Informasi berharga tentang bagaimana nilai berubah seiring jarak — yang bisa diukur dari data itu sendiri — sama sekali tidak digunakan.
Jembatan ke Kriging
Kelemahan-kelemahan di atas adalah alasan mengapa Kriging ada. Kriging memperbaiki sebagian besar kelemahan IDW dengan pendekatan yang fundamental berbeda:
| Aspek | IDW | Kriging |
|---|---|---|
| Bobot | Fungsi deterministik dari jarak | Dioptimalkan berdasarkan struktur korelasi data (semivariogram) |
| Arah | Isotopik (sama ke segala arah) | Bisa anisotropik (memperhitungkan arah) |
| Ketidakpastian | Tidak ada | Ada (kriging variance) |
| Asumsi | Hanya jarak | Model variogram yang di-fit dari data |
| Kompleksitas | Rendah | Tinggi |
Di artikel berikutnya, kita akan:
- Memahami konsep semivariogram — “sidik jari” autokorelasi spasial dari data.
- Melakukan Kriging pada dataset Meuse yang sama, agar perbandingan dengan IDW bersifat apples-to-apples.
- Membandingkan RMSE LOOCV kedua metode secara langsung.
- Memetakan kriging variance — sesuatu yang tidak bisa diberikan IDW.
Dengan pemahaman IDW yang sudah kita bangun di artikel ini, Anda akan melihat bahwa Kriging bukanlah “sihir”, melainkan evolusi alami dari ide-ide yang sudah kita mulai di sini: prediksi berbobot, tapi dengan bobot yang dipelajari dari data, bukan diasumsikan.